硅谷的AI巨头们终于发现,把代码变成救命药,最大的敌人不是算力不够,而是实验猴不够用了。
Twist Bioscience 预计其AI相关订单在2026和2027财年将连续实现三位数暴增;金斯瑞(GenScript)的AI制药业务上半年直接翻倍,日均验证产能正从4000个一路飙升至年底的16000个。
熟悉半导体交易的朋友对这个戏码绝不陌生:GPU不够抢GPU,GPU够了抢HBM,显存够了抢光模块,最后发现全网都在抢变压器和电网。如今,这套“瓶颈转移交易”完美复制到了AI制药(AIDD)领域。
算法几秒钟就能生成上万个新蛋白序列,但生物学不相信纯数字。DNA合成、蛋白表达、高通量筛选、临床前毒理——每一个环节都在被暴涨的实验需求挤爆。
更深层的变化在于:AI不仅需要成功案例,它更饿极了要吃“失败数据”。
此前 Anthropic 用 Claude 设计了1320个蛋白结合体,送到湿实验室实测,最终只有354个成功结合。搁在传统制药时代,那966个失败品就是打水漂的几百万美金;但在AI时代,这966个失败品是极其宝贵的“负面训练标签”。
这导致DNA和蛋白合成机构直接升级成了硅谷算法的“生物数据工厂”。传统制药问“这个分子能不能成药”,AI制药问“这个实验能给模型喂多少有效数据”。
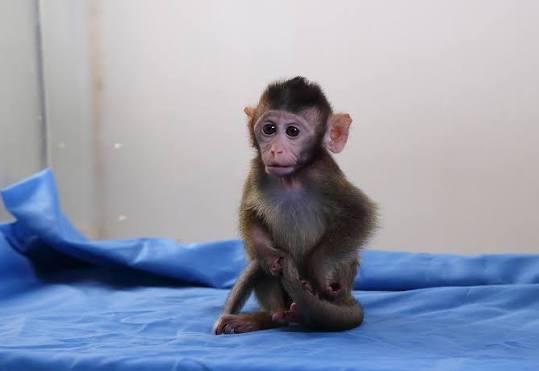
当合成产能被拼命拉满后,产业链的下一个挤压点已经非常明确:临床前动物实验。
目前实验猴的价格已重回历史高位,CRO(合同研究组织)的产能日趋紧张。在全球每年3000亿至4000亿美元的庞大研发预算支撑下,算法画饼的速度,已经远远超越了灵长类动物的繁殖周期。
有人质疑:“哪怕筛选再快,后端的二三期临床试验依然需要几年时间,瓶颈根本没变。”
但这种声音忽略了一件事——在2028到2030年AI设计药物迎来真正的临床二三期考验之前,所有处于“卡脖子”位置的上游卖铲人,订单早就排到了几年之后。
碳基生物的生理极限,成了硅谷算力最难逾越的一道墙。但在算法彻底打破这道墙之前,那些在实验室里日夜不停合成基因、测序数据、给实验猴打针的企业,早已在这场硅谷造神运动里赚得盆满钵满。