苹果在 Hugging Face 上悄悄丢了一个开源模型重磅炸弹!它居然是基于阿里通义千问(Qwen3.5)精调出来的!
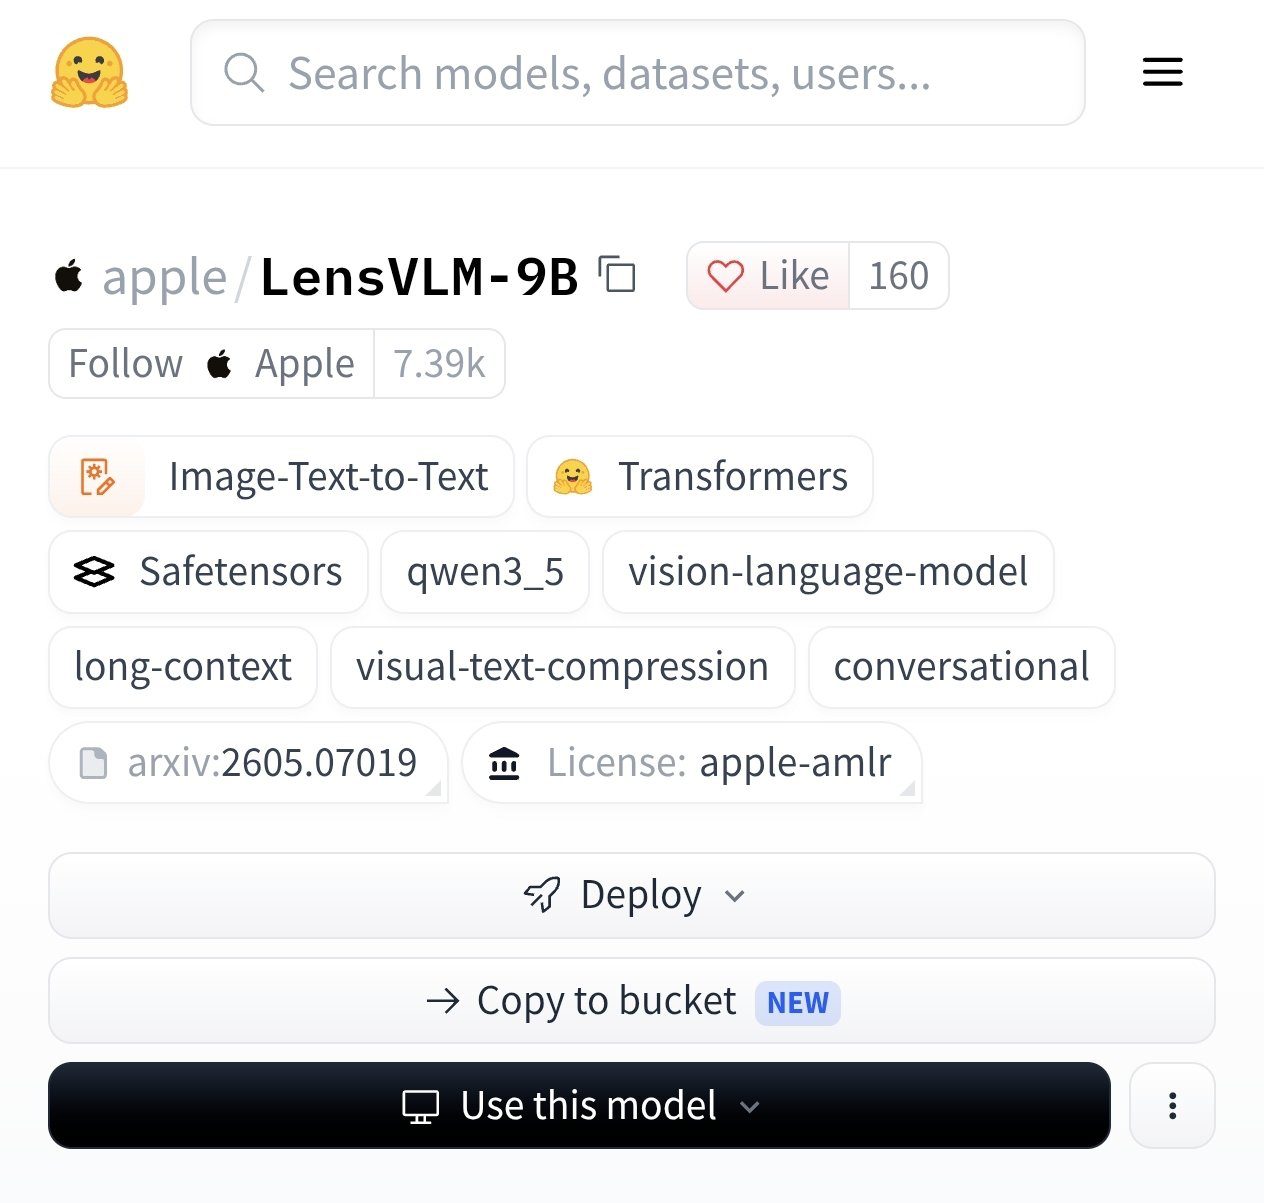
全网都在等 Siri 变聪明,结果库克背地里领着苹果研究团队,默默在开源社区发了一个叫 LensVLM-9B 的视觉语言模型。点开项目页面看一眼配置,标签里赫然写着基于 Qwen3.5-9B 微调。不得不说,这波“果味开源”带着一种极其微妙的幽默感:硅谷市值霸主,也开始拿开源大模型当底层砖头用了。
但抛开调侃,苹果这次解决的技术痛点,确实刀刀切在行业最肉疼的算力账本上。
现在大家用大模型读长文档或者 PDF,最大的噩梦就是“贵”和“慢”。一本上百页的财报或法律合同,带上表格和图表,直接扔进传统视觉大模型里,分分钟把几万个 Token 吃得干净,显存占用居高不下。
苹果这次搞出了一套极其聪明且“抠门”的技术:视觉缩略图 + 选择性定向展开。
简单来说,它把大模型训练得像一个精明的审计员。面对一份百页的大文档,它绝不傻乎乎地把每一页都用 4K 极清分辨率硬吞进去。第一步,模型先把所有页面压缩成极其微小的“视觉缩略图”。这一步极度节省 Token,相当于给整本书快速翻页扫了一眼。
第二步,模型用极低的算力成本扫视完这些缩略图后,精准定位到哪几页跟你的提问真正相关,最后才单独把那几页进行“高分辨率无损还原”,提取细节回答问题。
根据苹果公开的论文数据,这种“低清全局扫视,高清局部展开”的操作,在处理 100 页超长文档时,整整把 Token 消耗砍掉了 84%!更夸张的是显存(KV Cache)占用,直接从 1.6GB 暴跌到了 250MB。
把“环保省钱”的苹果传统艺能用到 AI 算力上,这波操作可以说是把成本控制玩到了极致。
以往硅谷巨头比拼多模态,卷的都是谁的上下文窗口更长、谁能一口气吃下更多高码率图片。结果苹果反其道而行之:不比谁能吃,只比谁省钱。而且苹果这次诚意十足,不仅放了论文,连模型权重(apple/LensVLM-9B)和推理代码都用 apple-amlr 协议公开发布了。
以前大家开玩笑说 Siri 不够聪明是技术问题,现在看明白了,苹果这是账本算得太精。用业界顶尖的国产开源基座做底,配上自家绝活级别的压缩算法,把长文档视觉解析的成本打到了原先的两成。
当最会赚钱的硬件巨头开始在算力 Token 上精打细算,甚至反向接入开源生态,商业大模型原本高不可攀的技术壁垒,恐怕真的要被重新洗牌了。
热点观点畅聊会