这次轮到中国“定规矩”了。
9月16日,中国移动干了一件大事,正式宣布向全球开源了Open-RAIL,这是行业内第一个把VLA/WAM模型和机器人本体连接起来的通用工程底座。
简单来说就是,以前给机器人装上大模型大脑,不代表它就能干活,不同品牌的机器人关节定义不同、通信协议不同,换一台新机器就得重新写代码,从“以周计”往下压。
先搞清楚一个行业现状,现在做机器人研究的团队,手里拿到一个很聪明的模型,想让它去操控一台真实的机器人,中间要填的坑多得吓人。
不同品牌的机器人,关节怎么定义、通信走什么协议、坐标系朝哪个方向,全都是各家说了算。你花了好几周时间终于把模型跑通了一台机器,换一个型号,对不起,前面干的全得推倒重来。
有行业报道形容过这个局面,就像一百家手机厂商各自发明了一套充电线,谁也插不进谁的接口。
这个局面造成的浪费是双重的,做模型的人精力耗在写适配代码上,做机器人的人等不到能直接跑起来的算法。
更隐蔽的问题出在数据层,过去推理归推理,数采归数采,两条线各走各的。机器跑完一轮,还得手动整理图片、对齐时间戳、转换格式,从采集到真正能用上,周期往往以周计算。数据明明就在那里,却白白沉睡着。
Open-RAIL做的,就是在这两个世界之间搭一座桥,它本身不是模型,也不是机器人,而是夹在中间的通用连接层。
中国移动具身智能产业创新中心的思路很直接,在机器人这一侧抽出一层轻量级的硬件抽象层,把控制指令、状态读取和动作执行全部标准化。
新机器人接进来,只要完成底层的适配和注册就行,上层逻辑一行都不用改。模型那边同样定好了接入约定,新模型只要实现标准推理接口就能跑起来。
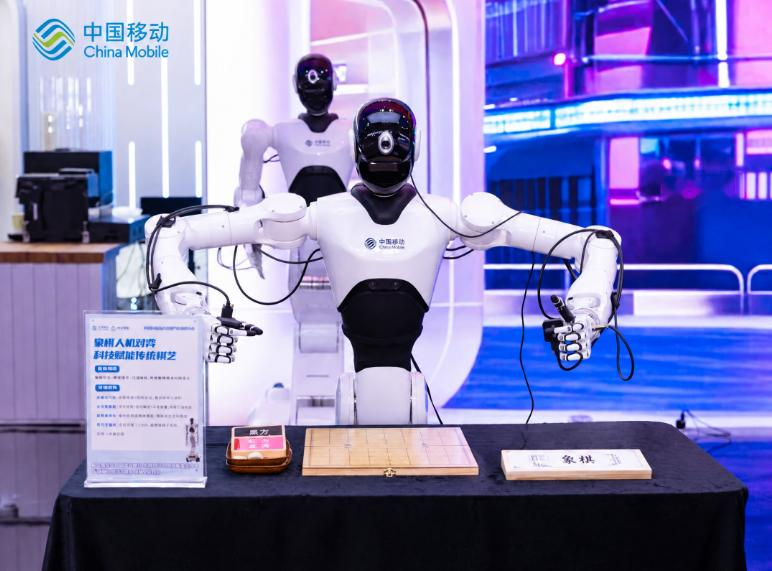
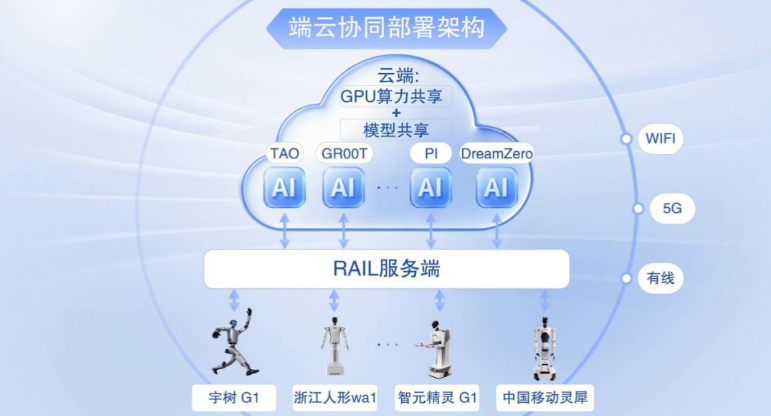
目前已经适配了4款异构机器人,支持10个主流VLA/WAM模型,新机型接入的时间从按周算压缩到了按小时算,新模型接入最低只需要50到100行代码。
但真正让工程师头疼的,是另一个更底层的问题,VLA/WAM模型推理一步动辄要上百毫秒,机器人控制却要求毫秒级的响应速度,两者之间差了30到50倍。模型输出的是一个个离散的动作点,点与点之间没有平滑过渡,落到真机上就是频繁的加减速冲击和抖动。
Open-RAIL在框架层面把观测、推理、控制拆成了三条并行的流水线,各自持续运转互不等待,再配合两级平滑策略在线实时计算。效果是关节加速度标准差从10以上降到了0.1,直接掉了两个数量级。
算力的问题也一并解决了,当前主流模型的参数量从几B到几十B不等,机器人端那些嵌入式设备根本装不下,团队只能退而求其次选小模型,能力被硬件卡住了脖子。
Open-RAIL把推理统一放在服务器端,机器人侧只负责执行和状态上报,服务器放在机器人本体上、放在边缘算力节点上、或者放在云端都行,代码完全一样,改一个连接地址就能切换。端边云怎么部署,团队自己说了算,不用再为了算力牺牲模型能力。
还有一点值得单独说,Open-RAIL把数据采集直接嵌进了每一次推理执行的过程里。多视角图像、关节状态、推理结果、平滑后的指令、时序信息,全部自动归档成标准格式,不需要任何转换就能直接喂进下一轮训练。
它甚至支持推理和遥操作混合的模式,模型跑偏的时候人可以随时介入纠偏,纠偏轨迹和原始轨迹的时间戳严格对齐、并行保存。每一次人工干预,都是一次高质量的定向教学。
把这些能力放在一起看,中国移动想做的事情就清楚了,具身智能这个行业现在最大的问题不是缺少聪明的模型,也不是缺少能动的机器,而是缺一套让两者能顺畅对话的通用规则。
谁先把这层规则定下来,谁就在这个产业从实验室走向工厂和家庭的路上,拿到了一个关键位置。
Open-RAIL开源了,全球的开发者都可以拿去用、拿去改,这套底座的生态能长多大,接下来就看有多少人愿意站上来了。