这回轮到中国来“立规矩”了!
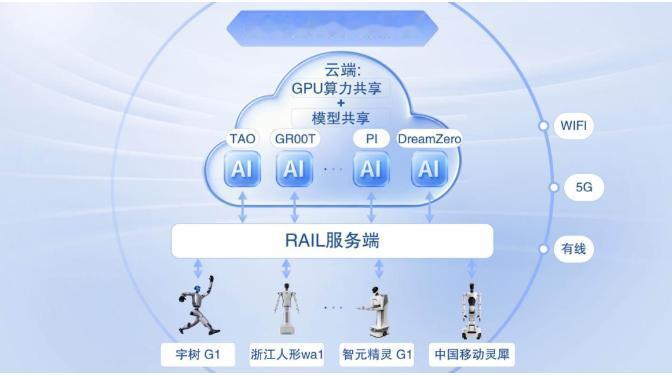
9月16日,中国移动干了一件大事,正式宣布向全球开源了Open-RAIL,这是行业内第一个把VLA/WAM模型和机器人本体连起来的通用工程底座。
这个说白了就是给机器人大脑和手脚搭的“通用插座”。
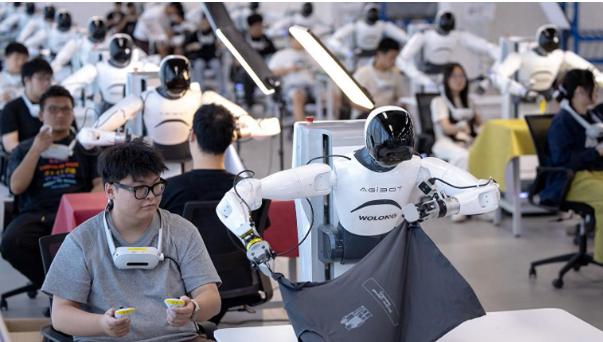
以前搞机器人的人都头疼一件事:你给机器人装了个聪明的大模型大脑,它理论上啥都会说,但真让它动手干活,比如拧个螺丝、端个杯子,就不行了。
为啥?因为不同牌子的机器人,肢体摆动、信号怎么传,规矩都不一样。你辛辛苦苦训练出来的模型,换一台机器人就得从头做一遍接口适配,周期动不动以周计算。
更别提模型推理一步要上百毫秒,而控制端却要求毫秒级响应,两者差了30到50倍,动作卡顿抖动是家常便饭。
现在这个开源底座,就是把这层麻烦事给抹平了。
它到底抹平了多少麻烦?说几个数你就明白了。新机器人接入,以前要折腾好几周,现在压到了小时级;新模型接入,最低只要写50到100行代码。
关节加速度标准差从10以上直接降到0.1,动作平滑度提升了整整2个数量级。翻译成人话就是:以前机器人干活像新手开手动挡,一卡一卡的,现在变成了老司机开自动挡,丝滑得很。
但我觉得比这些数字更有意思的,是中国移动这次出手的时机和方式。
过去2年,全球具身智能的竞争焦点全在模型参数和算法上。谁家VLA模型更强、谁的demo视频更惊艳,谁就占山头。但真正卡住落地的,从来不是大脑不够聪明,而是大脑和身体之间的那根神经是断的。
美国那边,英伟达在搞虚拟训练场,OpenAI在推软硬件全栈,特斯拉拿汽车供应链压成本,各走各的路,没有一个统一的连接层。
中国移动把这层连接开源出来,等于把行业最脏最累但又最绕不开的工程链路一次性打通了。这对中小团队和高校实验室的意义是根本性的:你不再需要花几个月搭管线,拿到底座就能跑真机。
不过话说回来,开源从来不只是技术善意。中国移动已经建了120万条具身智能数据,手里有5G-A网络和边缘算力,这套底座开源出去之后,全球开发者的每一次真机运行,都在往它的生态里回灌数据。
谁掌握了连接标准和数据回流通道,谁就在事实上定义了具身智能的工程接口。这玩的不是一城一池的得失,是在给整个行业修路。路修好了,跑什么车、往哪个方向跑,修路的人话语权最大。
还有一个细节值得注意。Open-RAIL把推理统一放到Server端,机器人本体只负责执行和状态上报。这个Server可以放在机器人身上,也可以放在边缘服务器,还可以直接上云,代码完全不用改,就改一个连接地址就行。
这意味着什么?意味着以后你选模型的时候,不用再被机器人身上的那点算力卡脖子了。想用大模型?直接用,算力不够就让云端来扛。这一刀切下去,直接松绑了整个行业的模型选择空间。
所以,这表面上是发布了一个开源工具,实际上是在卡位一个更底层的东西——具身智能行业的工程标准。以前大家各搞各的,接口乱成一锅粥;现在有人把“插座”的标准给你定好了,你插上去就能用。用的人越多,这个标准就越牢固。而标准这个东西,从来都是先到先得。