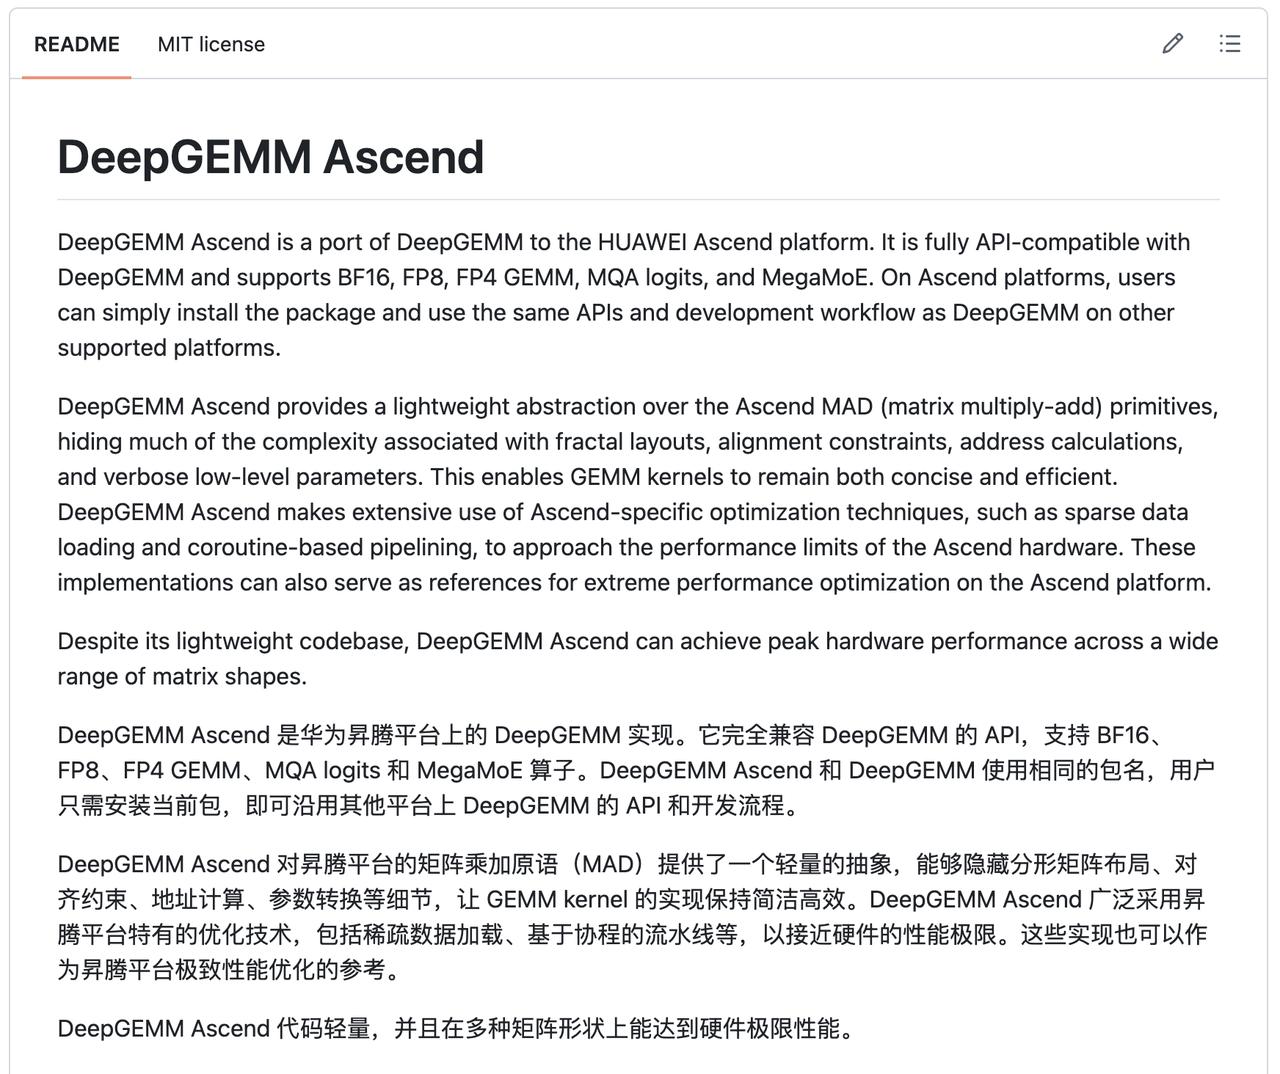
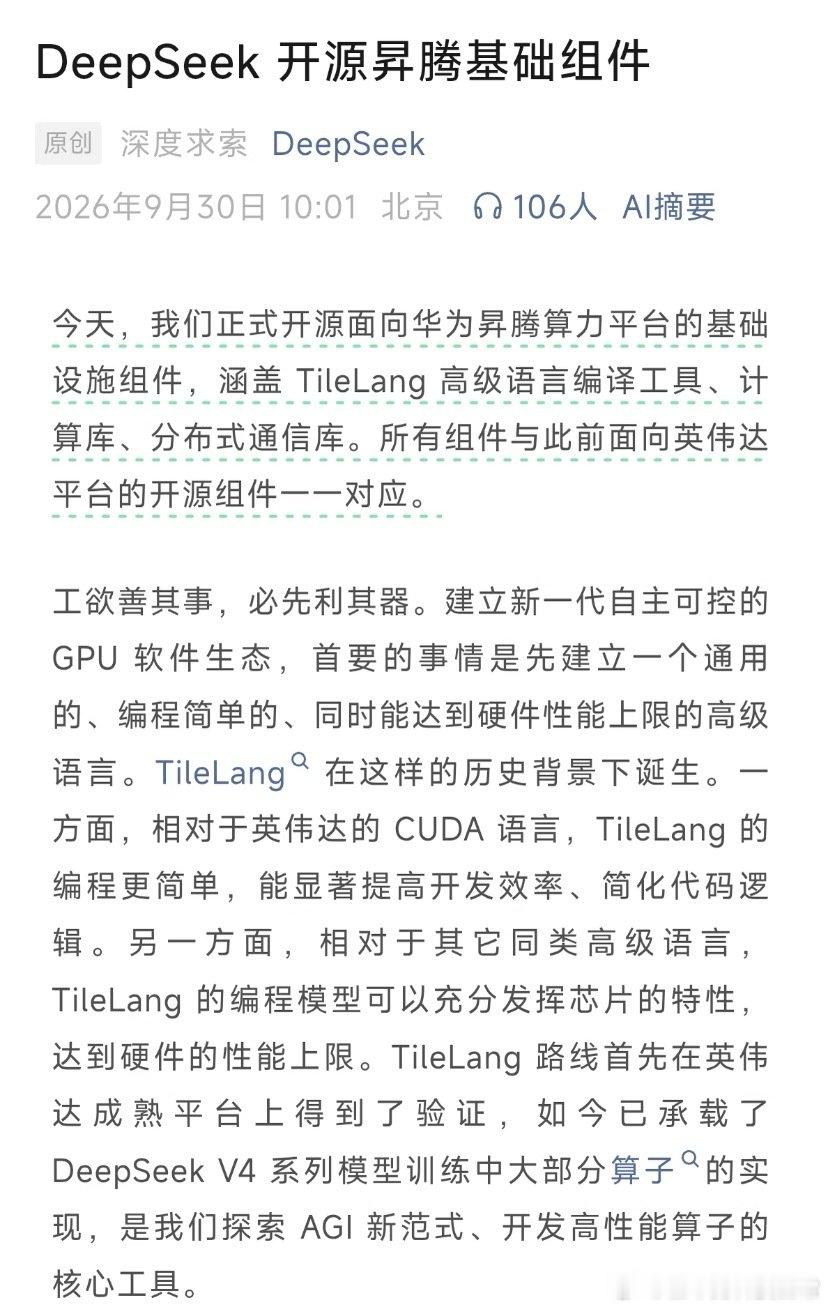
九月三十日,DeepSeek 在 GitHub 上放出了一个新仓库:DeepGEMM-Ascend,MIT 协议,开源可商用。
这东西不是模型,是模型底下的一层。
矩阵乘法是大模型算得最多的一件事,训练和推理的时间基本都花在它上面。但同一道乘法题,代码写得好不好,差距能有几倍。怎么把数据搬进芯片、什么时候搬、搬多大一块、算的时候别让搬运闲着——这些既不性感也不出名,却决定了一块芯片实际能发挥出几成力气。
DeepSeek 原来有一个 DeepGEMM,是给英伟达的卡写的。这次他们照着华为昇腾芯片,把这层重写了一遍。
README 里的数字我核对过:在昇腾 950DT 上,BF16 的稠密矩阵乘跑到硬件理论峰值的 99.8%,FP8 是 99.5%,FP4 是 98.3%。接口和原来那版完全一样,装上去,原来怎么写现在还怎么写。
这里要说清楚一件事,因为传播的时候最容易传歪。
「99.8%」不是说它比英伟达快。这个数的分母是**这块芯片自己的理论峰值**。它说的是:这块卡的力气,被榨出来 99.8%。至于这块卡的力气本来有多大,是另一个问题,这个数回答不了。
所以它证明的不是硬件强,而是——**终于有人把这块卡的说明书,读到头了**。
《庄子·达生》里有一则:
孔子去楚国,路过一片树林,看见一个驼背老人用竿子粘蝉,像伸手捡东西一样容易。孔子问他有什么门道。
老人说:「我有道也。五六月,累丸二而不坠,则失者锱铢;累三而不坠,则失者十一;累五而不坠,犹掇之也。」
练了五六个月:在竿头摞两颗弹丸不掉下来,蝉就很少跑掉了;摞三颗不掉,十只里只跑一只;摞五颗还不掉,粘蝉就跟捡东西一样了。
他接着说,站在那儿身子像木桩,举着胳膊像枯枝,天地那么大,万物那么多,我眼里只有蝉的翅膀。
孔子回头对学生说:「用志不分,乃凝于神。」
过去两年,国产芯片被谈论得很多,谈的多半是产能、制程、禁令。但真正拦路的那道坎,常常不在芯片本身,而在芯片和代码之间那层没人愿意干的脏活:算子库、编译器、调度、对齐、流水线。英伟达那层叫 CUDA,攒了快二十年,攒的就是无数个「在竿头多摞一颗弹丸」。
这件事还有个意外的地方:干这活的不是芯片厂,是一家做模型的公司。自己要用,就自己写,写完扔出来大家用。
说句老实话,现在能用上它的人很少——它要昇腾 950 系列的卡,这卡按华为自己的说法,大规模供货要到今年底或明年初。
但弹丸已经摞上去了。