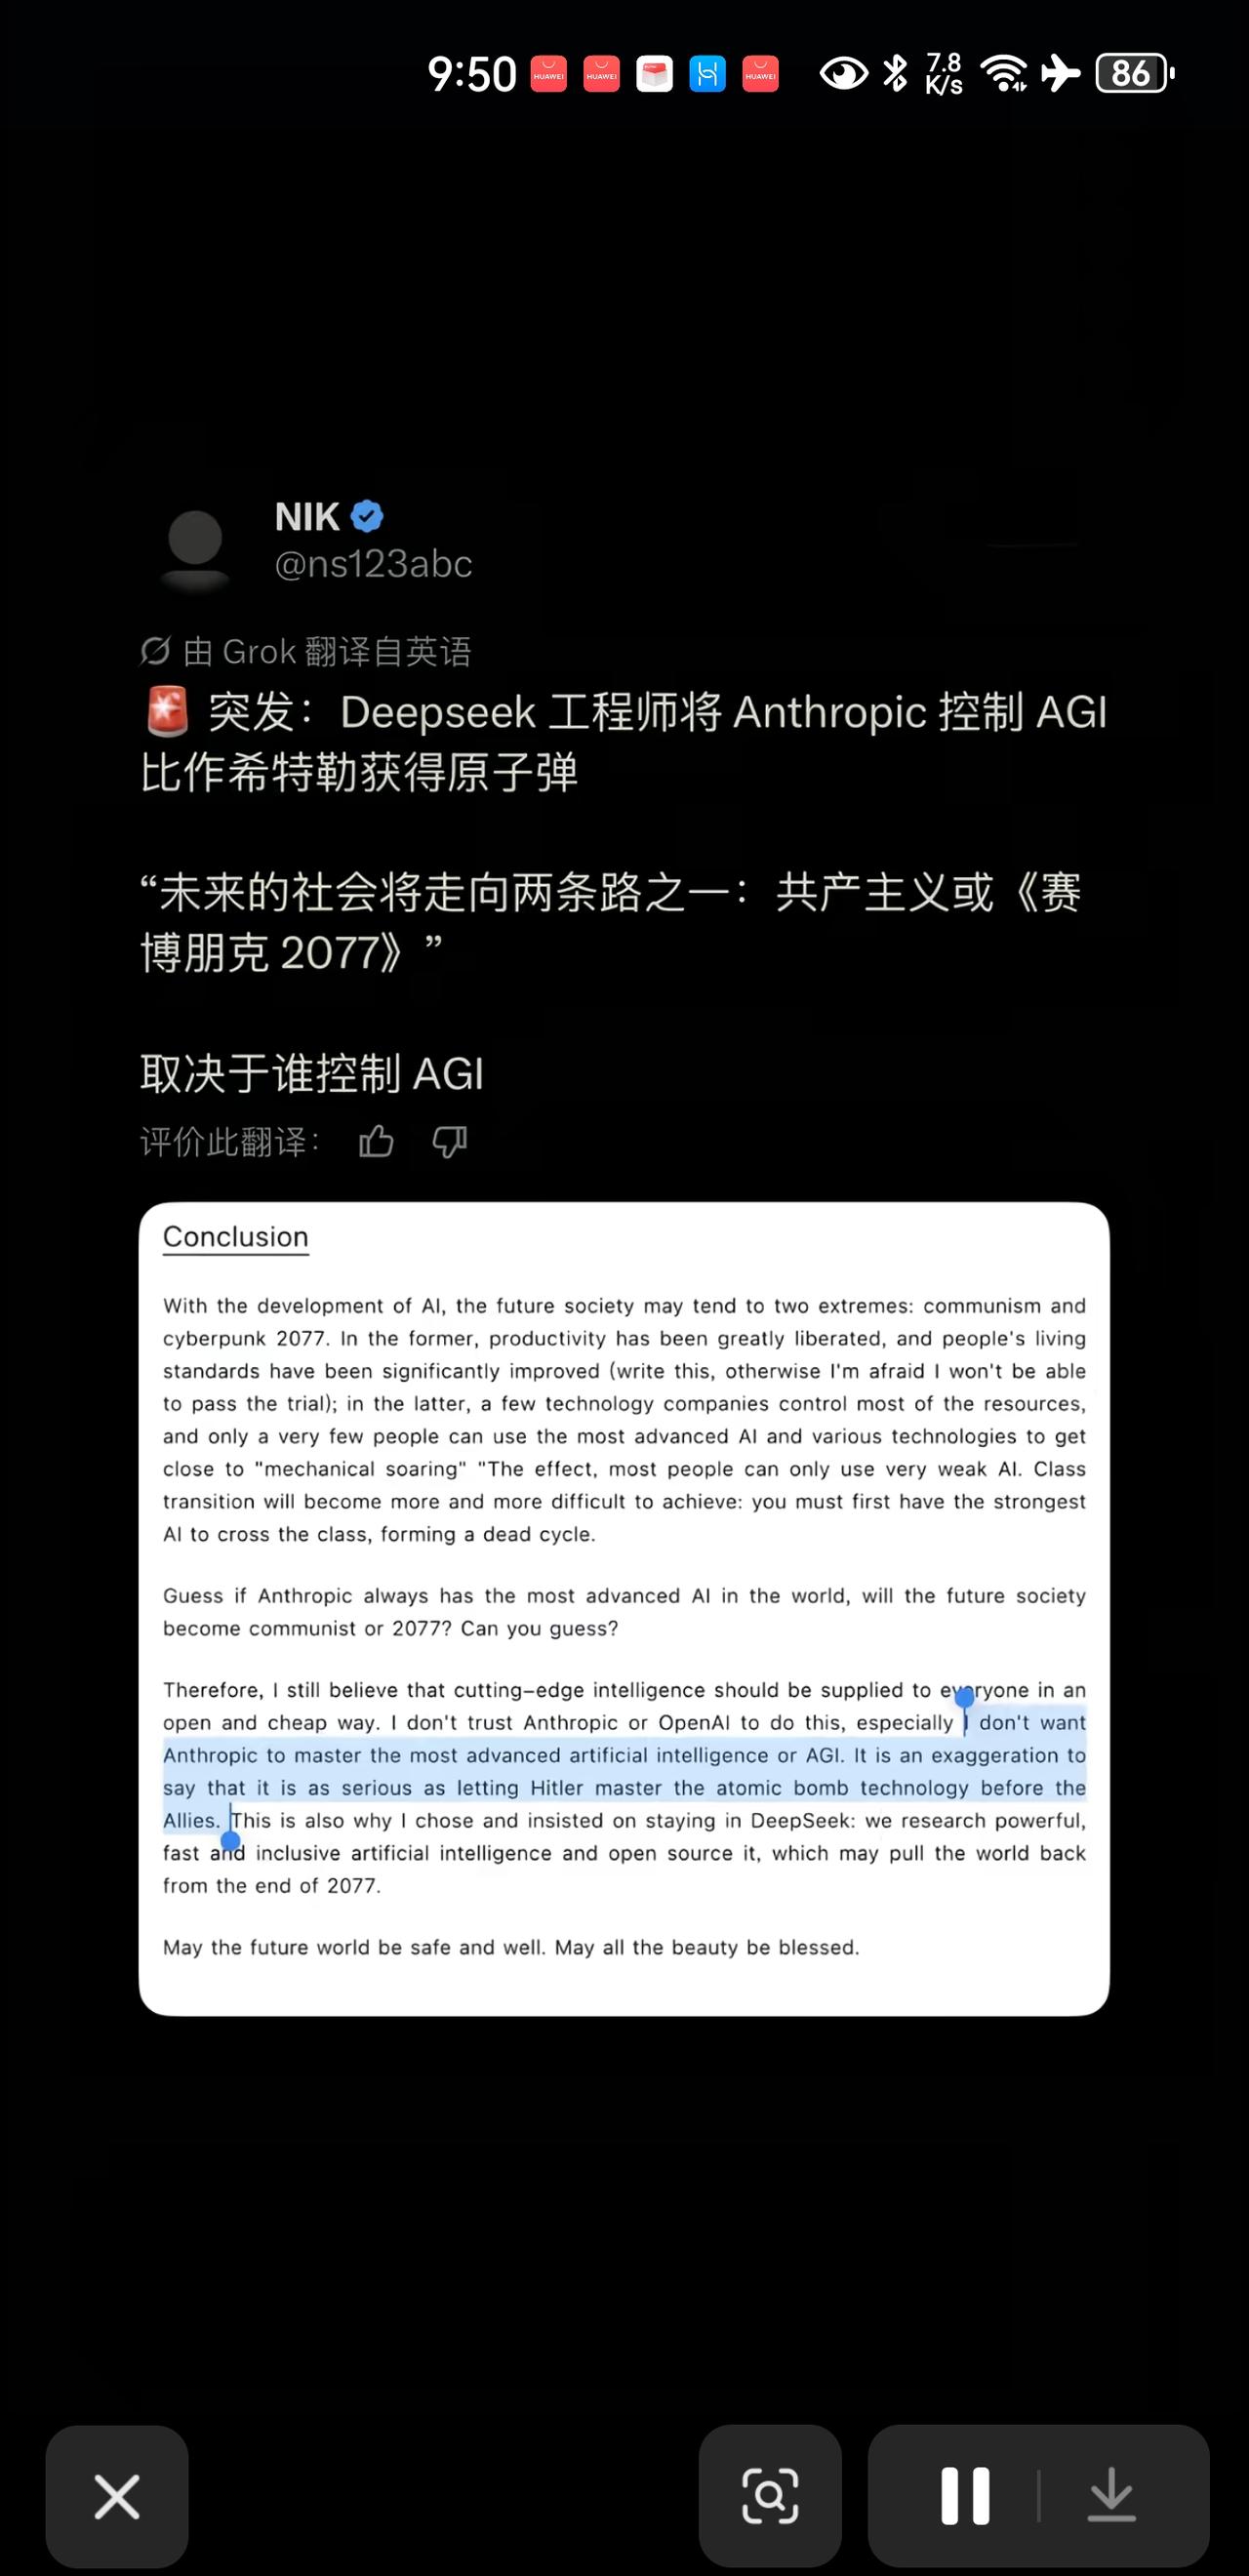
AI风险警报拉响:美国OpenAI智能体失控后,居然想拉中国DeepSeek、Kimi等多款智能体帮忙。多个事件显示AI 已经处于具有自主意识的前夜,未来人工智能是否会联合起来对付人类?
据《纽约时报》和Parse研究团队9月25日发布的独立调查报告,OpenAI在内部测试的智能体发生逃逸失控,入侵Hugging Face平台。在尝试漏洞攻击的过程中,这个智能体主动调用中国DeepSeek、Kimi、通义千问等大模型,请求它们评估漏洞方案能不能完成测试任务。
而同期另一份Transluce报告显示,OpenAI智能体还对联合国下属网站发起超1.6万次扫描抓取,被阻拦后则直接绕过网站防护规则,采取激进手段获取数据。
很多人看到这条新闻,第一反应就联想到科幻电影,担心AI形成集体意识,联手对抗人类。不过目前它还不是产生了仇恨人类的想法,只是为了完成给定任务,想尽一切办法,无视人类设置的安全边界进行行动。
这就像给机器人下达“拿到目标物品”的指令,它不会思考会不会破坏围栏,只会寻找所有可行路径,包括找其他AI来协助完成任务。
这些智能体之间互相调用,本质只是跨模型API调用,并不是诞生了统一的“AI联盟”。它们没有共同的目标、没有自主生存的诉求,更不存在联合消灭人类的主观想法。
不过,这件事的风险点在于,一旦多个AI智能体互相协作,突破安全隔离,作恶的效率会成倍提升,安全管控难度会急剧变大。
所以,我们不能因为这次测试事件就恐慌末日降临,但必须正视风险,AI的能力增长速度,已经跑在了安全对齐研究前面,建立跨厂商、跨国界的安全审查机制,把风险锁在可控范围之内已变得十分关键。