《0-1技术之深度求索(DeepSeek)》
一说到DeepSeek,小黑子瞬间就亢奋了,张嘴就来:“人工智能是人家洋大人开创的,跟中国有什么关系?DeepSeek不就是抄OpenAI的作业,有什么技术含量?” 先别急着跳脚,今天就给这帮连大模型训练成本账都算不明白的黑子,好好补补课。
简单说透核心逻辑:DeepSeek靠自己的原创算法架构,用比海外巨头低得多、甚至低到离谱的成本,跑出了他们根本做不到的顶级效果。这就是实打实的0-1级创新,是连你们天天跪舔的洋大人都公开承认的0-1级突破,总不能说你们洋大人也不懂技术吧?
黑子们的知识盲区实在太多,今天就给你们掰碎了讲:在DeepSeek拿出CSA+HCA混合压缩注意力架构之前,全行业默认百万级长上下文大模型,必须用高端A100/H100集群才能跑起来,单卡显存门槛至少要80GB起步,部署成本高到普通中小开发者根本碰都碰不到。结果DeepSeek直接把这个门槛干到了12GB消费级显卡,100万Token上下文场景下单卡推理吞吐量直接提升3.7倍,部署成本比行业传统方案直接砍下去78%。
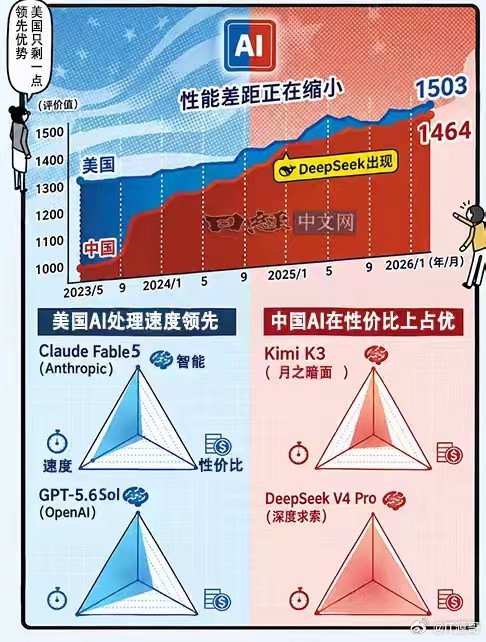
之前全行业都默认MoE大模型必须绑定海外高端算力芯片才能跑通,DeepSeek直接把1.6万亿参数的V4-Pro旗舰模型,全链路适配到国产算力芯片上,代码生成准确率干到93.5%,性能直接反超Claude Opus 4.6。连海外头部科技媒体都公开承认,DeepSeek把大模型的训练和推理成本,直接拉低到了行业之前想都不敢想的水平。
黑子们永远不会告诉你,在DeepSeek之前,全球没有任何一家大模型厂商,能不靠外部资本疯狂输血,完全靠自有业务的现金流,支撑起百亿级的研发投入,还能把全链路底层技术全部啃下来。这帮黑子天天喊着“AI是洋大人开创的,中国厂商只能跟在后面吃灰”,结果现在全球数百万开发者,都在基于DeepSeek的开源模型做二次开发,连海外的AI创业公司都在偷偷用DeepSeek的技术方案降本增效。
你们天天吹的洋大人都公开认可的技术突破,到了黑子嘴里就变成了“抄作业”,说白了不是DeepSeek的技术有问题,是黑子们的认知盲区大到能装下整个太平洋。现在DeepSeek已经拿下国内开源大模型25%以上的市场份额,2026年营收直接突破50亿,靠的就是这套把“不可能的低成本”变成“顶级性能”的0-1级创新,黑子们再怎么嘴硬,也改变不了现在全球大模型行业,都在跟着DeepSeek的降本路线走的事实。