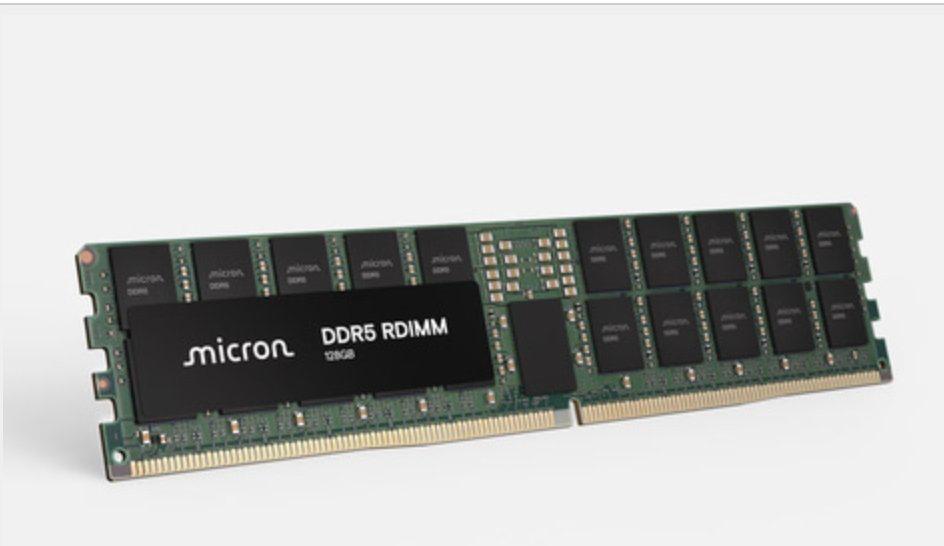
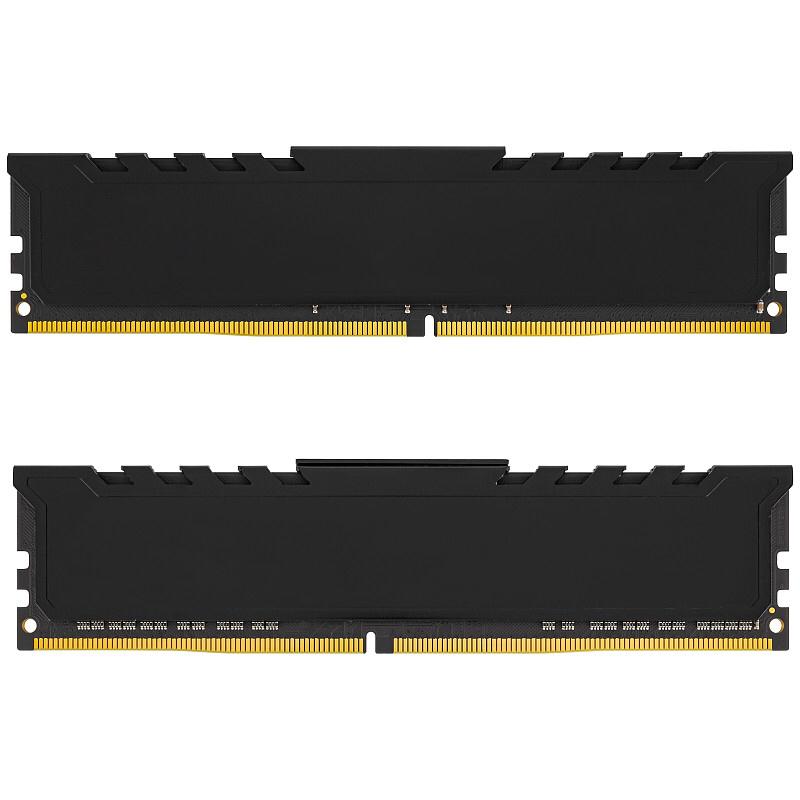
美光刚刚甩出单条容量 512GB DDR5 内存条。。。传输速率直接飙到了 9200 MT/s!
这是什么概念?
一台双路服务器插满 24 个槽位,整机主内存能直接堆到 12TB。
很多人家里的固态硬盘容量加起来连它的零头都不到。
过去行业里有个铁律:内存容量越扯越大,频率就得被迫拉低,属于典型的用速度换空间。
但这次美光上了黑科技,用 TSV 硅通孔垂直堆叠技术,容量上去了,速度一点没缩水。
更绝的是功耗。
按照过去的逻辑,用 4 条 128GB 拼凑出 512GB 的容量,光内存运行功耗就得 44 瓦左右,多插几条跑起来温度能烤肉。而这种 3D 堆叠的单条 512GB,功耗直接砸到了 16 瓦,整体能耗暴降六成以上。
为什么硬件厂商要在内存上疯狂卷出天际?答案只有两个字:给 AI 喂饭。
现在的 AI 大模型早已不是陪你闲聊的阶段了。
百万 Token 的长上下文检索、上千亿参数的模型推理,都在疯狂吞噬硬件的物理极限。很多人只看到了英伟达芯片上极其昂贵的 HBM 高带宽内存,却忽略了真正决定数据搬运效率的地下运河——CPU 主内存。
HBM 就像是显卡上的顶级刺客,速度极快但容量极其娇贵,强如顶级 AI 显卡也不过百来吉字节的显存。面对动辄 TB 级的向量数据库、Redis 内存数据库以及复杂的 RAG 架构,GPU 必须频繁向 CPU 主机要数据。如果 CPU 的内存不够大,数据就得去读 NVMe 固态硬盘。
哪怕是顶级的 PCIe 5.0 固态硬盘,读写速度顶天也就 14GB/s;而这个 9200 MT/s 的 DDR5 矩阵在多通道并发下,整体带宽是每秒 TB 级别的。把海量数据直接吞在内存里,还是从硬盘里往外搬,这直接决定了大模型到底是秒回答案,还是原地转圈卡顿。
在电费即命根子的算力数据中心里,单条内存省下 28 瓦听起来不多,但放大到几十万台节点的集群规模,省下来的电费甚至够再买几千张显卡。
预计到 2027 年下半年量产时,英特尔和 AMD 的新架构将全面接轨这种吞吐怪兽。
科技的发展有时就是这么冰冷又充满幽默感。当普通消费者还在为内存颗粒涨价精打细算、纠结电脑配 16G 还是 32G 时,数据中心已经开始用 TB 作为单机内存的基础单位了。
数据吞噬算法,算力吞噬电力,而物理极限正在被一层层堆叠的硅片重新定义。将来你的电脑如果跑不动新软件,可能真的不是芯片算得慢,单纯是因为你的硬盘,还没人家的一根内存条能装。