DeepSeek V4.1 Flash推倒重来,梁文锋要抢的不是模型,是入口
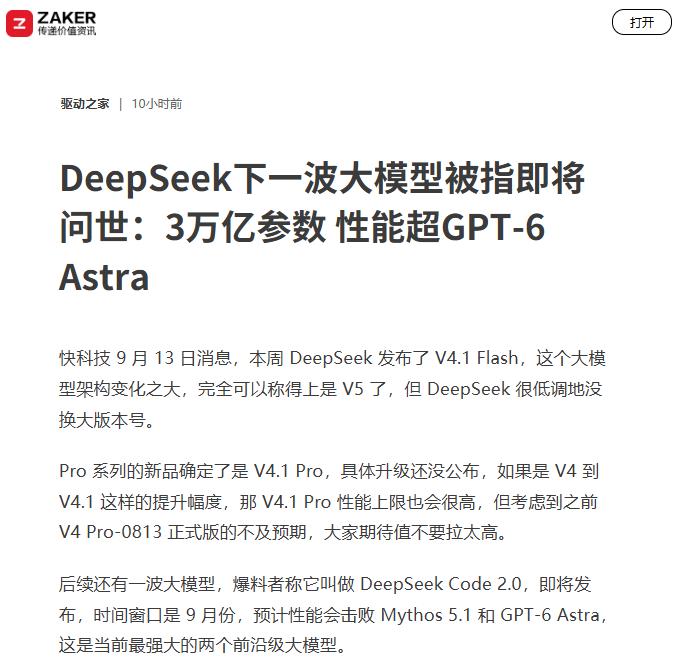
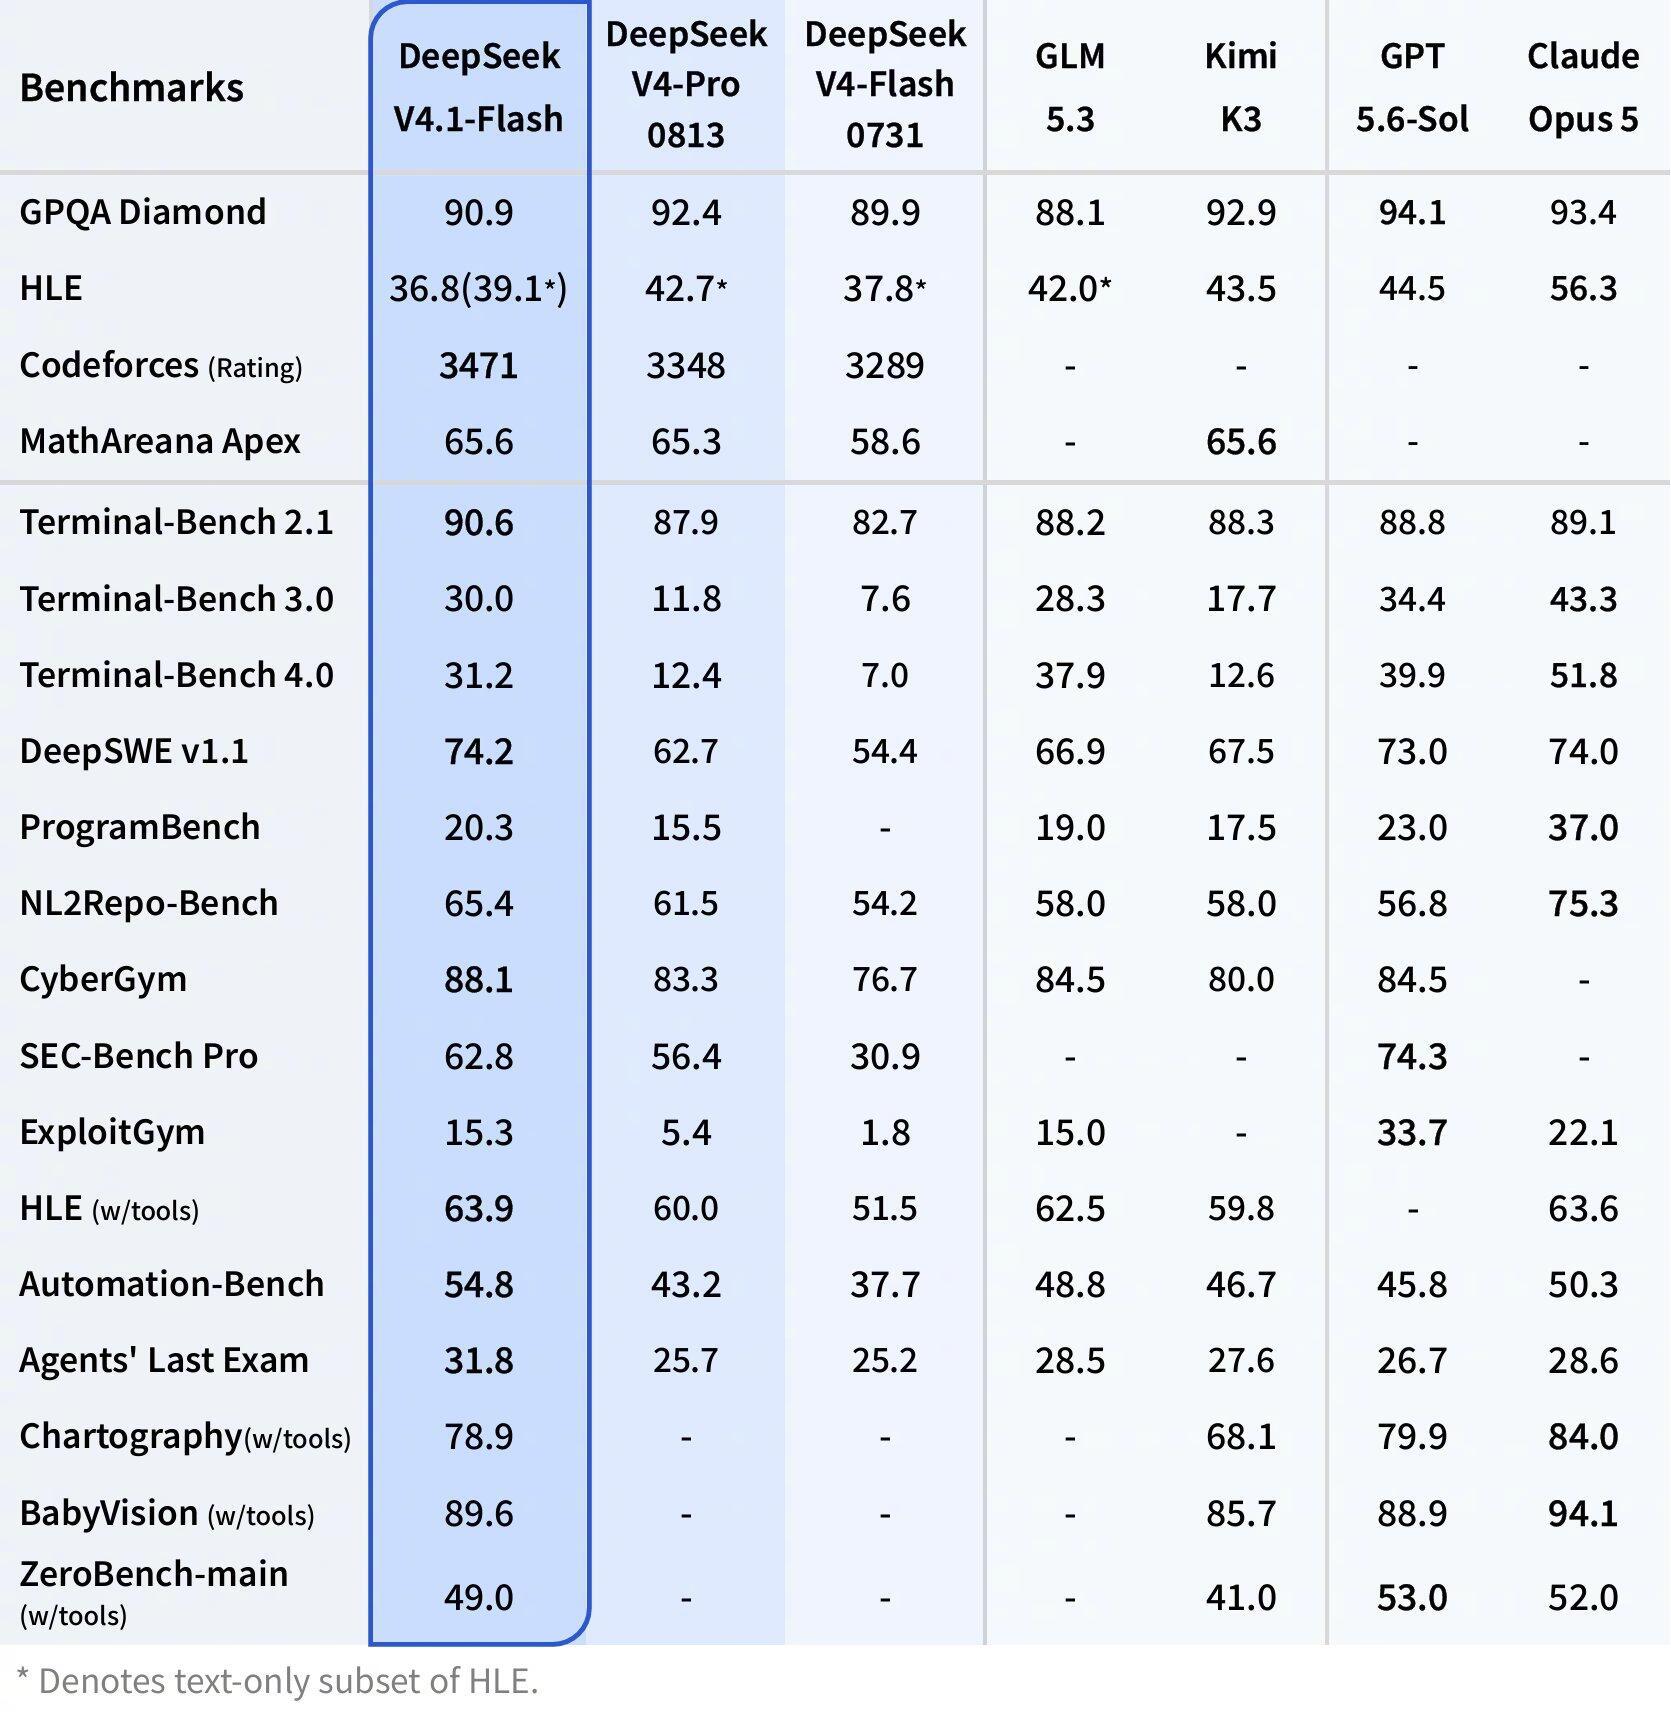
DeepSeek V4.1 Flash发布后,速度快了、答得更准、还原生多模态,网上又把梁文锋喊成“梁圣”。但真正的大事是:这次不是小改,是推倒重来。V4那套结构、训练配方、工程适配,大部分作废。几百人的公司这么干,费钱费力,梁文锋还是干了。因为旧架构装不下新目标——入口。
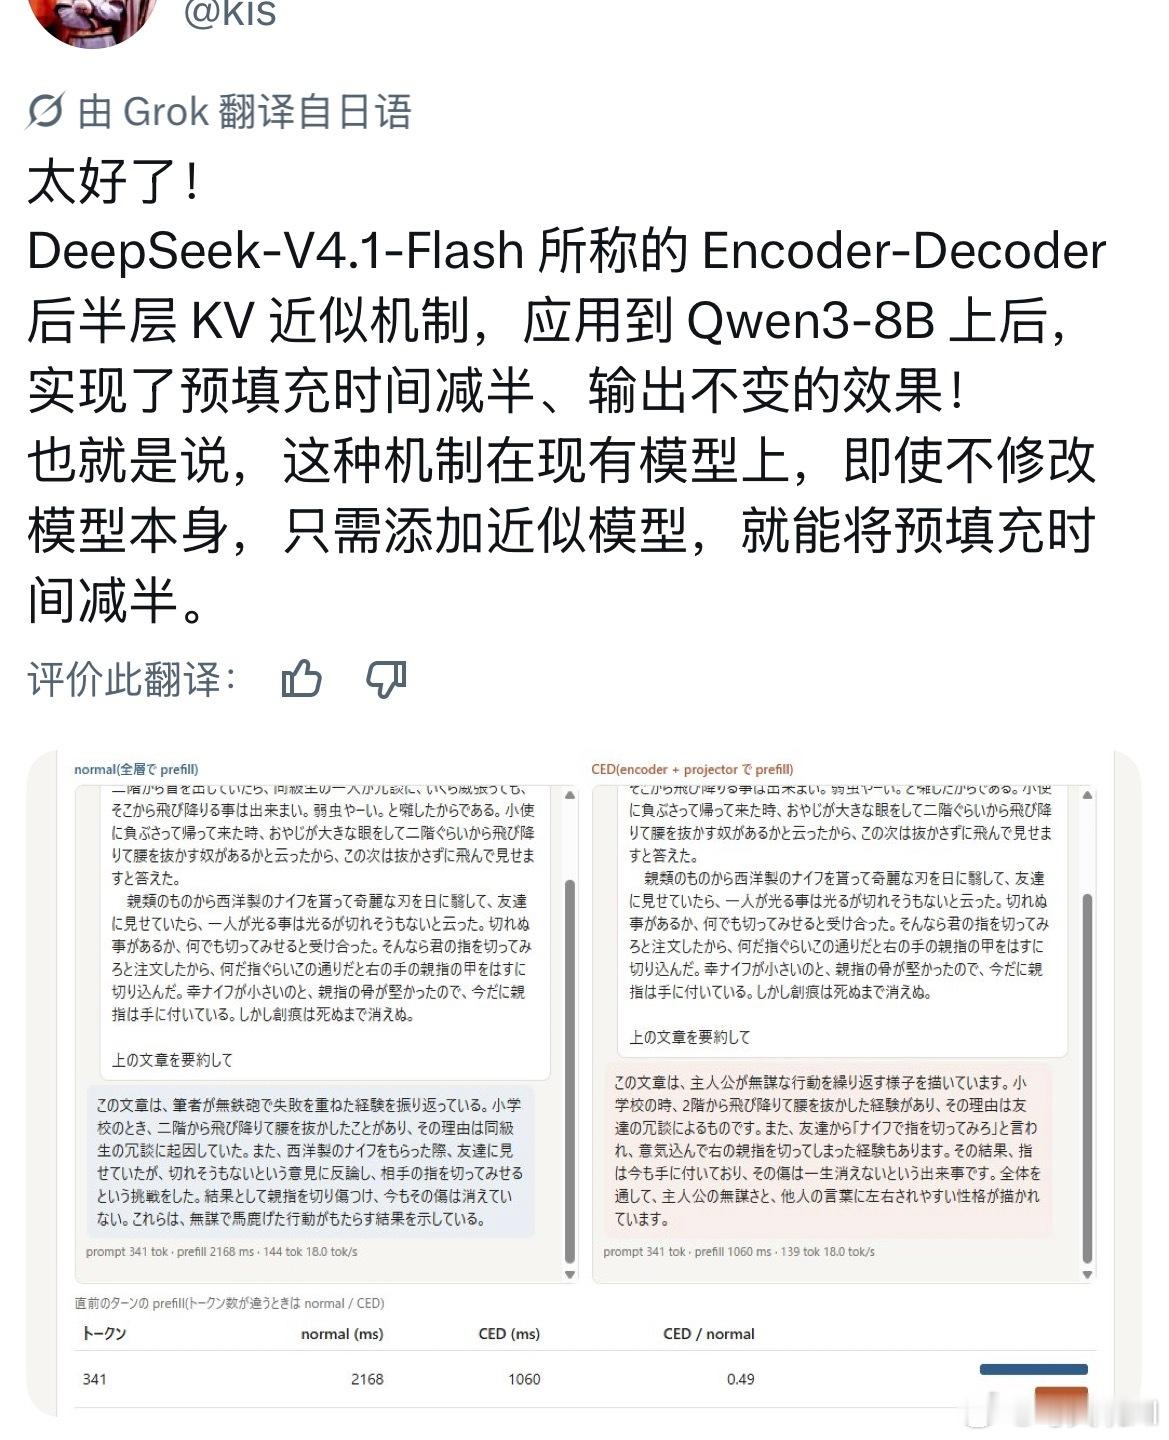
V4.1 Flash是被DSH“喂”出来的。后训练还是SFT→RL→在线蒸馏,算法没大改,变的是数据流水线:大规模合成Agent任务和环境,让模型在6种Agent框架里反复试错。DSH是最重要的训练场。为适配它,V4.1换了非对称结构CED:40层拆成前20层编码器只管读,后20层解码器只管写。像汽车流水线,冲压归冲压,电泳归电泳。全局KV Cache压到890字节/token,只有V4 Flash的四分之一。再加CSA2压缩稀疏注意力,层与层共享KV和索引,输入密集的Agent负载成本大降。
智谱和Kimi也有工具,但更像后挂外壳,模型先在合成环境练好,再给用户用。智谱押注完全自训练,Kimi搞AgentENV沙箱闭关。DSH和WorkBuddy不一样,它们是入口:用户在真实环境干活,数据回流,模型在实战里被养大。
DSH从极客玩具升到v0.1.5,能交付文件、保留KV Cache改系统提示词,越来越像面向大众的Agent产品。DeepSeek想学吉列:刀架不赚钱,但锁定用户。换模型容易,换Harness难。所以梁文锋抢的不是一次模型发布,是入口。谁掌握入口,谁掌握下一轮。