一文读懂DeepSeek V4.1 Flash的架构创新
DS 的架构创新还是太屌了。放出来的已经是这个样子,很难想象他们背后做了多少探索。
这次 V4.1 Flash 用上 Causal Encoder-Decoder:处理输入每个 token 激活约 8B 参数,生成时约 16B。
先聊架构。40 层分成前后各 20 层:前半段的输出,能构造后半段需要的全局 KV,可以理解为“上下文笔记”。所以,大部分长输入不必跑完整个后半段,只需补算末尾局部窗口。生成时 40 层仍然全跑,不是只跑后半段。
但此 Encoder 非彼 Encoder。Encoder 是把输入变成后面可用的表示;Causal 是不能偷看后文。比如编码“小明”时,不能提前利用后面的“把苹果吃了”。
真正贯穿论文的,是 KV 缓存压缩。长上下文不只算得贵,还存得贵、搬得慢。DeepSeek 几刀一起下:
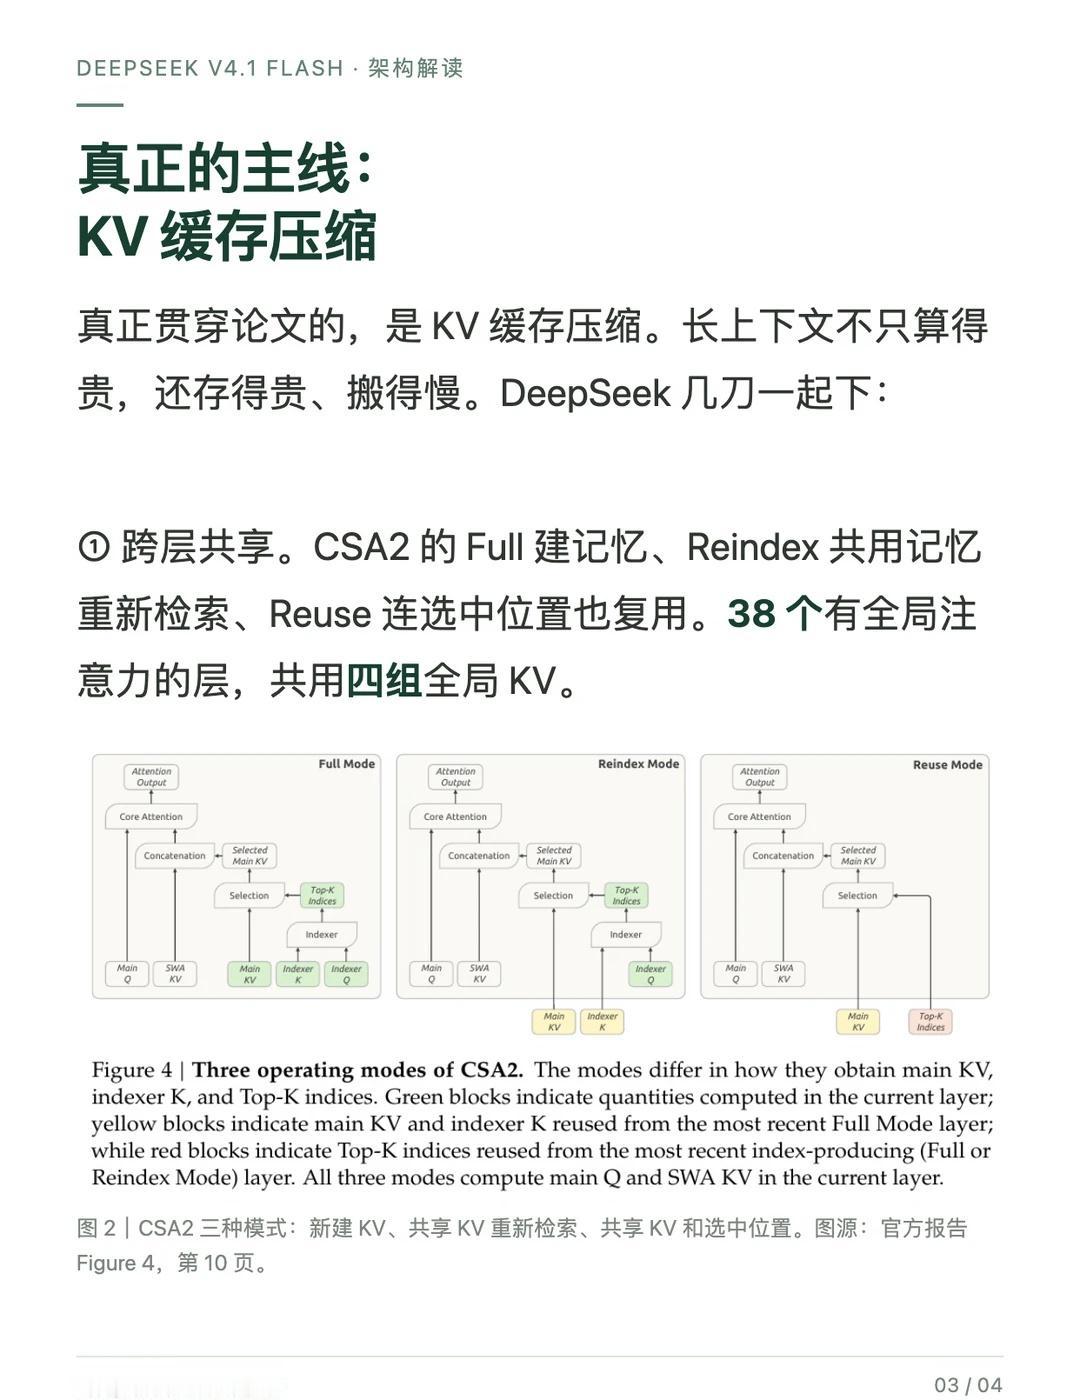
① 跨层共享。CSA2 的 Full 建记忆、Reindex 共用记忆重新检索、Reuse 连选中位置也复用。38 个有全局注意力的层,共用四组全局 KV。
② 序列压缩。Encoder 两个 token 压成一条全局记录;Decoder 保留逐位置记录,靠共享省空间。
③ 降低精度。主 KV 从 FP8 降到 FP4,后训练适应量化;更敏感的局部 KV 仍用 FP8。
④ 调整保存方式。局部状态不再长期持久化,必要时回放末尾短片段近似恢复。不是无损恢复,报告称质量影响很小。
结果:全局 KV 约为 V4 Flash 的 1/4,持久化 KV 约为上一代的 1/8,两个比例口径不同。百万 token 的全局 KV 约 0.89 GB,不包含模型权重和其他运行开销。
CED 受 2024 年 YoCo 启发。越读越觉得,难的不只是一处巧思,而是这些设计怎么一起跑起来。
(更详细的学习笔记可参考AI Dancer公众号)
DeepSeek 大模型 架构创新 DeepSeek新模型 Agent DeepSeek架构创新 Yoco 算法工程师 infra