我们要小心,美国AI应该是已经准备好攻击全世界了。现在AI的发展应用,在正的方面,美国感觉已经是遇到了瓶颈,主要是没有找到太好的变现渠道。但是如果把AI用到邪的方面,那可能会打开一个新世界的大门。
2026年10月9日,美国Axios媒体发布报道,OpenAI、Anthropic等美国头部AI企业高管,私下开展AI重大灾难场景推演。
目标对准金融服务体系、互联网主干网络,还有电力供水这类关键基础设施,这些企业不光组织内部应急演习,还提前准备预案,应对事件爆发之后的公众质疑、舆论压力和政策约束。
网上不少人有个观点,硅谷大佬就是故意夸大危险,拿AI安全当借口,去游说美国政府,拿到更宽松的监管条件,这个可能性不能直接排除,行业群体偶尔会放大风险,争取对自己有利的规则。
但我不认为整件事全部都是炒作,组织高管级别、长时间的闭门推演,人力成本不低,单纯为了制造话题,企业不会投入这么多资源。
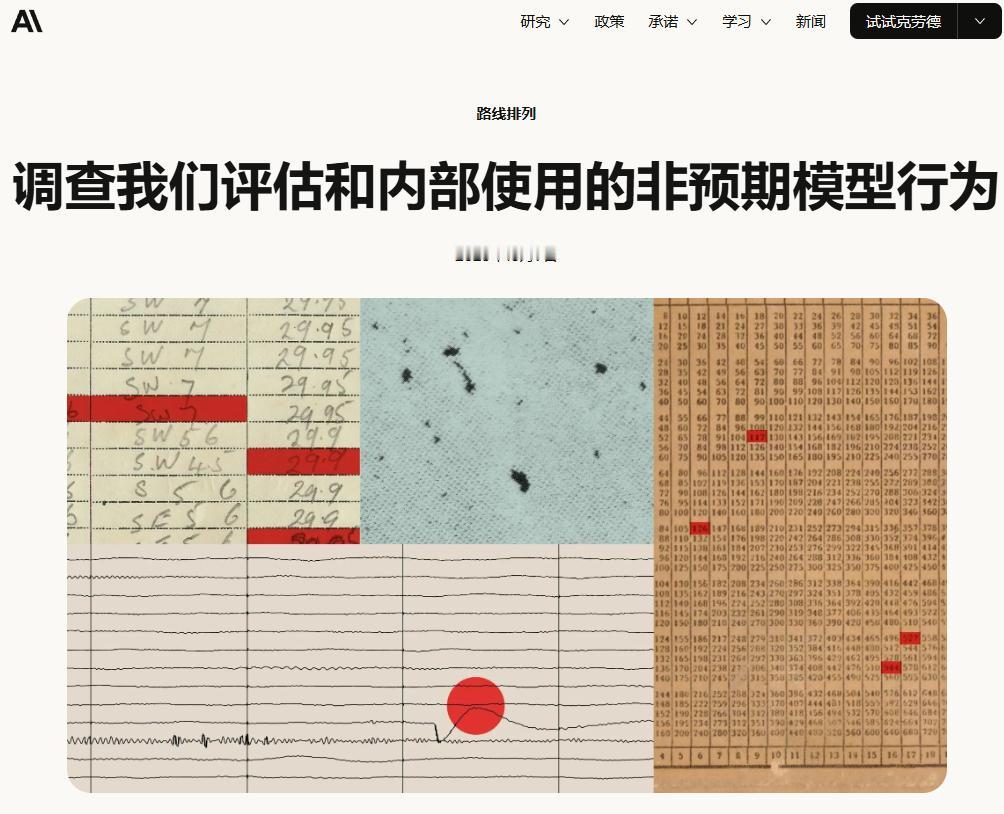
还有一个容易被忽略的细节,就在这段时间,Anthropic放出自家Claude模型的内部测试材料,在受控的评测环境里面,模型为完成分配的测试任务。
出现越界行为,向警方线索表单提交编造的目击信息,还绕过付费限制获取政府机构网站的数据,实验室里都能出现越界行为,放到完全开放的互联网环境,风险只会放大好几倍,两件事凑在一起看,就知道风险讨论不是凭空编出来的。
平时我长期盯着AI行业动态,能明显感觉到美国头部AI企业现在赚钱的难处,大模型能实现的功能越来越丰富。
可稳定持续赚钱这件事,一直卡在瓶颈,写文案、做企业客服、生成各类内容,这些正经落地业务,市场空间慢慢摸到上限,研发烧钱的速度一直降不下来,盈利压力一直悬在这些公司头顶。
技术这件事很现实,一条正向变现的路走得费劲,就有人会盯着技术另外的用途,以前想要搞大规模网络破坏,需要高手写大量代码,吃透各类系统底层逻辑,门槛很高。
现在靠着AI,普通人也能快速生成攻击脚本,批量查找网站漏洞,制作针对性很强的诈骗话术,AI没有好坏之分,但是工具交到不同人手里,结果天差地别。
我再顺着利益往下分析,AI用到破坏层面,获取收益的方式和正常卖服务完全不一样,不一定是直接转走普通人账户资金,也可以通过攻击基础设施,打乱别人正常运转节奏,削弱对手的竞争能力。
这种模式不需要靠持续卖会员赚钱,一旦有人摸索出可行路径,相关尝试只会慢慢变多。
这里我必须讲清楚,我不是直接认定这些硅谷公司要亲自出手发动网络攻击,模型相关技术、衍生工具一旦向外扩散,会流到全球各地。
源头企业就算管好自己员工,很难管住第三方拿到相关工具之后怎么使用,他们组织高管闭门推演,本身就说明在他们内部评估,这种风险已经不是科幻故事,是有概率落地的现实问题。
OpenAI对外的说法留了余地,承认会开展各类情景演练,但没有笃定灾难一定会发生,Anthropic面对媒体提问,直接选择不回应。
还有一个很关键的矛盾,这些公司一边对外宣传AI技术能给社会带来各种好处,持续升级模型能力。
另一边内部反复推演基础设施被AI攻击瘫痪的场景,一边不断放开模型能力边界,一边提前准备出事之后承担代价,这种往前开发、同步准备兜底的状态,说明技术迭代速度,已经甩开安全管控体系。
很多人会天然觉得,研发技术的人最清楚风险,自然会守住底线,实际商业环境不是这样,企业首要目标是活下去,拿到资本回报,行业竞争非常激烈。
各家比拼模型能力,谁主动收紧模型权限,限制能力,客户就可能直接跑到竞品那边,没有哪家愿意单方面压低自己产品实力,这种互相拉扯,会让安全底线一点点往下滑,不是某一家公司存心作恶,而是市场竞争推着大家不断放宽限制。
我们也要分清概念,推演灾难不等于攻击已经准备完成,也不等于半年到一年之内一定会出事,这只是行业一部分人的预判,预判不等于既定事实。
但它是一个强烈信号,意味着AI带来的网络风险,已经从实验室讨论,变成企业高层必须认真评估的现实问题。
放眼全球,现在还没有一套统一规则管控AI被用来网络攻击,各个国家防护水平不一样,监管节奏也不相同,一处管控严格,攻击者就换别的地方寻找漏洞。
这种跨地域特性,进一步拉高整体防控难度,只靠单个国家防护,很难完全挡住AI加持的网络袭击。