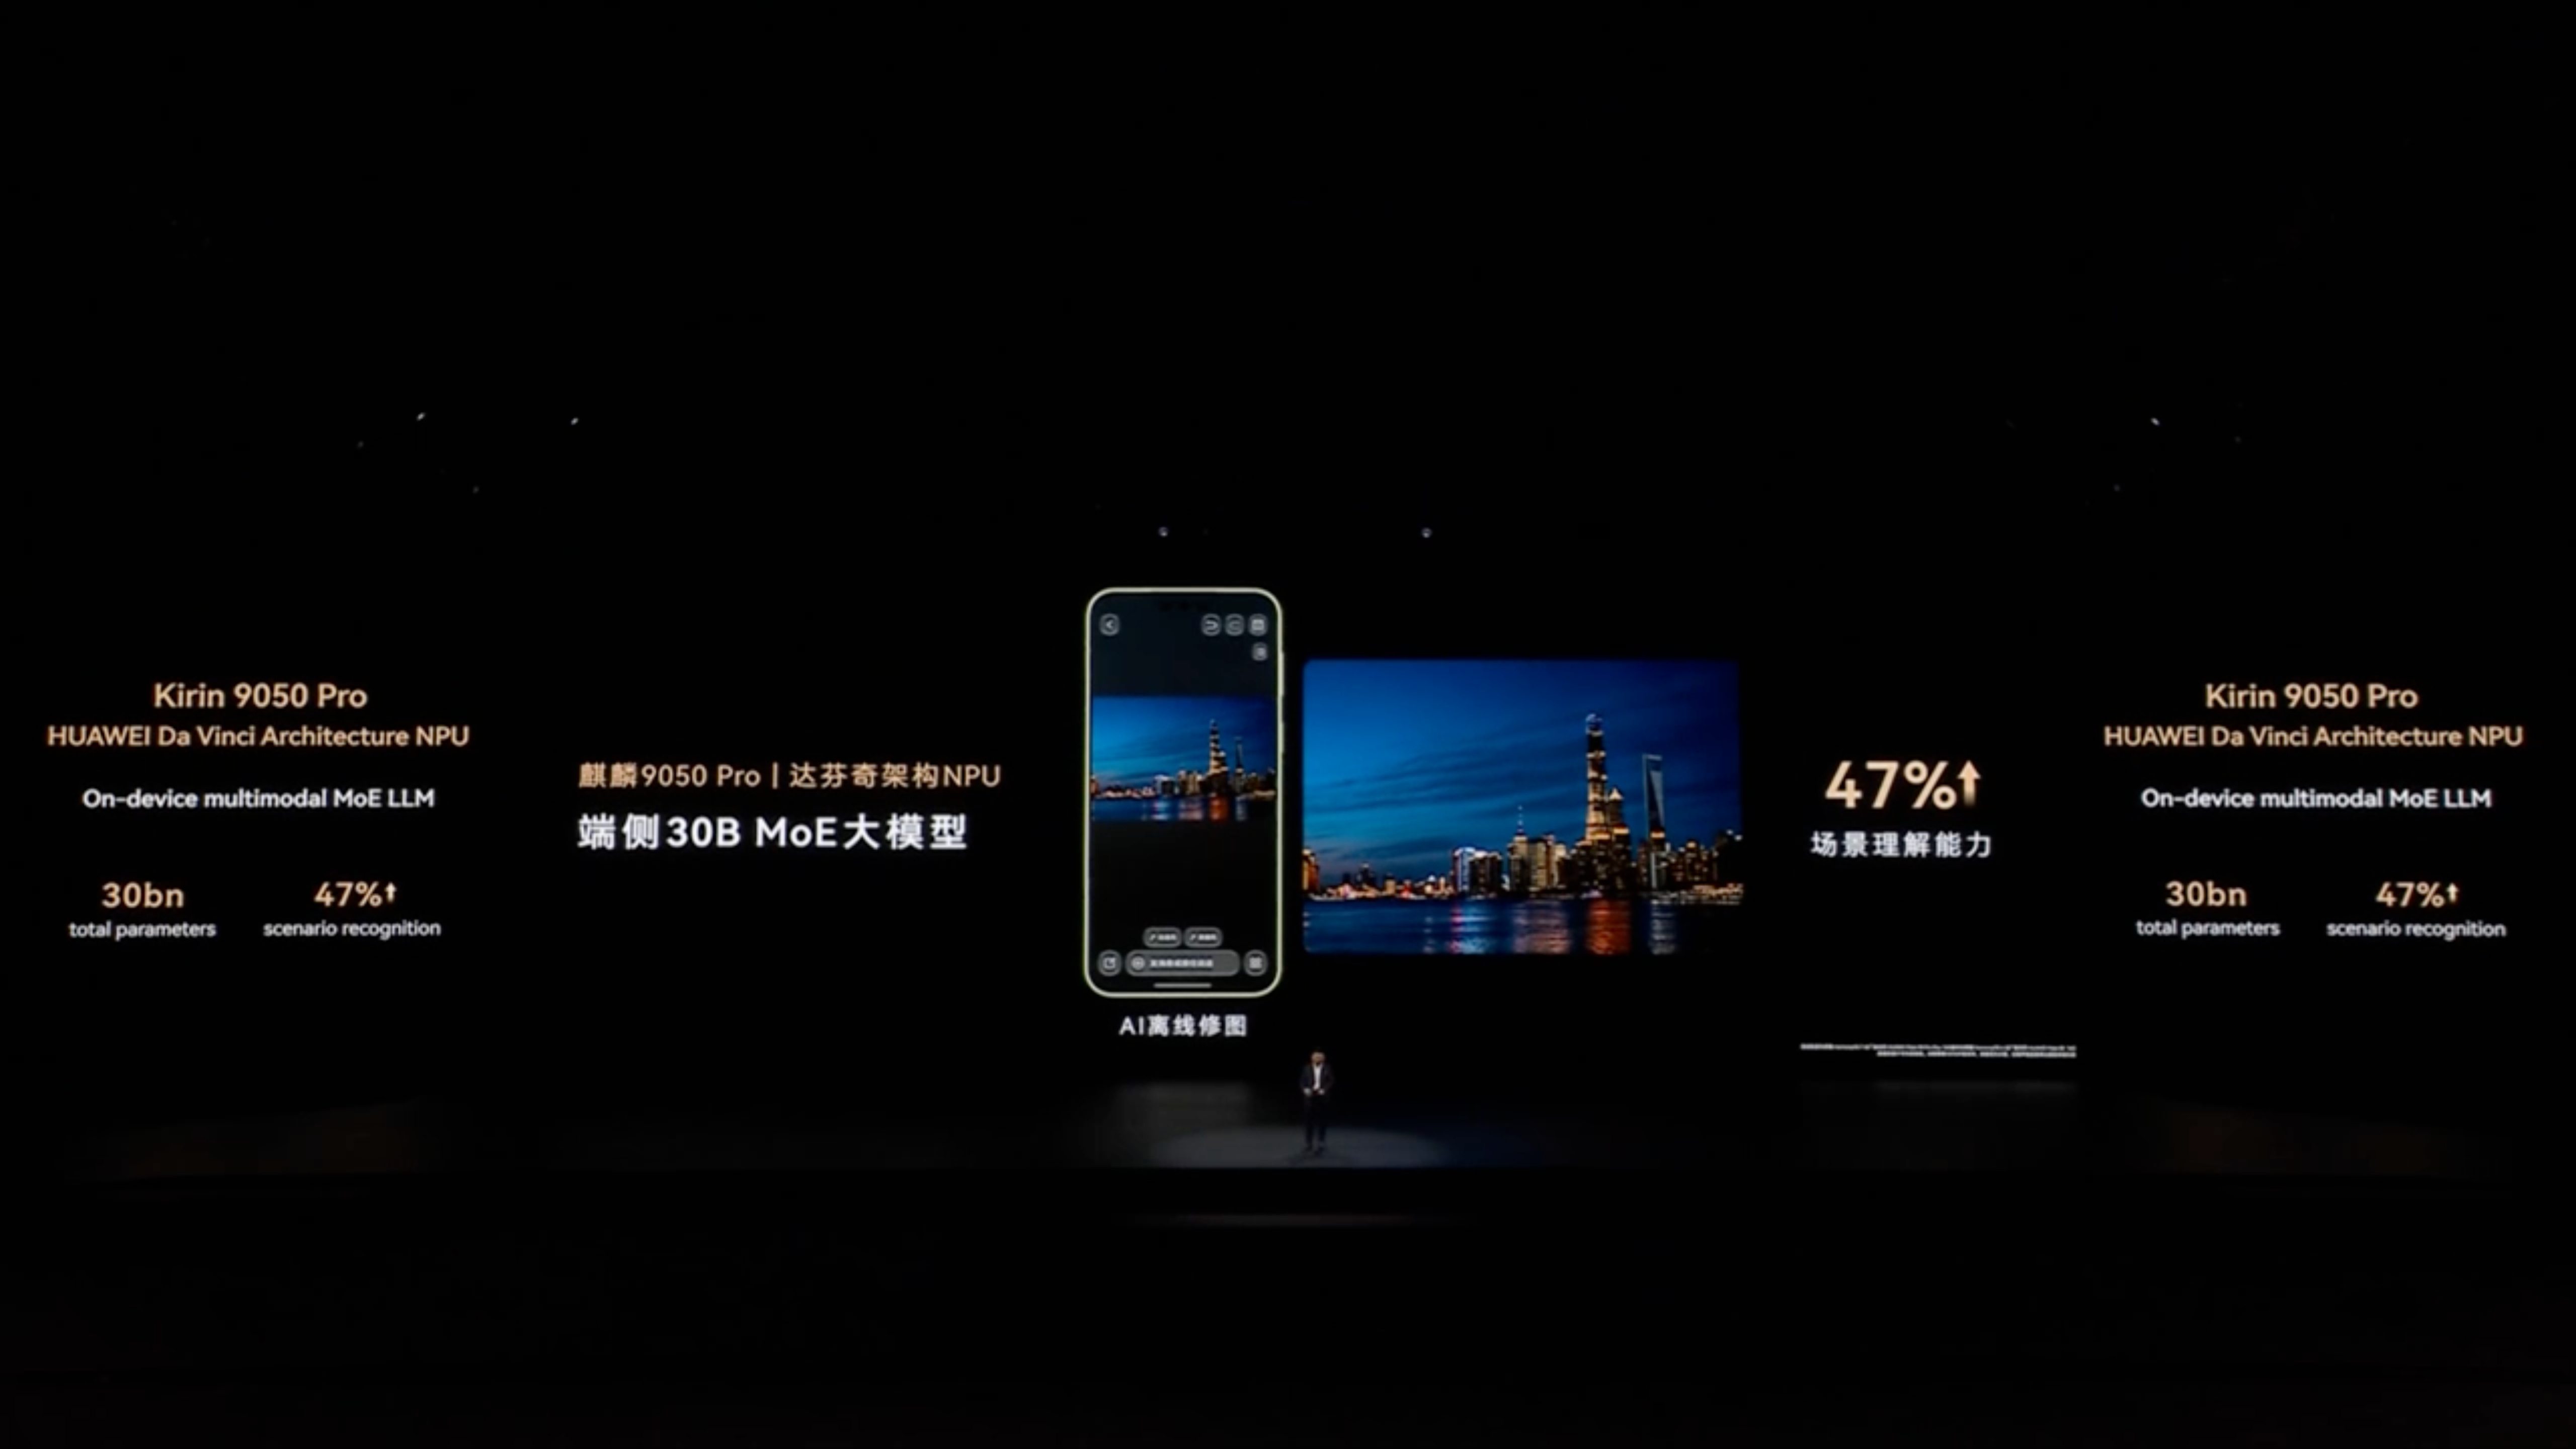
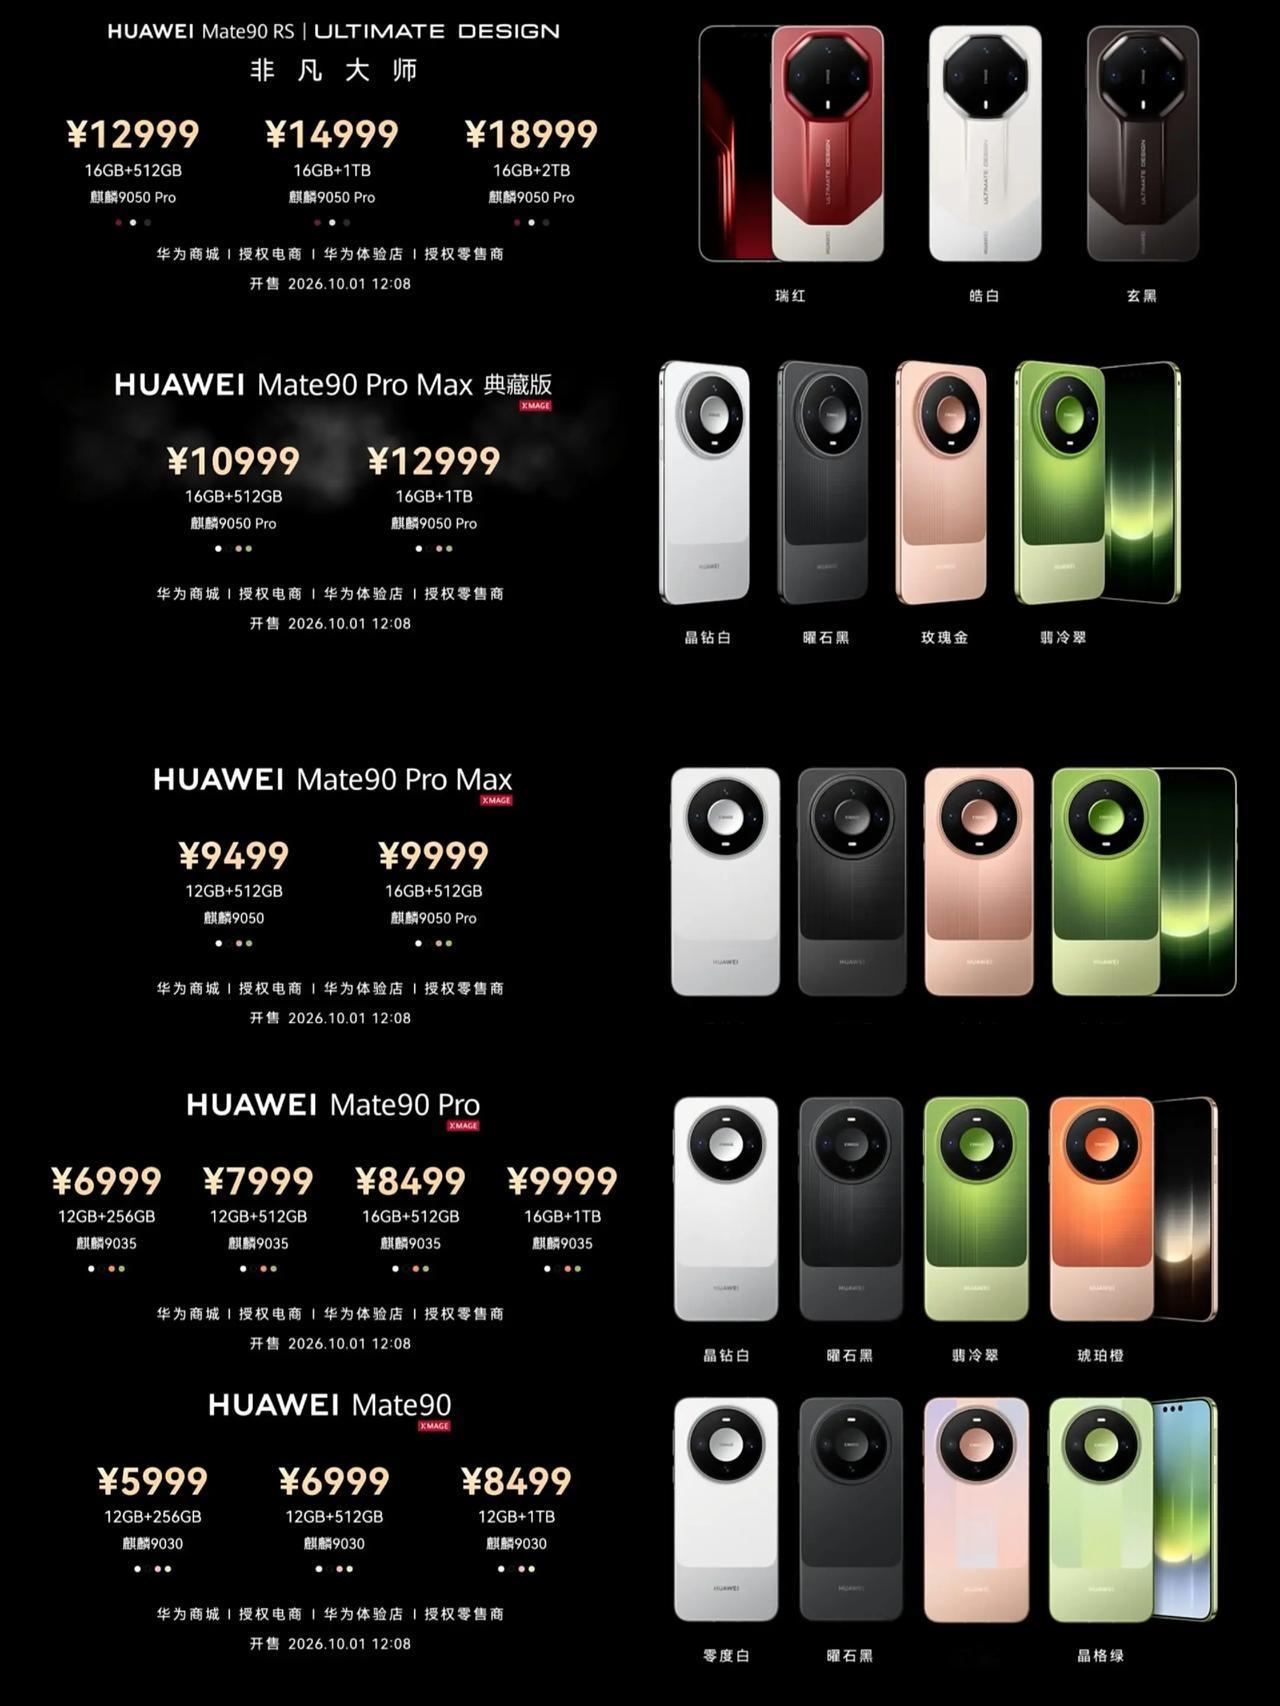
最近刚买了一台Mate90 Pro Max,早上拿着华为发布会“端侧30B MoE大模型”的截图问我:这个是不是很厉害?
30B就是300亿参数。第一眼看,确实有种“这么大的模型,手机怎么装进去”的感觉。
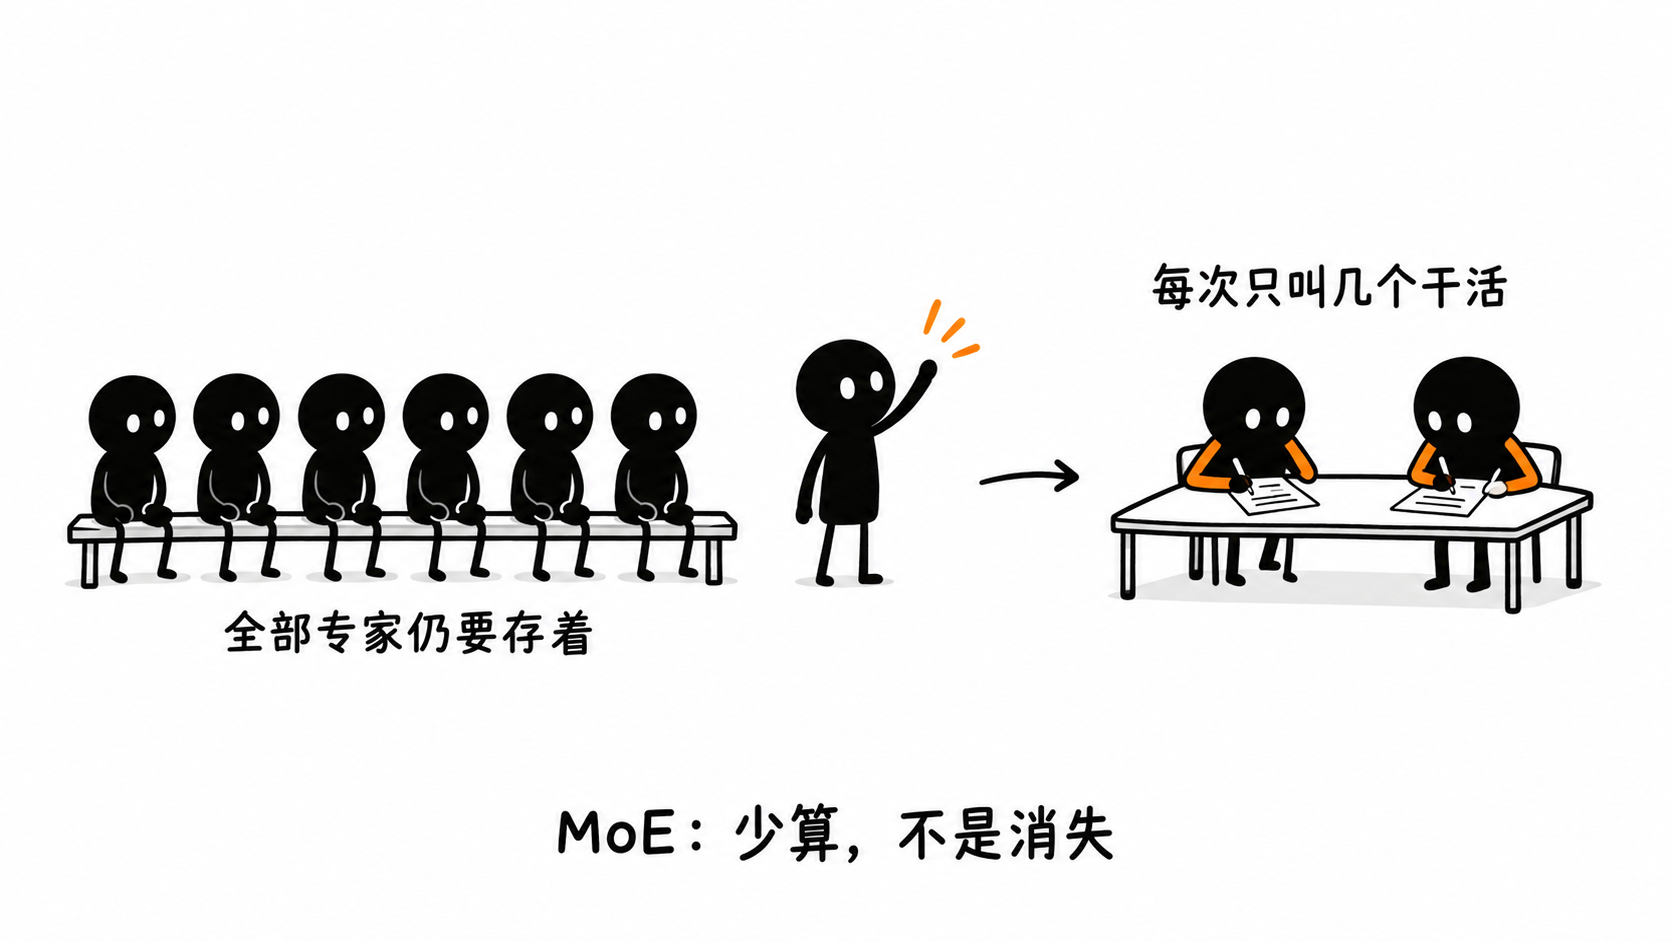
关键词:MoE,混合专家模型。
可以理解成公司养了很多专家,每次碰到一个问题,只叫其中几个来干活。总参数很大,每次参与计算的参数却少得多【图3】。
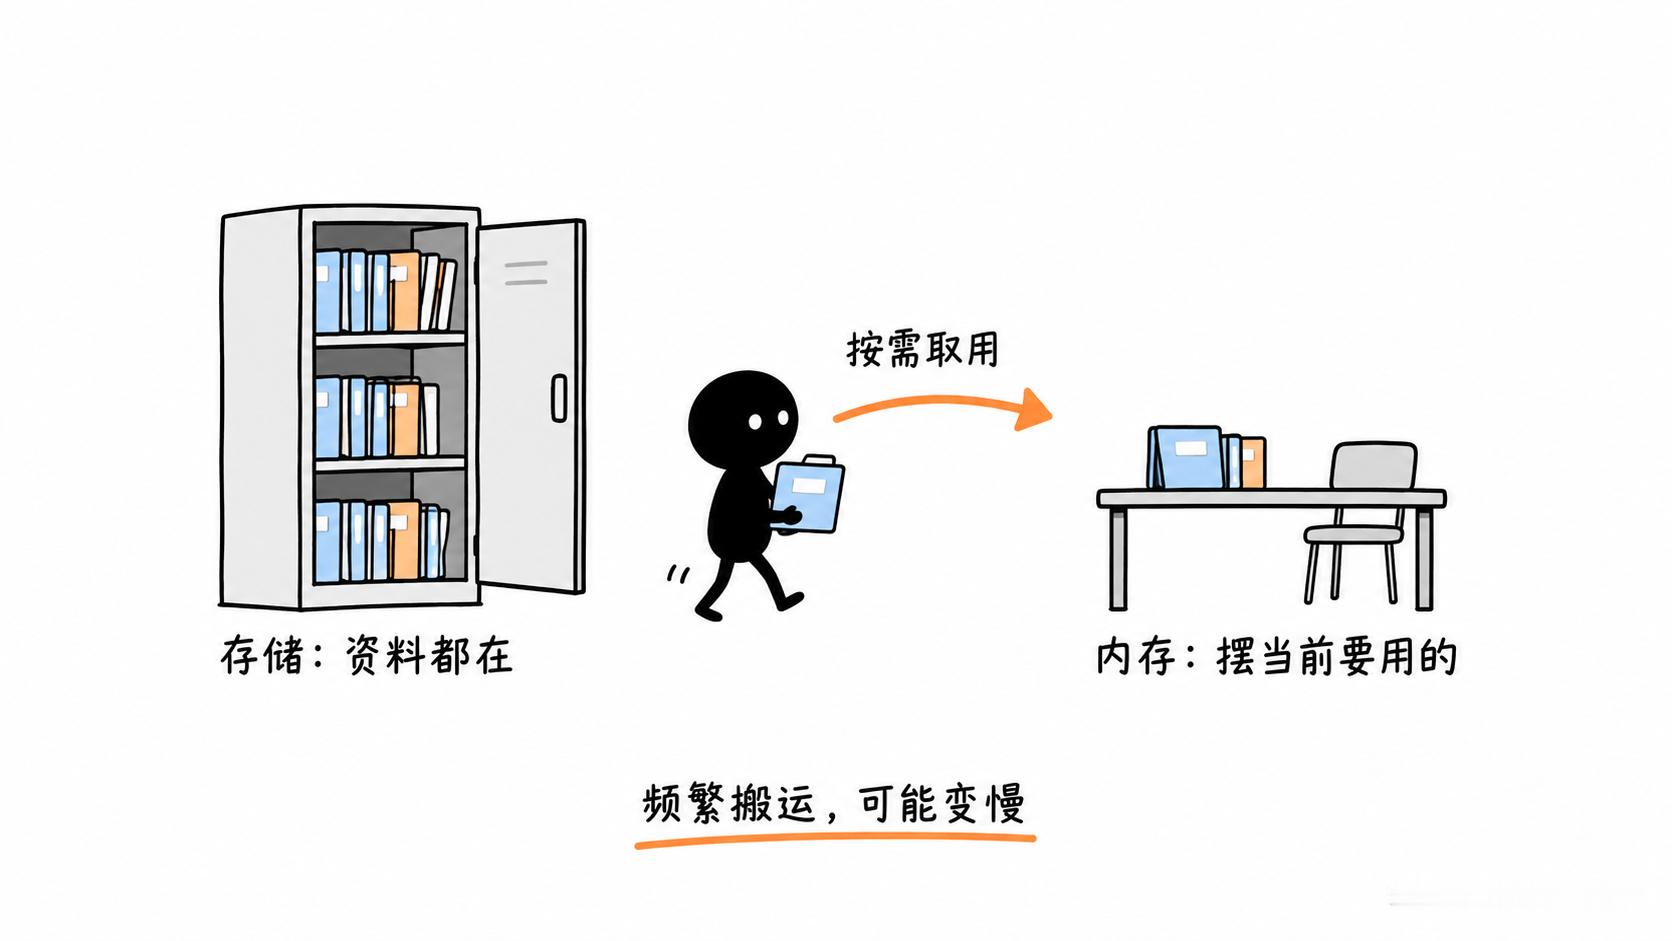
总经理办公室只有5个座位,但只要不在里面开全员会议,就还是够用的!不过,其他专家也得有工位、资料也得有地方存,需要的时候还得拿得过来。
DeepSeek也走这条路线。完整版V3和R1有6710亿参数,每个token激活约370亿,激活比例约5.5%。华为这张图里的30B也是总参数,每次并不是激活全部。
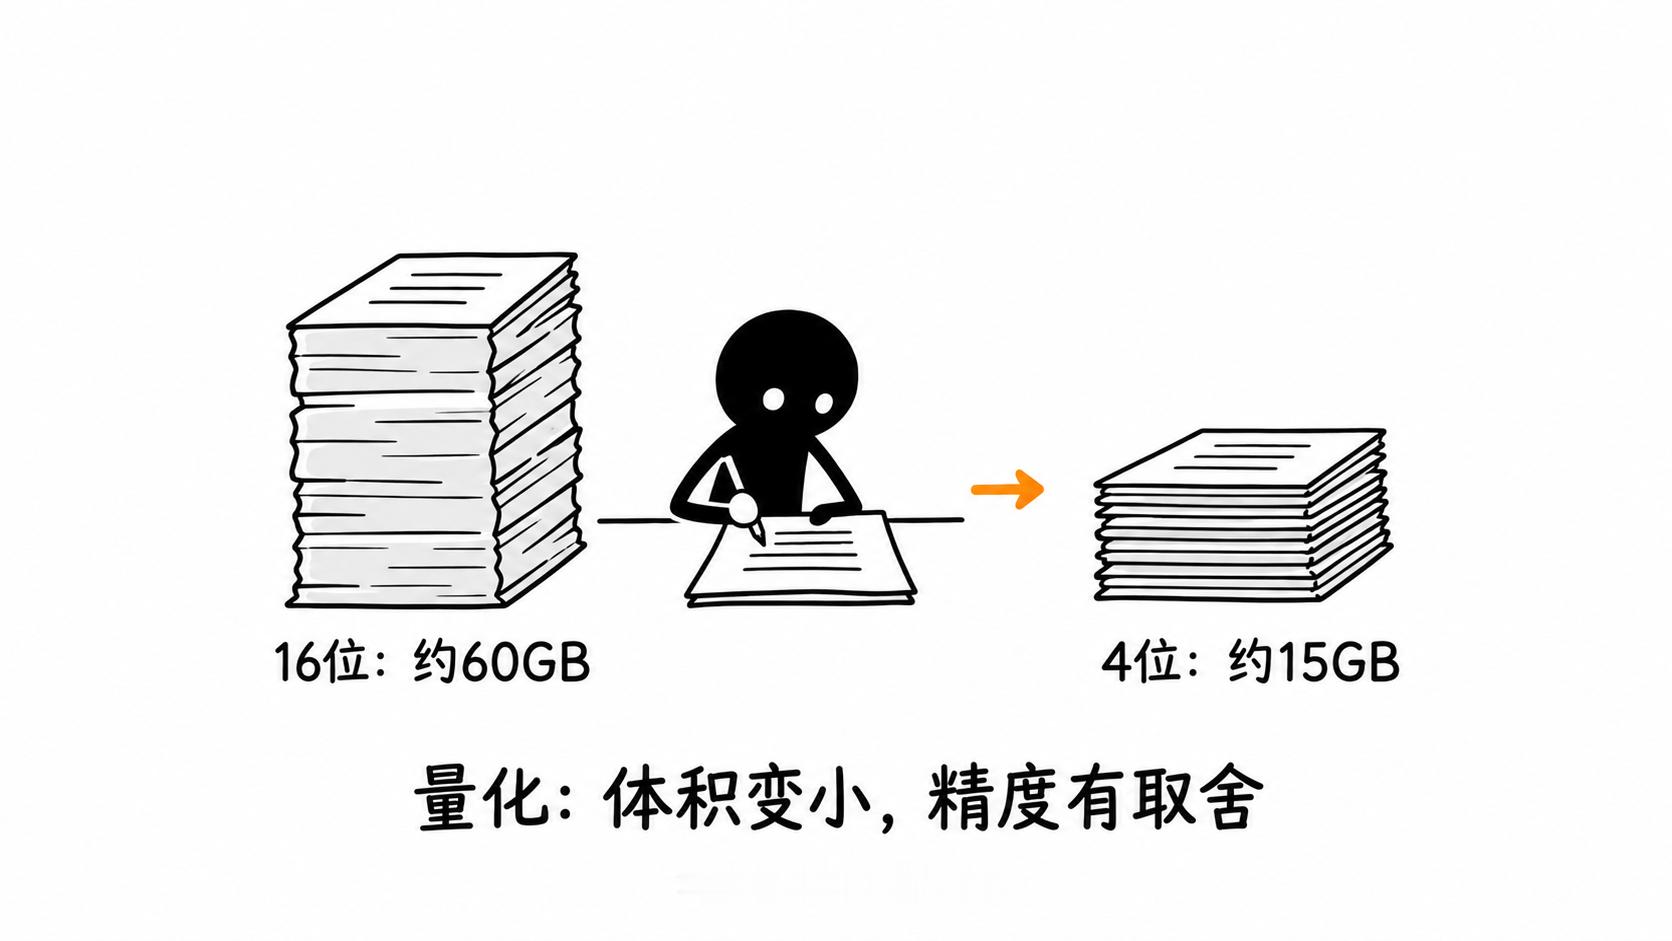
那300亿参数到底有多大?单算权重,按16位精度存,大约60GB;即使压到4位,理论上也有15GB。
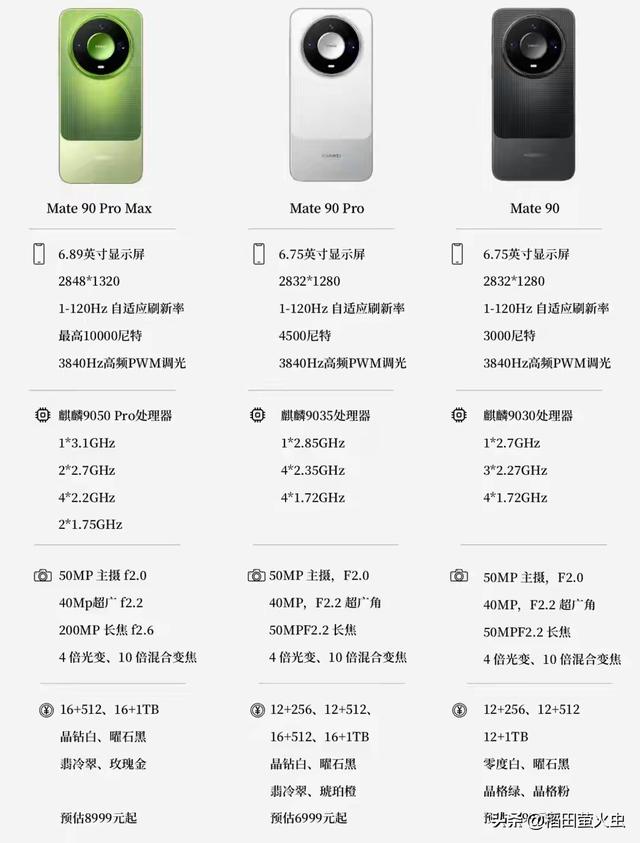
对照Mate90 Pro Max的12GB/16GB运行内存,就知道这件事的难点了:手机还得运行系统和其他应用,不能把所有空间都给模型。
所以,小王问“是不是很厉害”,确实是挺厉害的!以前得送到云端处理的修图,现在可以在手机上离线完成,飞机上没网也能用。华为mate90promax抗博女团