关于利用ML模型和AI来汉化漫画这件事。目标:一边读,一边汉化就完成了。
首先最省事的自然是,能够翻译,自带视觉,能够生成图片,并且严格编辑图片文字的服务,满足这些能力的首当其冲就是Gemini和GPT。缺点:太费钱费力,这两位都不算便宜,而且每张图片的处理时间随随便便都会超过1分钟,光是处理一卷漫画(通常在200页左右),就会花掉一下午的时间,成本也可能会上百。而且有比较高的概率会不小心修改到除了文字以外的其它地方,非常偶尔文字本身也会出现奇怪的乱码。需要重新抽卡,于是就更贵更花时间了。
那么接下来自然就会着目于免费开源的本地模型。很遗憾的是,目前没有一个普通用户能跑的本地模型,能够满足上述所有需求,更别提速度问题了。于是在本地,汉化这个工作需要细分。1. 检测对话框的位置和大小2. 把对话框里的文字识别出来3. 把识别出的文字丢给翻译服务4. 巧妙去除原图文字,留下空白5. 嵌字排版
对于任务1,我们可以用图像识别ML模型。也就是我们已经很常见的那种识别人脸,识别物体的模型。我们需要让它能够精准识别漫画的对话框的位置和大小,以便之后为嵌字和修图服务。好在这方面的进展已经非常成熟,甚至有人专门为漫画识别做了校准微调。仅仅需要几十MB的模型,就能在95%的情况下准确识别,甚至只需要10-20毫秒。对于用电脑自动翻译漫画这项任务,这里的时间成本和算力成本低到可以忽略不计。但也有缺点,目前这种识别无法进行准确描边,它只能用一个方块勾勒出大概范围。不过在大部分情况下,这都可以满足需求。这里推荐RT-DETR small模型,仅仅需要20MB和十几毫秒级的速度,就能完全满足对话框识别任务。
任务2. 上面仅仅是识别对话框的位置和大小,里面到底写了什么字,图像识别模型是做不到的,于是我们需要识别文字。这个领域叫OCR,这个领域也比较成熟,如果是普通文字的话精准率都能达到99%以上。可惜漫画不仅仅有普通文字,不仅仅有艺术加工过的夸张文字,还会有故意被物体和任务挡住一点的文字。这点实在没什么办法,并不可能对各种艺术加工做适配。在这一点上,带有视觉能力的聪明LLM还是比较无敌。这里也有人对日文漫画做过专门的OCR模型,叫MangaOCR,大约200MB.但实测起来其实感觉有点过时,mangaOCR不仅文件大,而且仅能识别日文。另一方面更加通用的PP-OCR不仅支持50多种语言,模型大小也就只有50MB左右。mangaOCR对日文的识别率虽然感觉高一点,但基本上差别不大。两者的时间花费也是几十毫秒的级别。
任务3,翻译。这一步就是最简单,但也最难的一步...完全就是汉化这一任务的瓶颈。使用传统机翻的场合,首先质量就很差...而且讲不定这些翻译服务现在还比AI贵。使用AI的场合,最主要就是慢,就算用最快速的模型,关闭思考,一句话的翻译一来一回也至少需要两三秒。用本地模型也是一样,甚至还更笨。等它翻译完一页,很多时候这一页我都读完了,于是我就得等它继续翻译完成。实在想不出什么办法.....
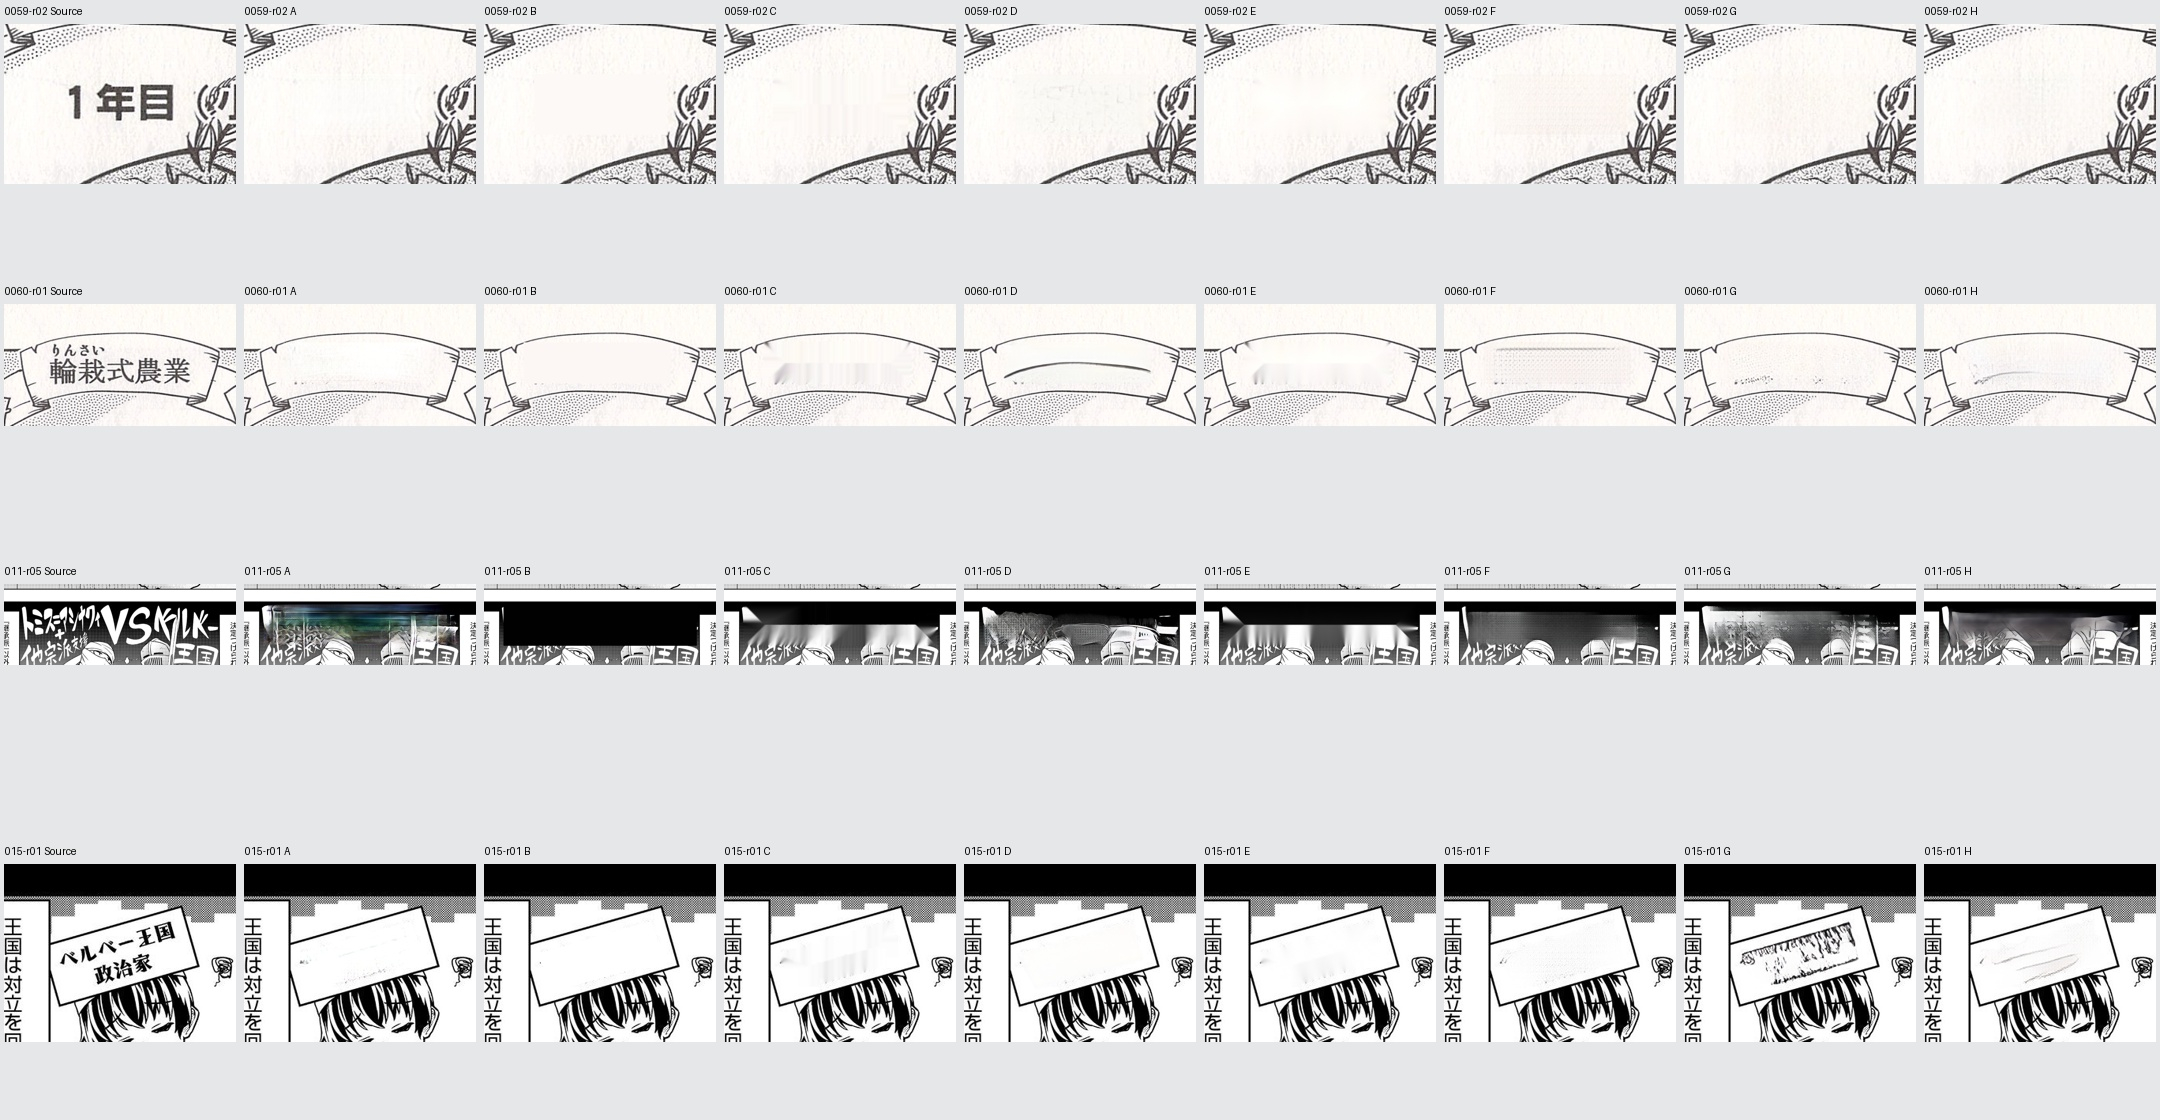
任务4,去除原图文字。这一步也是难点,难在质量把控。这一步我们有两种办法,传统图片处理,和ML的inpainting模型。首先传统图片处理,最简单又快的办法就是把第一步识别出的方框位置涂白就完了。当然这经常会导致一个圆形对话框外面突出来一个大方块,甚至经常会遮盖掉一些其它画面,各位常读漫画的应该也记得一些嵌字君嫌麻烦就拉个白色大方块。如果单纯追求速度的话,倒是可以忍受。如果同时要追求质量的话,写算法,让传统图片处理去适配各种奇形怪状的对话框....只能说基本不太可能了。这里就只能依赖ML的inpainting模型。所谓inpainting模型,各位应该也见过,就是那种你把图片的某个部分涂掉,然后AI会自动给你填上合适的内容,或者单纯扩大图片的那种AI模型。这里就比较微妙了,目前本地能运行的inpainting模型几乎没有能百分百达到人工优秀嵌字的能力,总会有些地方像是有涂涂抹抹的痕迹。然后关于速度,大概在0.5秒到2秒之间。加上之前AI翻译的几秒,这下真的做不到一边读一边就汉化完了。但如果你愿意稍微等一等,而且不介意有些瑕疵的话,倒是也能用。inpainting的模型就基本上是大小速度和能力成正比了,Anime/Manga Big-LaMa这一模型大约200MB,速度大概是1.5秒一张。质量算比较好。想要更加追求速度,接受更多瑕疵的话,AOT-GAN和MIGAN都可以试一试。二者大概就几十MB.
任务5. 嵌字排版。诶呀终于迎来了简单的一步。你只需要注意文字排版就行了,你也看过吐槽的吧,去掉逗号和句号,记得从上到下从右往左读,千万不能用从左往右从上到下的读法噢~不然会被挂上网(?)
好了,到此为止你完成了一个汉化漫画的自动化工序。运用3-4个不同的ML模型,汉化精准度和质量大概在80%上下,在理想情况下达成大概10-30秒一张图的速度。或者运用单一个聪明的云端LLM,汉化精准度和质量大概在95%上下,达成2-5分钟一张图的速度。感觉两者都有点微妙地不实用。
看来AGI还是任重道远,汉化组的大佬们还是不可或缺的。当然汉化组的你,或许可以参杂一些步骤,稍微修改一下下,就能更加快速完成任务噢~