日本古书界正在经历现代版的“焚书坑儒”!只不过“秦始皇”变成了美国那些AI公司。
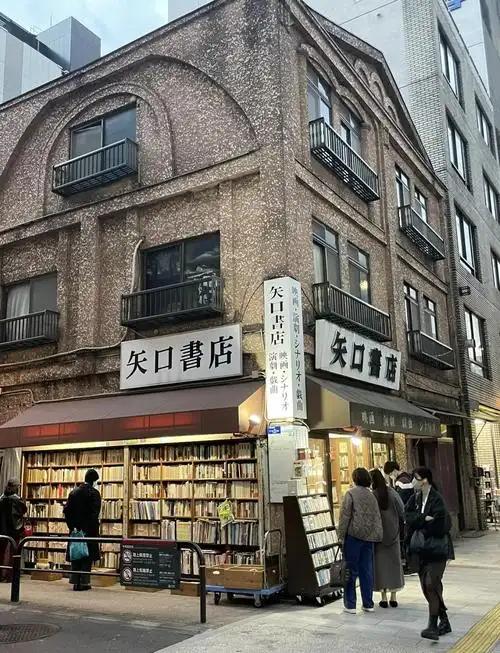
2026年8月前后,日本东京神田神保町的古书店街,还有各地做线上生意的旧书商,突然接到一批批蹊跷订单。
买书的不看作者、不问版本、不在乎品相,哲学、历史、医学、法律照单全收,连偏远地区的地方志、三十年前的政治小册子都要。
有个店主一天被扫走上百本,单店累计卖出超过一千册。多个下单账号各用各的名字,但所有包裹最后全指向同一个地方——冈山县的一个跨境物流中转站。
紧接着日本电视台把数据挖出来了:从去年开始,超过50吨日本二手书被出口到了美国。按一本书500克算,整整10万册。
日本书籍出版协会随后给出版批发巨头日贩发了书面文件,要求说清楚:你们是不是把书卖给了美国AI公司Anthropic,里面有没有协会成员出版社的书?
日贩那边回答得也干脆:个别交易,不予回答。
很快,这件事情就被网友扒出了底细。原来是美国的那些巨头AI公司,开始搜集市面上的古典文集。
那为什么这些公司偏偏盯上日本旧书?原因特别实在,就一条:大模型快没东西可吃了。
过去几年,硅谷把互联网上的公开文本扒了个底朝天。维基百科、论坛、新闻、社交平台,能爬的全爬了。
权威机构Epoch AI的预测说得很直白,互联网上高质量的人类文本数据,大概在2026年前后就要用光了。
更麻烦的是网上剩下的东西已经不能吃了。
2025年4月有机构分析了90万个新建英文网页,七成四都含AI生成的内容。剑桥和牛津的研究人员在《自然》上发过论文,AI用AI生成的数据反复训练自己,迭代几代之后输出的东西就成了毫无逻辑的胡话。
说白了,大模型吃互联网,已经吃不出营养了,再吃下去就自己把自己吃废了。
那什么东西还干净?2022年之前出版的纸质书。这些书没被网络垃圾污染过,排版规整,OCR识别率高,里面全是人类一字一句写出来的真东西。
对AI公司来说,这就是高纯度的训练原料。
但光有原料还不够,还得解决一个要命的问题——法律风险。
Anthropic这家公司此前就被作家告过。
它从盗版网站下载了超过700万册书的电子版用于训练,结果吃了集体诉讼。2025年6月,加州联邦法院的法官明确裁定,盗版数据不适用“合理使用”,侵权成立。
但同一个法官又说了另一层意思:合法购买的纸质书,拿去做破坏性扫描,扫描完把原书销毁,只保留数字版本用于内部训练,这个行为属于“格式转换”,可以算合理使用。
这个判决等于是给AI公司开了一条路。
从那之后,Anthropic搞了一个代号“巴拿马计划”的项目,专门批量收购二手书。操作流程非常工业化:液压切割机切掉书脊,书页送进高速扫描仪,扫完的原书直接打碎销毁。六个月能处理50万到200万本书。
而日本旧书,恰好是这条路线上最优质的货源。
日本孤悬海外,一千多年避开了大量战火,保存了东亚地区海量的纸质文献。从江户时代的“兰学”翻译到明治维新后的西方文献译介,日本积累了大量排版规整、纸张优良的专业书籍。
这些书买回来扫描,成本低、识别快、数据质量高。而且很多是绝版书,市面上流通的每一本都是孤本,扫完就没第二份了。
所以,这笔账算得很清楚:跟出版社一家一家谈授权,又慢又贵;去二手书市场扫货,便宜、快,法律上还有判例撑着。
日贩为什么愿意卖?它自己的出版批发业务正在亏钱,2026年3月期决算显示取次事业部门录得36亿日元经常赤字,社长都公开说在考虑从取次事业撤退。
这时候来一个大买家,返品风险为零,现金回笼快,换成谁都很难拒绝。
所以这条链条的逻辑非常清楚:日本的书店老板赚了小钱,日贩赚了流水,Anthropic拿到了干净的训练数据。
这还没算另一层账。日本的书里包含大量关于东亚历史、地理、社会制度的一手记录,尤其地方志和行业报告,记录的是地名沿革、产业变迁、灾害记忆这些东西,网络上是找不到替代品的。
Anthropic把这些数据扫进自己的模型,模型学完之后,日本人自己要用这些知识,反而得去问美国的AI。
日本人自己也在反思。有学者把这件事比作现代版的“焚书坑儒”——书不是被烧了,是被切成碎纸打成浆了,结果一样,内容没了,原书也没了。
而且这次干这事儿的不是暴君,是一家估值上千亿美元的硅谷公司,手里攥着法院的判决书,程序上一点毛病都挑不出来。
反观咱们这边,中文古籍和地方文献的数字保护工作一直在推进。中华书局基于高质量古籍数据训练了“古文大模型”,德州学院也搞出了面向古籍版面整理的多模态大模型“春秋”。
同样是让AI学古书,咱们走的是先数字化、再训练、原件妥善保存的路子。日本人这次是被人连锅端了才反应过来。
你觉得日本这50吨书被拉走,是正常的商业买卖,还是被人抄了文化老底?