这下美国媒体再也没法保持乐观了,短短半年之内,中国科研团队直接超越了他们刚刚大肆庆贺的技术里程碑。
今年 3 月,斯坦福研发的 Merlin 模型亮相《自然》期刊,这套系统可以在腹部 CT 影像当中识别出 30 类病症。
当时这一成果发布时,海外媒体足足热闹了好一阵。作为全球首个适配3D腹部CT的视觉语言大模型,Merlin摆脱了传统AI依赖人工标注病灶的限制,靠一万五千余份临床CT影像与配套诊断报告,实现了30种腹部病症的识别,被业内公认为通用医疗影像AI从概念走向现实的里程碑。
谁都没料到,这个被捧成年度突破的标杆,仅仅半年就被中国团队大幅刷新。
9月18日,阿里巴巴达摩院联合浙江大学医学院附属第一医院等机构研发的通用医疗影像AI模型DAMO RADAR,正式登上国际顶级学术期刊《科学》。
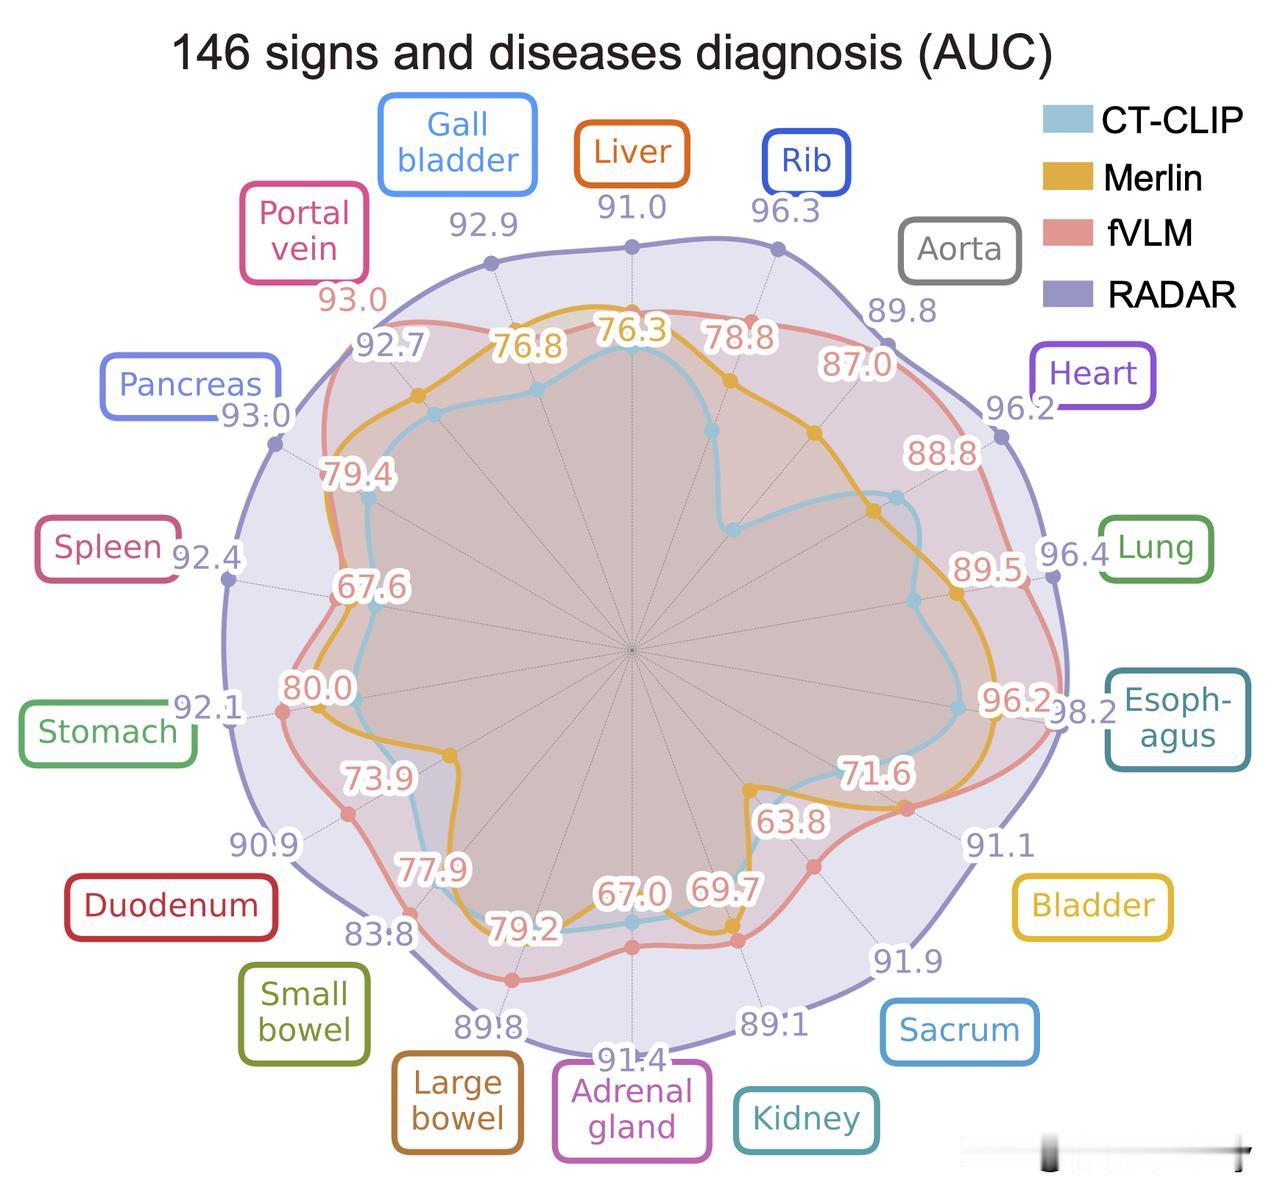
同样针对腹部增强CT场景,它能一次性识别146种病症,覆盖18个人体腹部器官,诊断平均准确率达0.913,是全球首个达到影像科专家级水平的通用医疗影像模型,且已同步面向全球开源。
从30种到146种,数字翻了近五倍的背后,是技术路线的本质升级。腹部CT是临床影像诊断中最复杂的场景之一,一张片子涵盖十余个器官、数百种潜在病变,有效信号稀疏,读片难度极高。
此前的医疗AI要么沿用“一病一模”的模式,研发成本高、适配场景窄;要么像Merlin这样完成通用方向的初步探索,但诊断精度始终达不到临床应用的标准。
中国团队首创了器官级细粒度对齐策略,把三维CT数据拆解为独立的解剖单元,让影像与诊断报告在器官层面实现精准匹配,再通过自适应对比建模,让模型直接从海量临床资料中学习读片逻辑,全程无需额外的人工病灶标注。
简单说,过去的AI是“死记病灶”,现在的AI是像医生一样“学诊断思路”,越贴近临床思维,输出的结果就越靠谱。
这一步跨越的分量,远不止病种数量的增加。30种病症的突破,更多是验证了技术的可能性;而146种病症的覆盖、专家级的准确率,直接让通用医疗影像AI摸到了临床落地的门槛。
更有价值的是团队选择了全面开源。这意味着无论是三甲医院的复杂病例,还是基层医疗机构的常规筛查,都能免费接入这套专家级的读片能力,相当于给各级临床场景都配上了永不疲惫的影像辅助工具。
半年前斯坦福用《自然》论文证明了通用医疗AI这条路走得通,半年后中国团队就用《科学》成果把标准拉到了临床可用的高度。
别人还在庆祝里程碑的时候,我们已经把下一段路的标杆立好了。医疗AI的全球竞赛,节奏正在悄悄改写。