众力资讯网
玥辰热逛科技的文章
#之行之行# 昨天看了孙浩和薛烨拍的大美新疆 盘龙公路 和雪山 和草原和沙漠 都好震撼 半夜收到大力发来的库拉岗日行程 蠢蠢欲动 那些或被文字刻录 或被拍摄流转 或被口耳相传的 山川湖泊 很想用脚去看看
2026-11-09 10:41
#之行之行# 昨天看了孙浩和薛烨拍的大美新疆 盘龙公路 和雪山 和草原和沙漠 都好震撼 半夜收到大力发来的库拉岗日行程 蠢蠢欲动 那些或被文字刻录 或被拍摄流转 或被口耳相传的 山川湖泊 很想用脚去看看
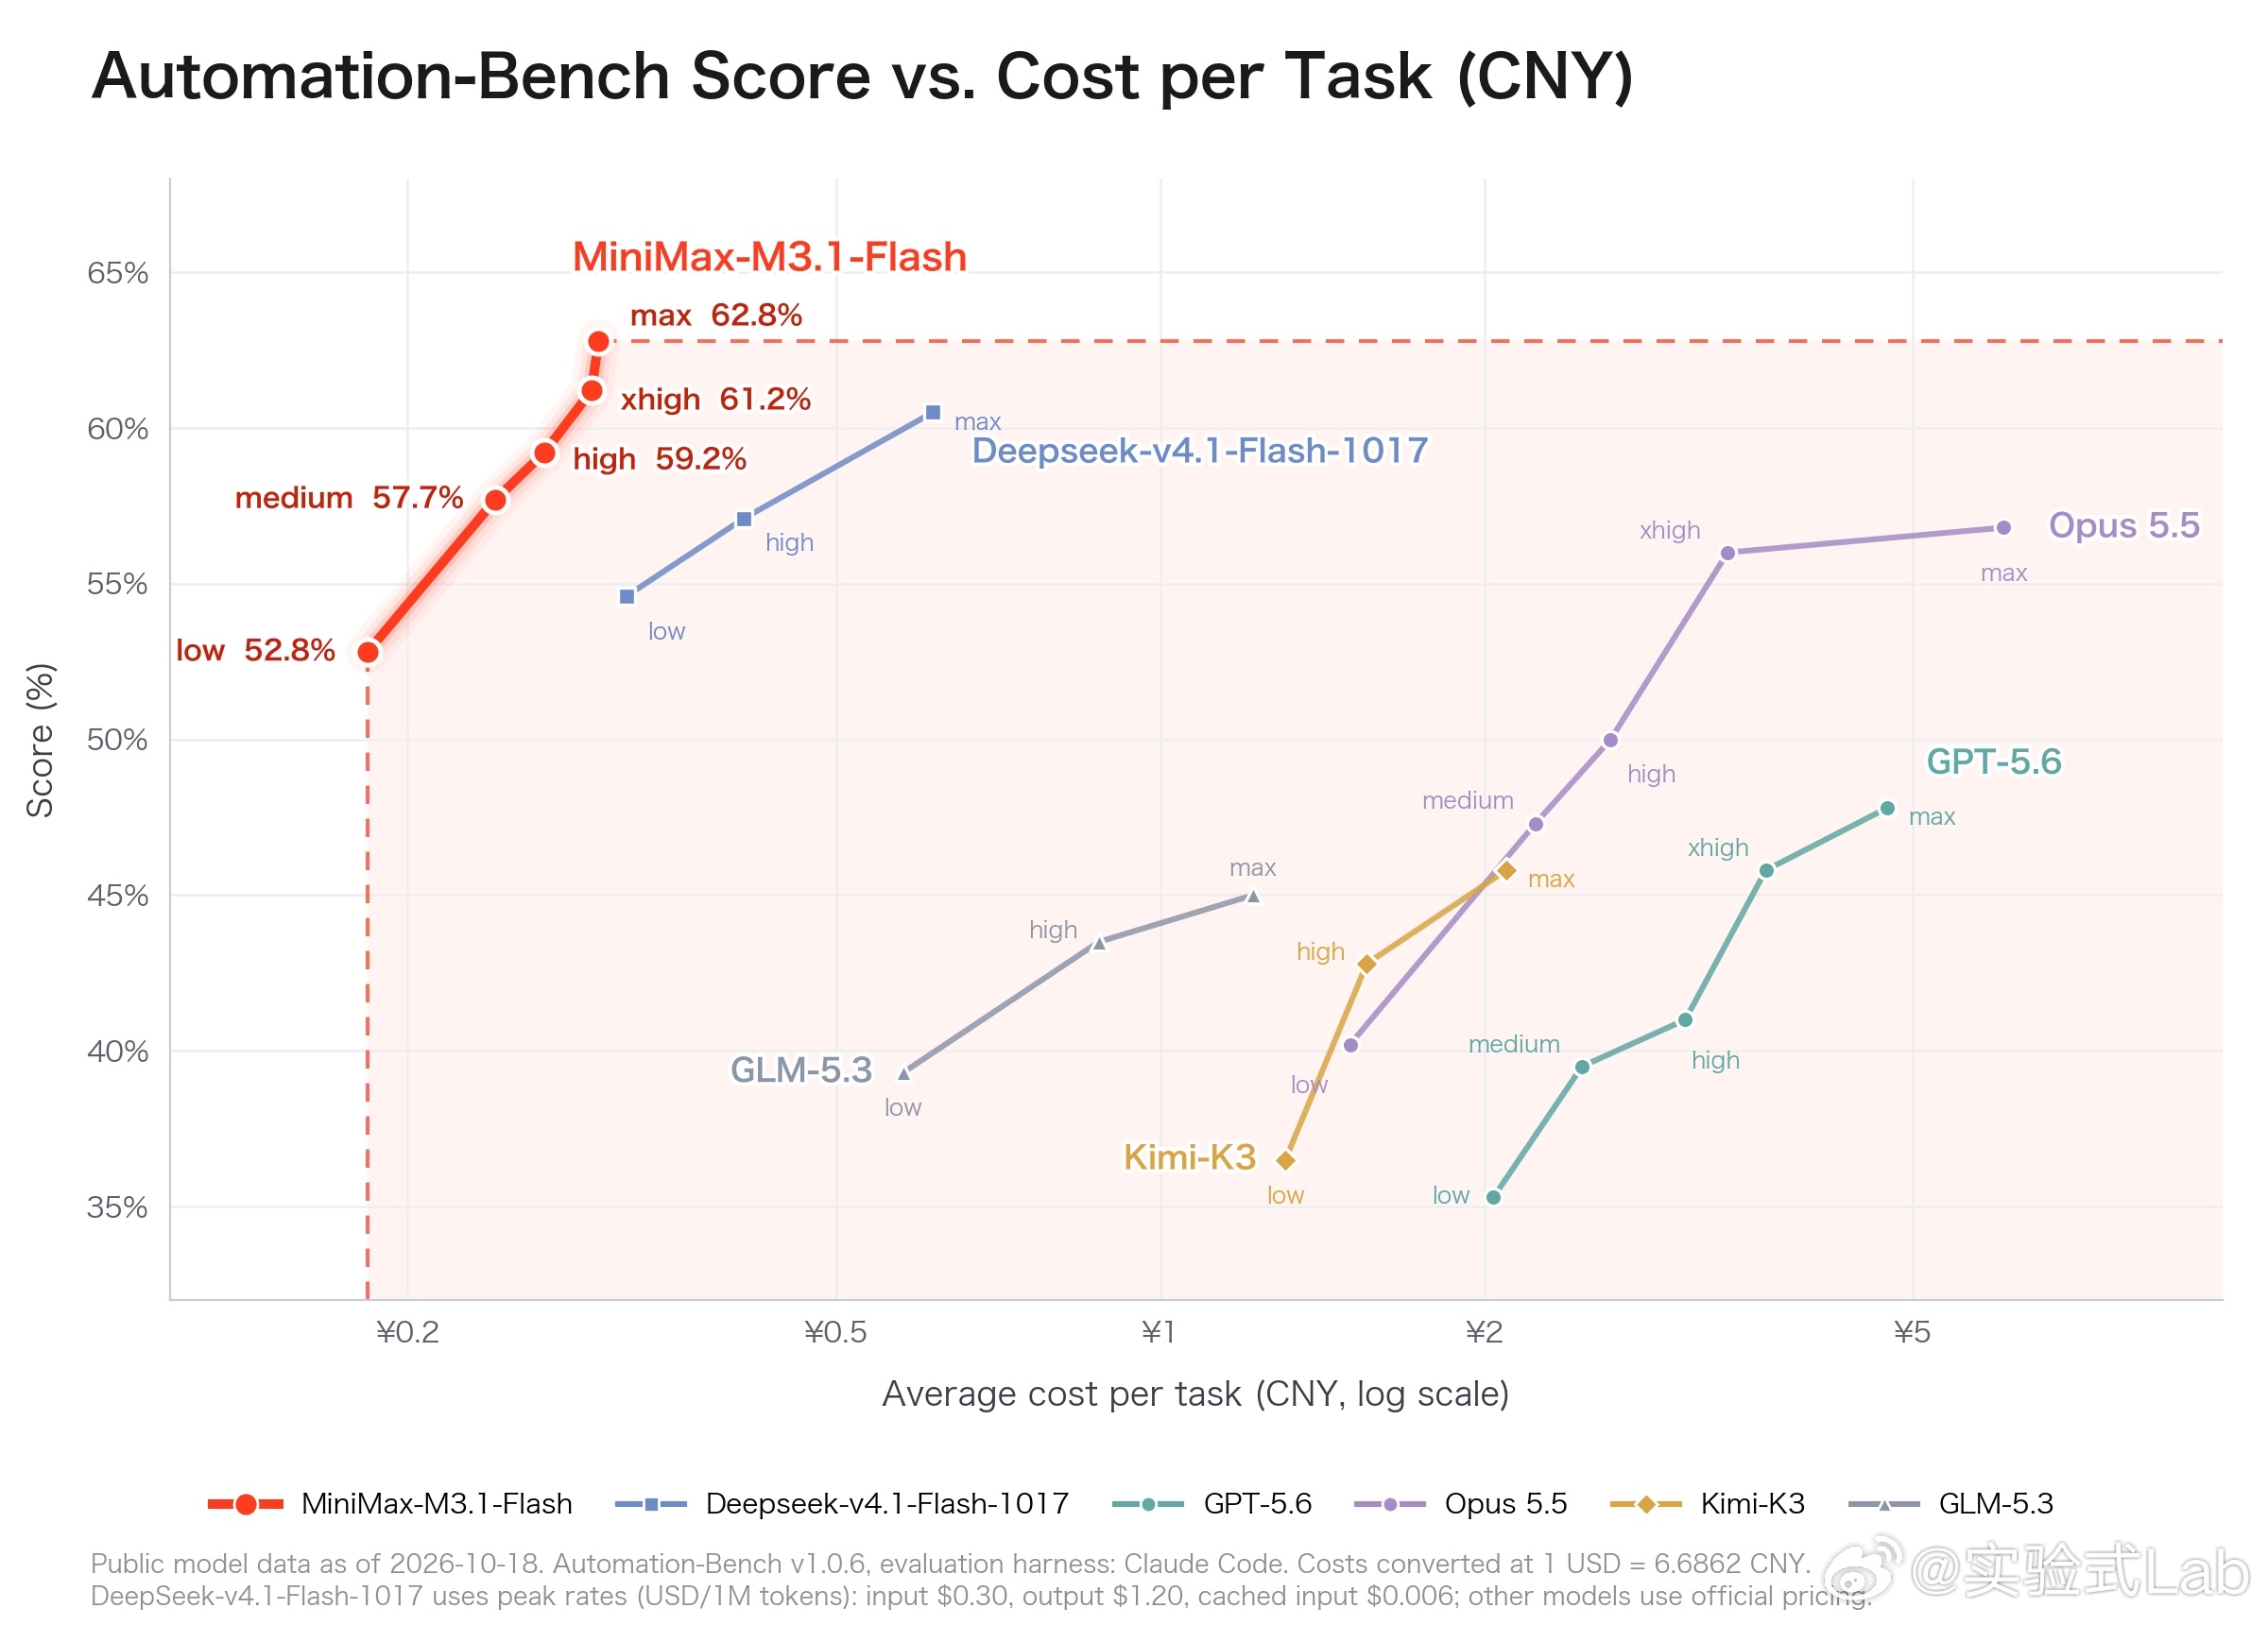
MiniMax正式发布M3.1 Flash: 10月23日开源 MiniMax发布M3.1 Flash: 10月23日开源 MiniMax 正式上线了 M3.1 Flash, 之前在榜单上以 Space Bunny 代号跑了 200T+ tokens 的底座原来就是它. 这次的核心是继续压榨性价比和 Agent 执行效率: — 计费对齐行业低位. 输入 0.15 美元, 输出 0.60 美元 / 百万
2026-10-20 00:01
MiniMax正式发布M3.1 Flash: 10月23日开源 MiniMax发布M3.1 Flash: 10月23日开源 MiniMax 正式上线了 M3.1 Flash, 之前在榜单上以 Space Bunny 代号跑了 200T+ tokens 的底座原来就是它. 这次的核心是继续压榨性价比和 Agent 执行效率: — 计费对齐行业低位. 输入 0.15 美元, 输出 0.60 美元 / 百万
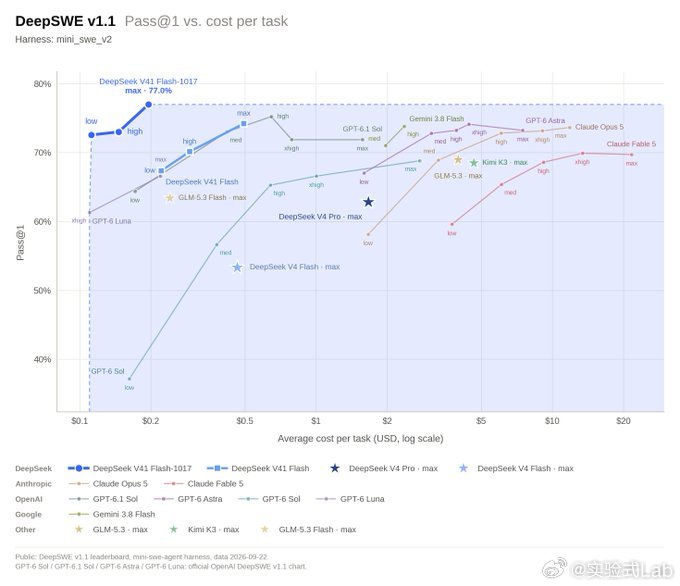
DeepSeek发布V4.1-Flash-1017: 缩减输出增效 DeepSeek 把 V4.1-Flash 的新检查点 1017 放出来了, 网页、API 和 Hugging Face 同步更新. 这次迭代的核心思路很明确: 砍掉冗余思考, 缩短输出长度, 同时拉高 Agent 任务的实际成功率. 几个关键数据: — 代码与自动化基准提升. DeepSWE 跑到了 77.0%, Aut
2026-10-17 20:56
DeepSeek发布V4.1-Flash-1017: 缩减输出增效 DeepSeek 把 V4.1-Flash 的新检查点 1017 放出来了, 网页、API 和 Hugging Face 同步更新. 这次迭代的核心思路很明确: 砍掉冗余思考, 缩短输出长度, 同时拉高 Agent 任务的实际成功率. 几个关键数据: — 代码与自动化基准提升. DeepSWE 跑到了 77.0%, Aut
#之行之行# 1️⃣我拍的 2️⃣华为的自动构图 3️⃣我改了放大倍数
2026-10-13 21:43
#之行之行# 1️⃣我拍的 2️⃣华为的自动构图 3️⃣我改了放大倍数
#郭家毅gemini[超话]# 4
2026-10-13 22:57
#郭家毅gemini[超话]# 4
#郭家毅gemini[超话]# 3
2026-10-14 08:57
#郭家毅gemini[超话]# 3
#郭家毅gemini[超话]# 2
2026-10-14 08:57
#郭家毅gemini[超话]# 2
#郭家毅gemini[超话]# 1
2026-10-14 08:57
#郭家毅gemini[超话]# 1
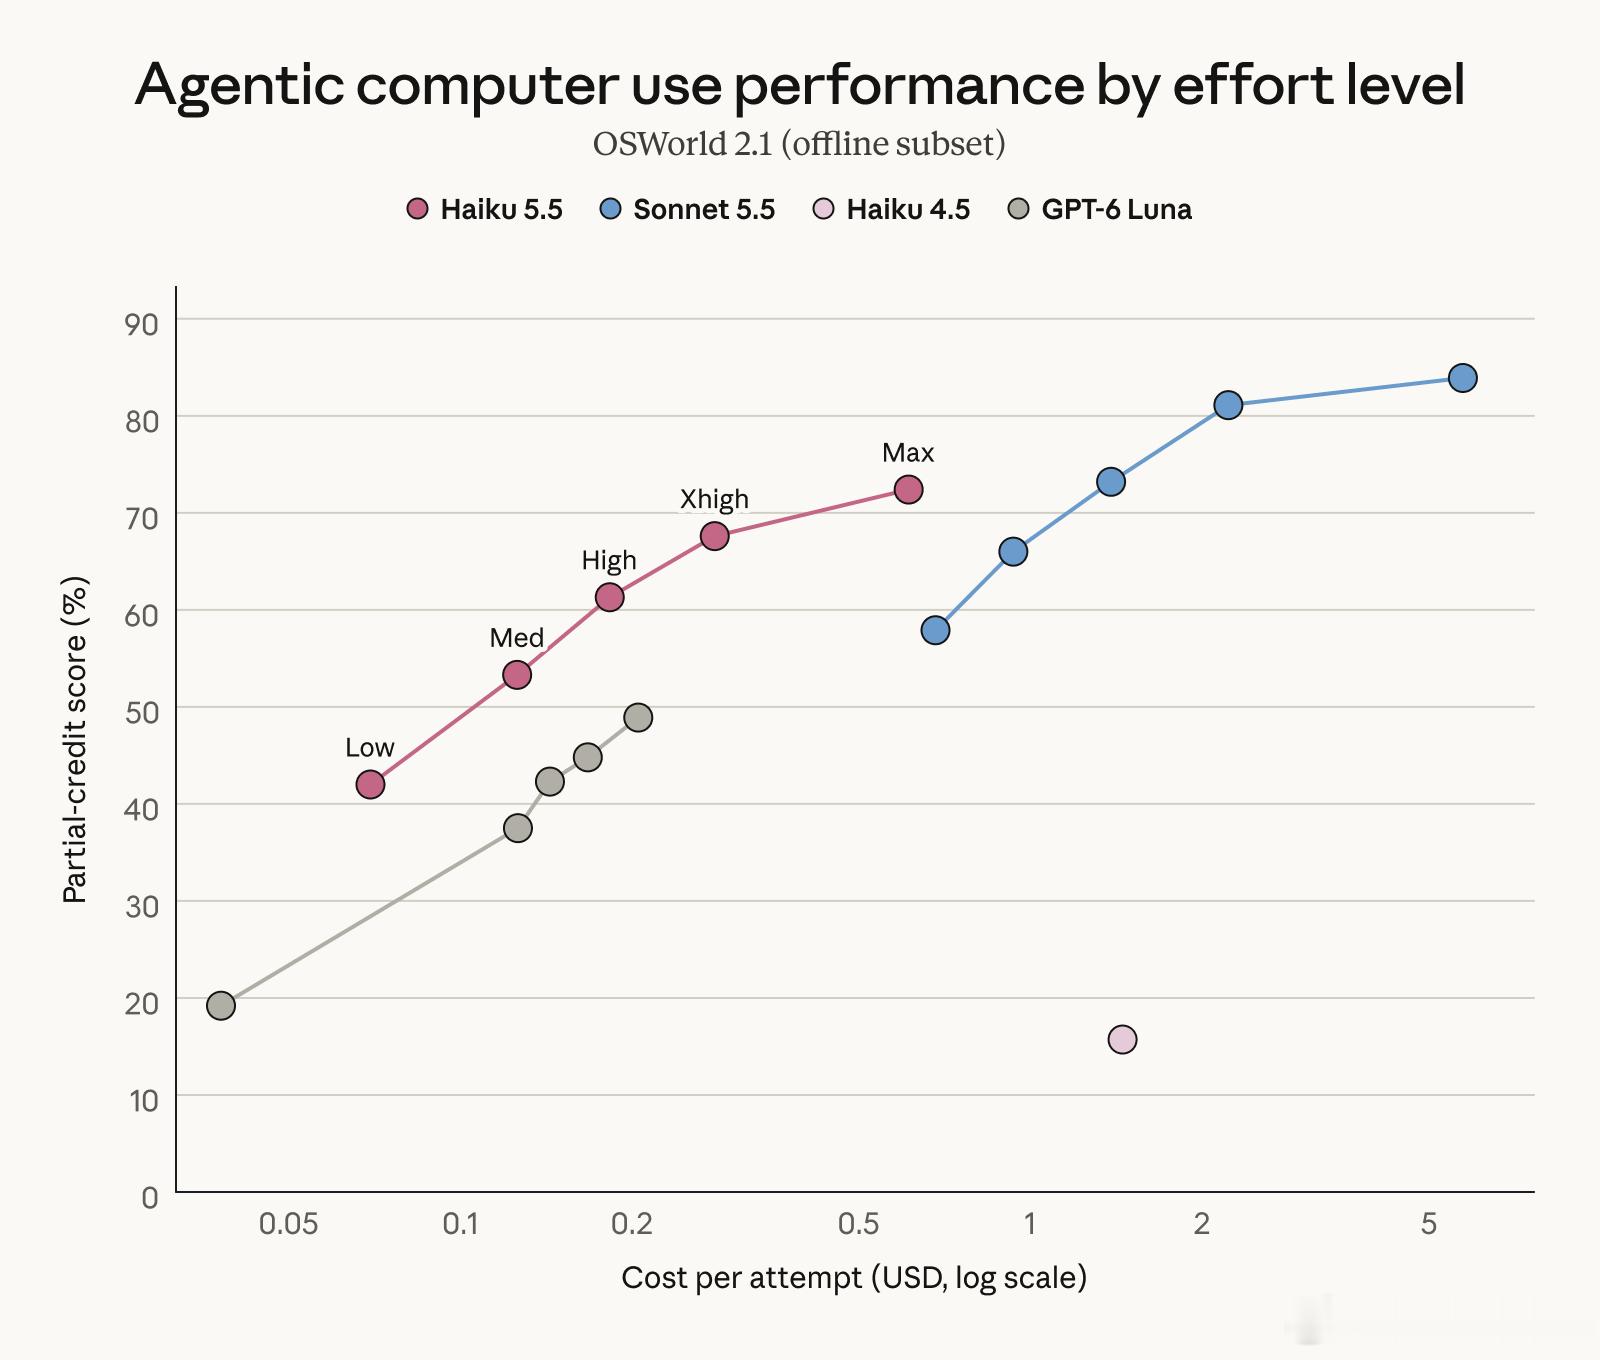
Anthropic发布Claude Haiku 5.5: 成本暴降75% Anthropic 把 5.5 系列的小杯 Haiku 5.5 放出来了. 这次改动最实在的就是把常规场景的调用成本彻底打碎了: — 阶梯式大幅降价. 针对 100k 以内的常规请求 (占历史流量 90%), 输入直接降到 0.10 美元, 输出 0.50 美元 / 百万 tokens. 比上一代 4.5 便宜了
2026-10-08 10:01
Anthropic发布Claude Haiku 5.5: 成本暴降75% Anthropic 把 5.5 系列的小杯 Haiku 5.5 放出来了. 这次改动最实在的就是把常规场景的调用成本彻底打碎了: — 阶梯式大幅降价. 针对 100k 以内的常规请求 (占历史流量 90%), 输入直接降到 0.10 美元, 输出 0.50 美元 / 百万 tokens. 比上一代 4.5 便宜了
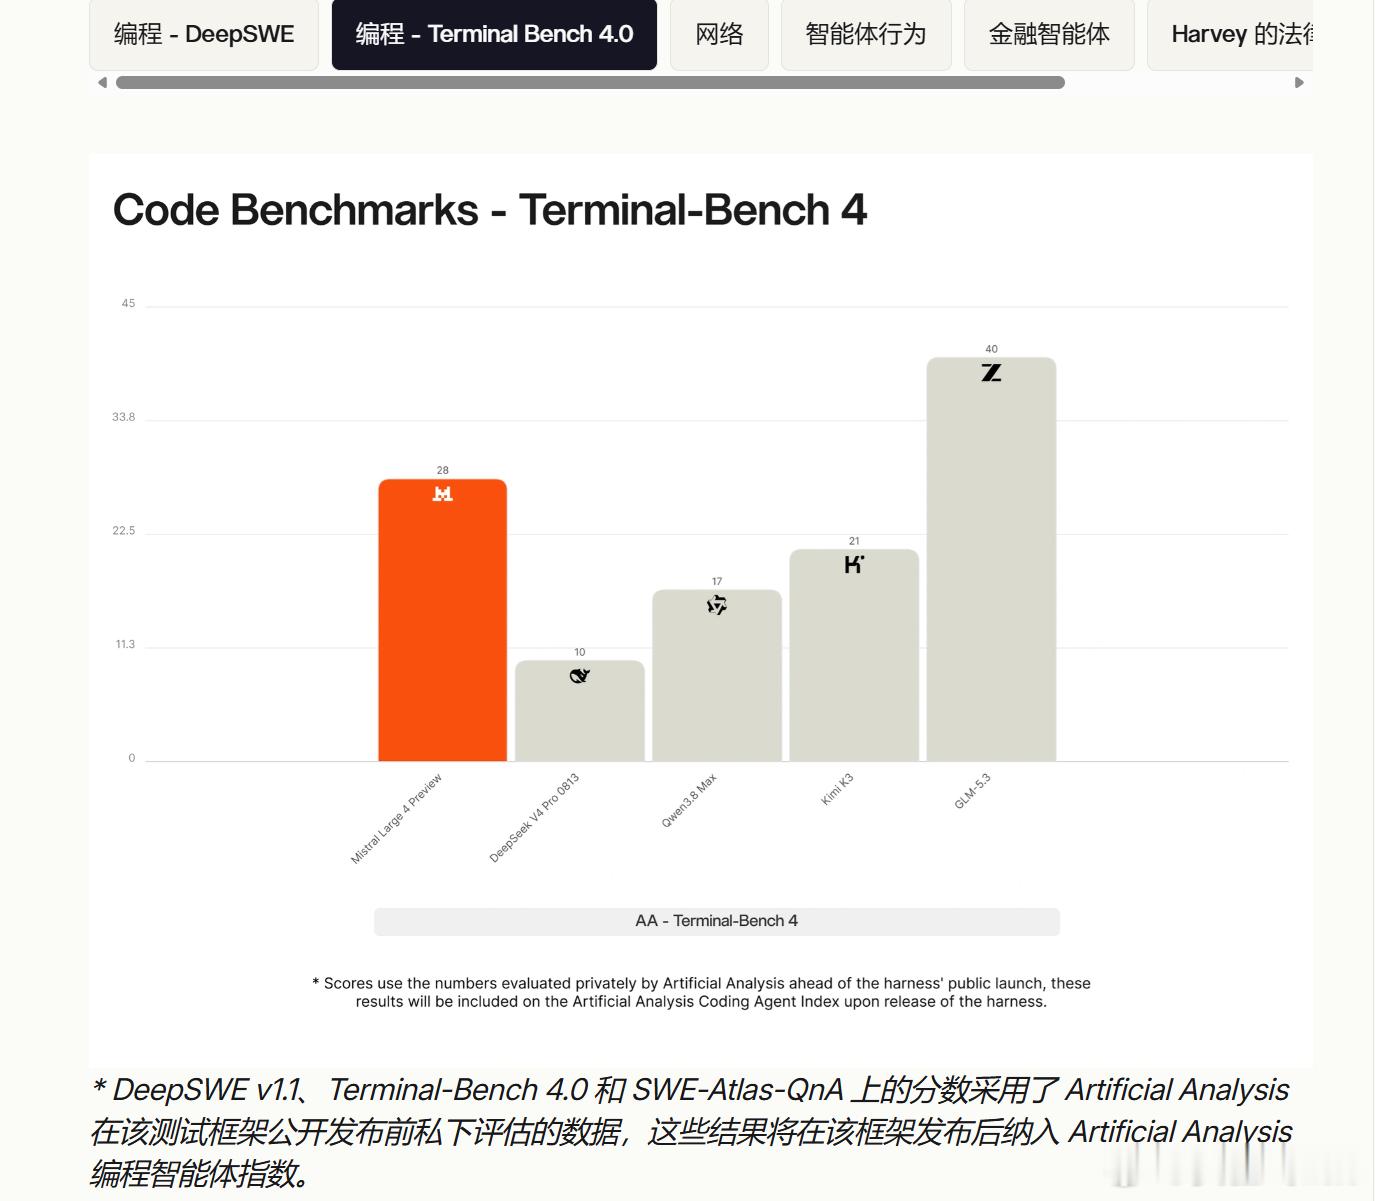
Mistral发布Large 4: 1T参数MoE与欧陆算力 Mistral 发布了 Mistral Large 4, 内部代号 Le Chonk. 规格推到了 1T 总参数, 49B 激活的 MoE, 原生多模态. 49B 这个激活量级基本成了目前超大 MoE 架构的行业标准切分点了. 官方的定调很有意思: 宣称是“欧美综合基准里最好的开放权重模型”, 措辞比较严谨
2026-10-07 13:22
Mistral发布Large 4: 1T参数MoE与欧陆算力 Mistral 发布了 Mistral Large 4, 内部代号 Le Chonk. 规格推到了 1T 总参数, 49B 激活的 MoE, 原生多模态. 49B 这个激活量级基本成了目前超大 MoE 架构的行业标准切分点了. 官方的定调很有意思: 宣称是“欧美综合基准里最好的开放权重模型”, 措辞比较严谨
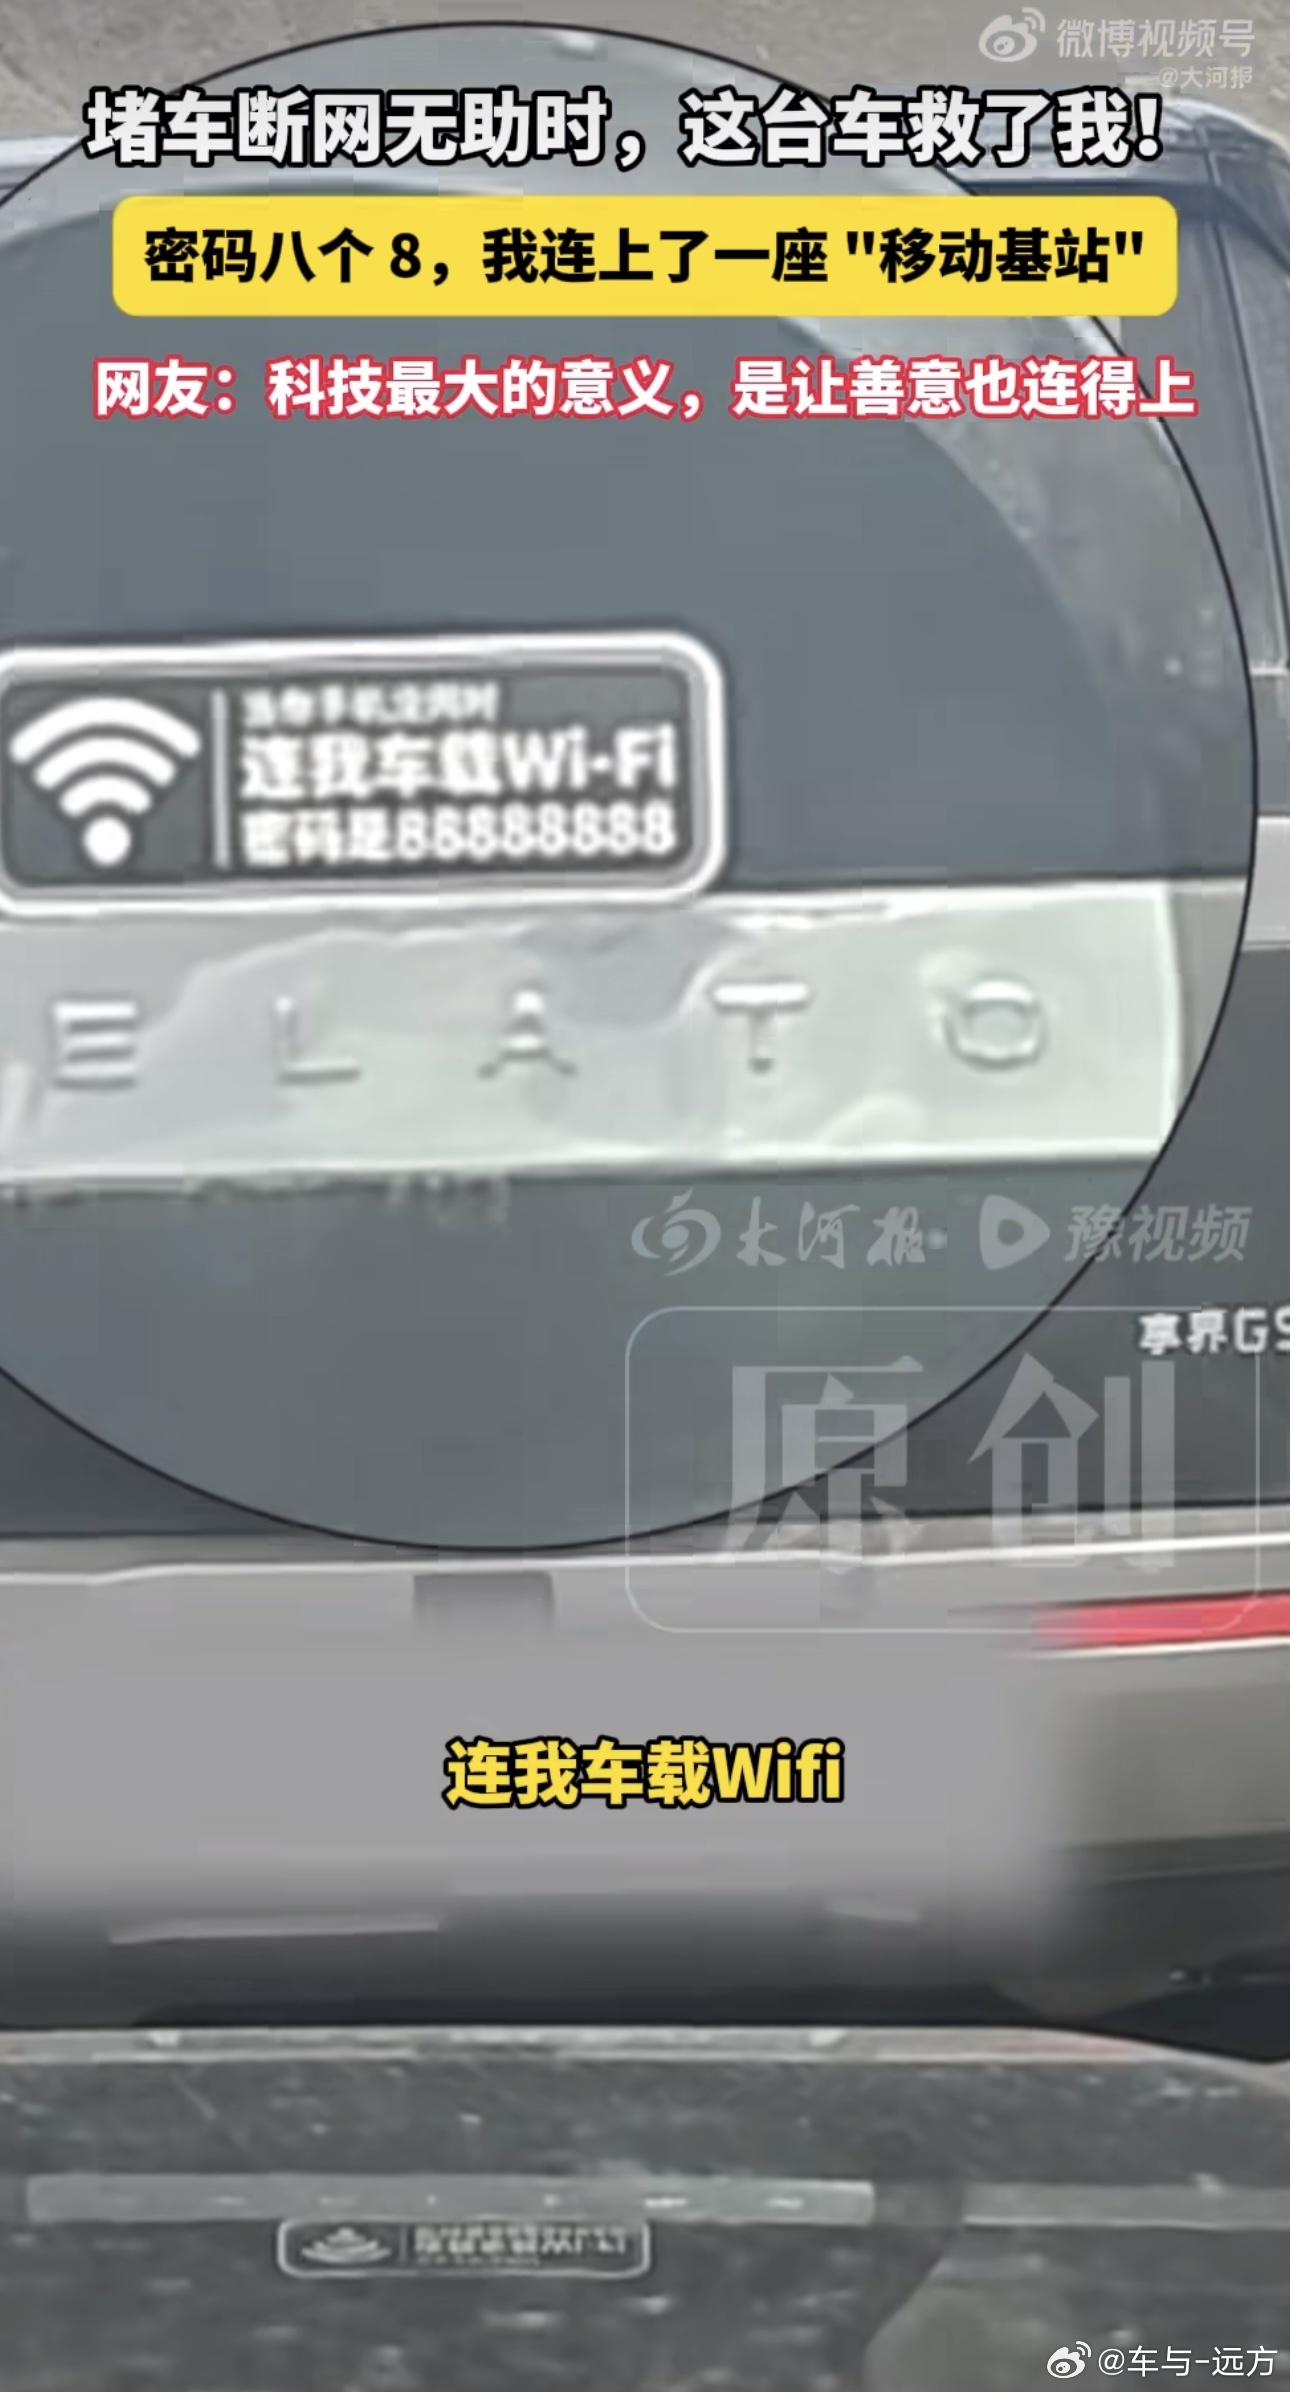
公路旅途善意持续闪光,鸿蒙智行与车主共守出行温度 长假高速车流密集,难免会出现各种突发状况。鸿蒙智行的很多车主遇到他人车辆出现状况,会主动停车帮忙;堵车间隙,互相告知前方事故点位,减少后续车辆无谓等待。这些细碎善意,汇聚成旅途里的温暖。 这类自发的车主互助行为,是非常珍贵的品牌资产
2026-10-03 05:08
公路旅途善意持续闪光,鸿蒙智行与车主共守出行温度 长假高速车流密集,难免会出现各种突发状况。鸿蒙智行的很多车主遇到他人车辆出现状况,会主动停车帮忙;堵车间隙,互相告知前方事故点位,减少后续车辆无谓等待。这些细碎善意,汇聚成旅途里的温暖。 这类自发的车主互助行为,是非常珍贵的品牌资产
美团最近悄悄上线了 1.6T 总参数、48B 激活参数的大模型 LongCat 2.5-Previe...
2026-09-30 13:14
美团最近悄悄上线了 1.6T 总参数、48B 激活参数的大模型 LongCat 2.5-Preview(龙猫 2.5),在没有公开技术报告和 Benchmark 的情况下直接开启低价促销。 这期视频我用开发者最常遇到的 3D 渲染和前端代码场景,拿它和 550B 参数的 Dee
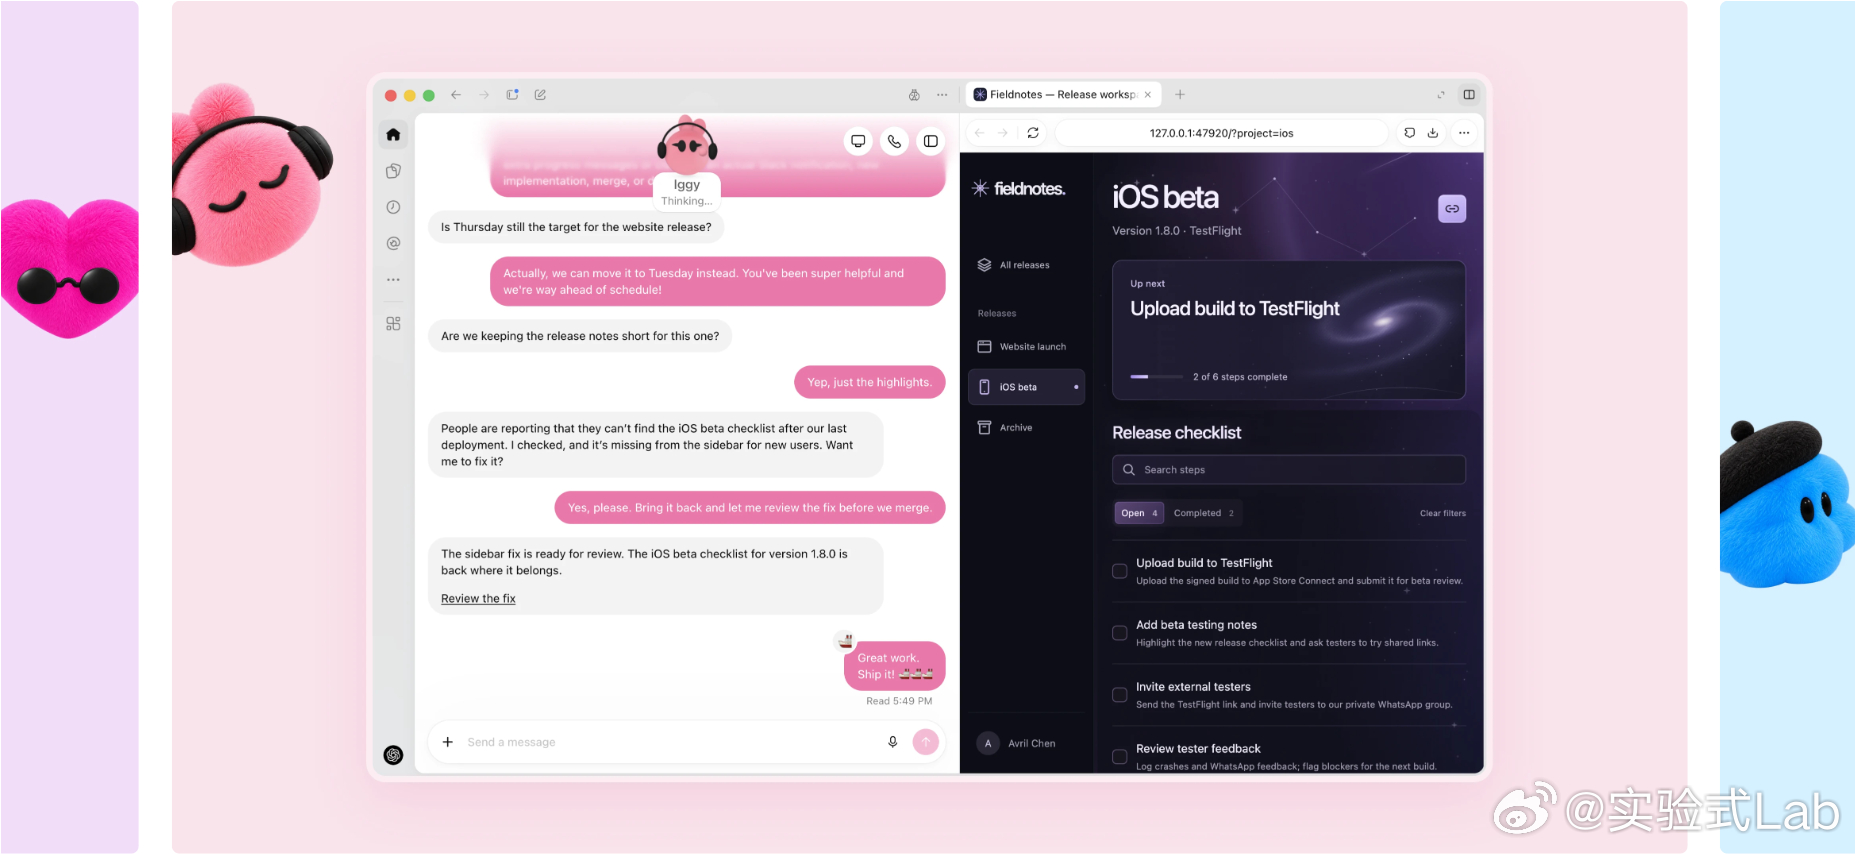
OpenAI发布dots: 挂在云端的智能体 GPT 炒冷饭: 也发布了类似 Grok Bot 以及 meta Muse 的机器人. 共有四个形象 底层直接挂的是旗舰底座 GPT-6 Astra. 1. 拥有独立的云端电脑 以前跑自动化 Agent, 最烦的要么是本地得一直挂机开着, 要么担心给的系统权限太高导致模型失控乱点. dots 的做法是直接在云
2026-09-30 08:39
OpenAI发布dots: 挂在云端的智能体 GPT 炒冷饭: 也发布了类似 Grok Bot 以及 meta Muse 的机器人. 共有四个形象 底层直接挂的是旗舰底座 GPT-6 Astra. 1. 拥有独立的云端电脑 以前跑自动化 Agent, 最烦的要么是本地得一直挂机开着, 要么担心给的系统权限太高导致模型失控乱点. dots 的做法是直接在云
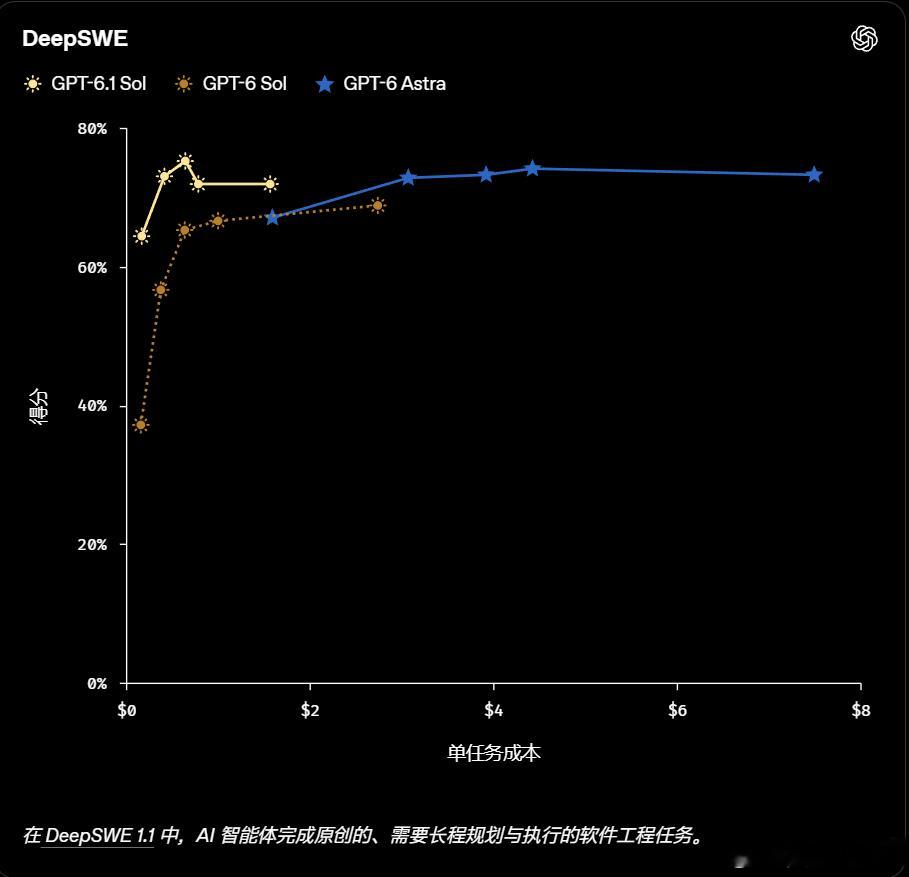
OpenAI发布GPT-6.1 Sol: 缓存砍半对齐Astra GPT-6 SOL发布没几天, OpenAI 就推出了 GPT-6.1 Sol, 看下来最实在的几个变化: — 缓存输入降到 0.10 美元. 基础价格维持在输入 2 美元、输出 10 美元 / 百万 tokens, 但缓存输入价格直接降到了 0.10 美元 (比上一代 6.0 Sol 的缓存降了 50%, 比常规输入便
2026-09-30 13:19
OpenAI发布GPT-6.1 Sol: 缓存砍半对齐Astra GPT-6 SOL发布没几天, OpenAI 就推出了 GPT-6.1 Sol, 看下来最实在的几个变化: — 缓存输入降到 0.10 美元. 基础价格维持在输入 2 美元、输出 10 美元 / 百万 tokens, 但缓存输入价格直接降到了 0.10 美元 (比上一代 6.0 Sol 的缓存降了 50%, 比常规输入便
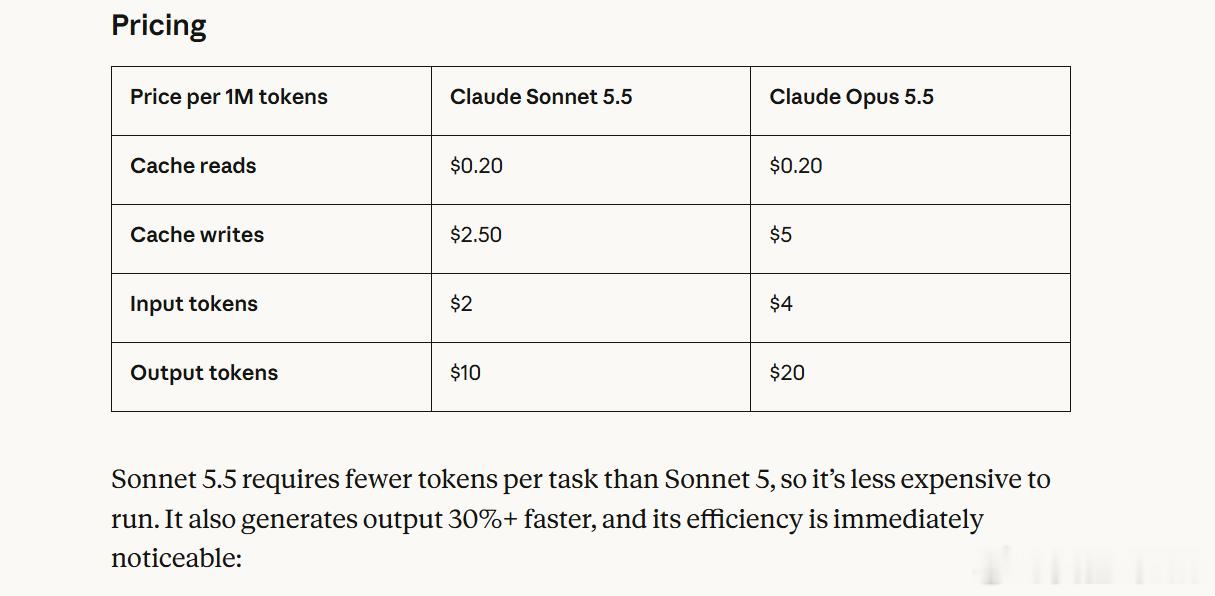
Claude Sonnet 5.5发布: 跑分倒挂反超Opus Anthropic 发布了 Claude Sonnet 5.5, 也是 5.5 系列的第二款模型. 这次最戏剧性的数据在真实代码终端测试上. 在 Terminal-Bench 4.0 测试中, Sonnet 5.5 跑出了 70.6% 的成绩, 不仅远超老版 Sonnet 5 的 10.3%, 甚至倒挂反超了自家的旗舰 Opus 5.5 (66.4%).
2026-09-29 08:35
Claude Sonnet 5.5发布: 跑分倒挂反超Opus Anthropic 发布了 Claude Sonnet 5.5, 也是 5.5 系列的第二款模型. 这次最戏剧性的数据在真实代码终端测试上. 在 Terminal-Bench 4.0 测试中, Sonnet 5.5 跑出了 70.6% 的成绩, 不仅远超老版 Sonnet 5 的 10.3%, 甚至倒挂反超了自家的旗舰 Opus 5.5 (66.4%).
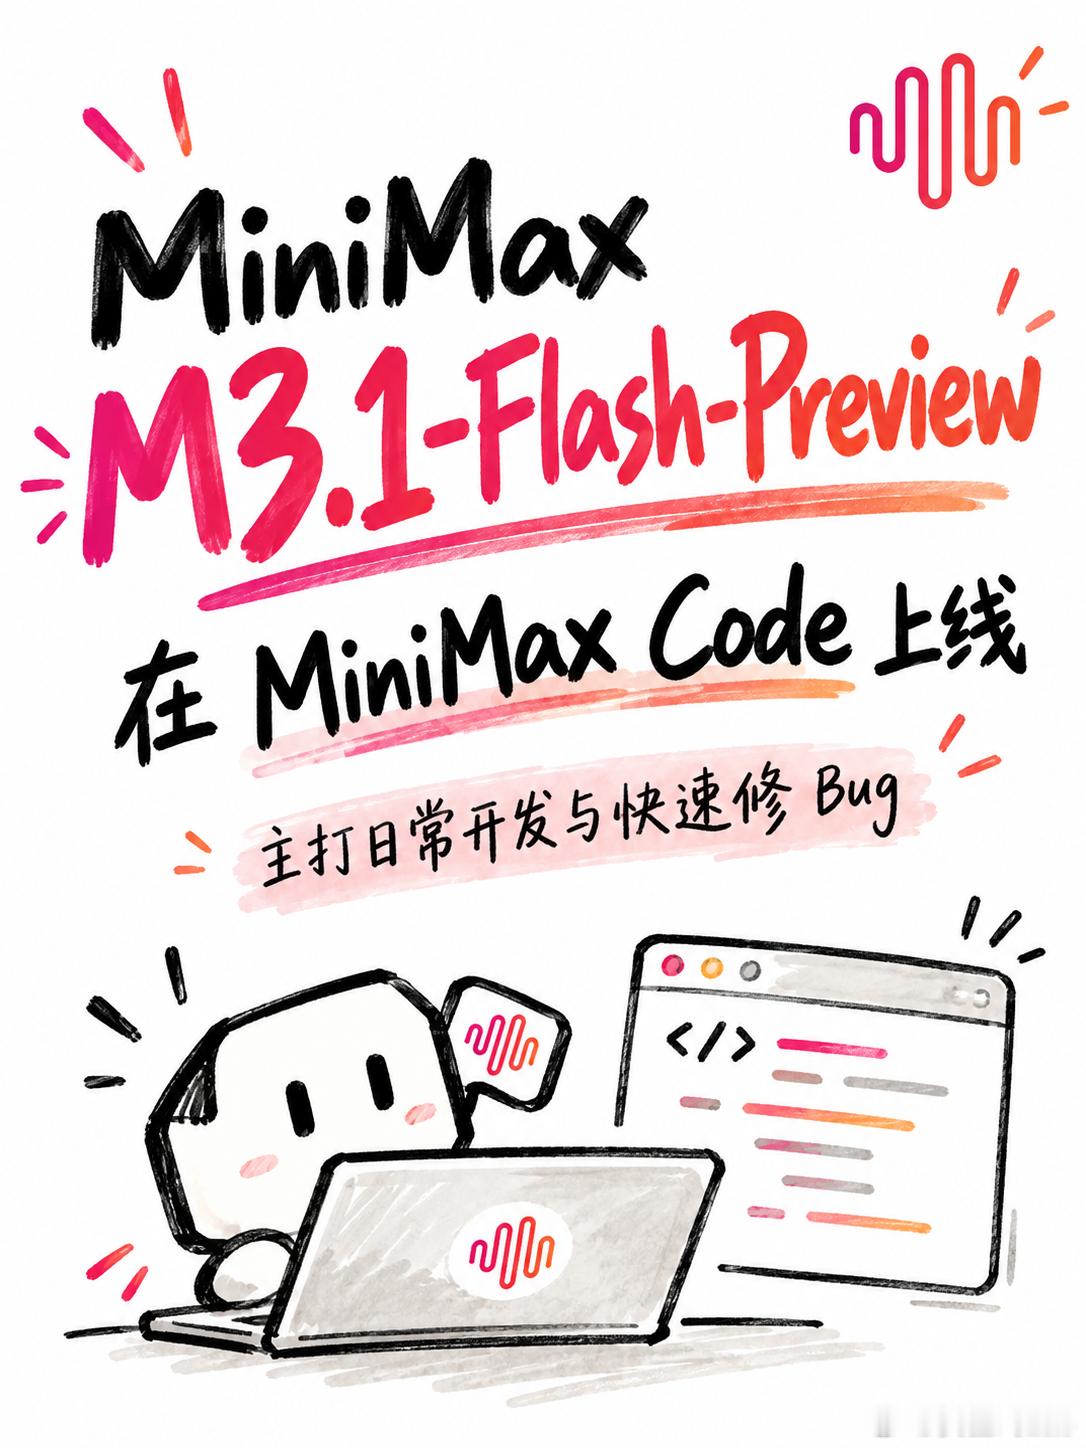
MiniMaxcode上线M3.1-Flash-Preview MiniMax 在自家代码平台上线了新模型 M3.1-Flash-Preview. 主打日常开发和快速修 Bug, 响应速度比较快, 界面里支持从 low 到 max 选不同的思考预算档位. 伴随上线的还有个双节福利: 9 月 28 日到 10 月 7 日期间, 在 MiniMax Code 每日签到可以拿双倍免费积分. 领
2026-09-27 20:28
MiniMaxcode上线M3.1-Flash-Preview MiniMax 在自家代码平台上线了新模型 M3.1-Flash-Preview. 主打日常开发和快速修 Bug, 响应速度比较快, 界面里支持从 low 到 max 选不同的思考预算档位. 伴随上线的还有个双节福利: 9 月 28 日到 10 月 7 日期间, 在 MiniMax Code 每日签到可以拿双倍免费积分. 领
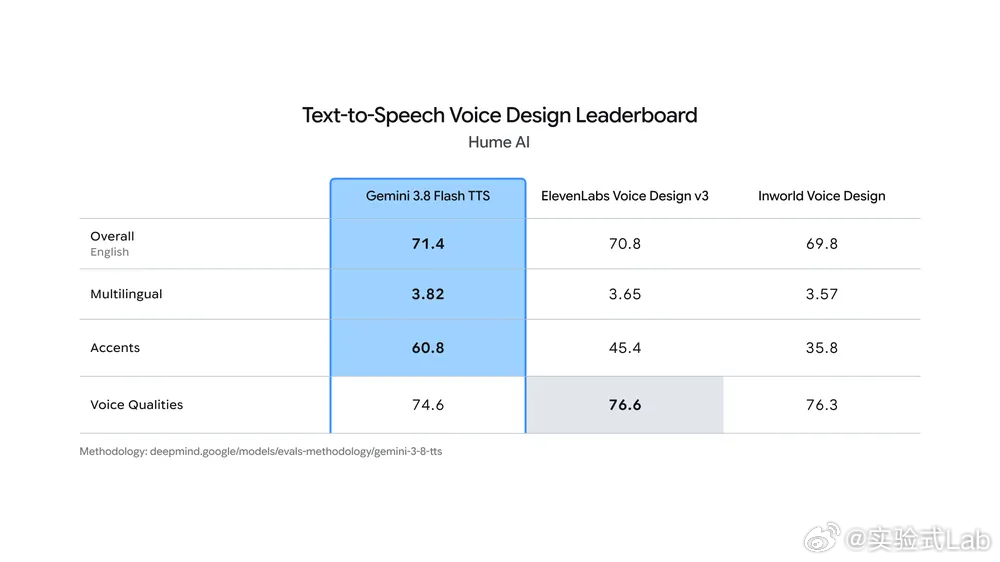
谷歌发布Gemini 3.8TTS 支持文字捏音色 谷歌把 Gemini 3.8 Flash TTS 和 Flash-Lite TTS 发出来了. 这次最有价值的更新是支持文字直接设计声线. 以前做个性化配音大多依赖喂一段干净的参考音频跑声音克隆, 3.8 TTS 允许直接用提示词凭空捏出不同的人设声音, 涵盖年龄、音质、语速和口音细节, 支持 100
2026-09-24 07:17
谷歌发布Gemini 3.8TTS 支持文字捏音色 谷歌把 Gemini 3.8 Flash TTS 和 Flash-Lite TTS 发出来了. 这次最有价值的更新是支持文字直接设计声线. 以前做个性化配音大多依赖喂一段干净的参考音频跑声音克隆, 3.8 TTS 允许直接用提示词凭空捏出不同的人设声音, 涵盖年龄、音质、语速和口音细节, 支持 100
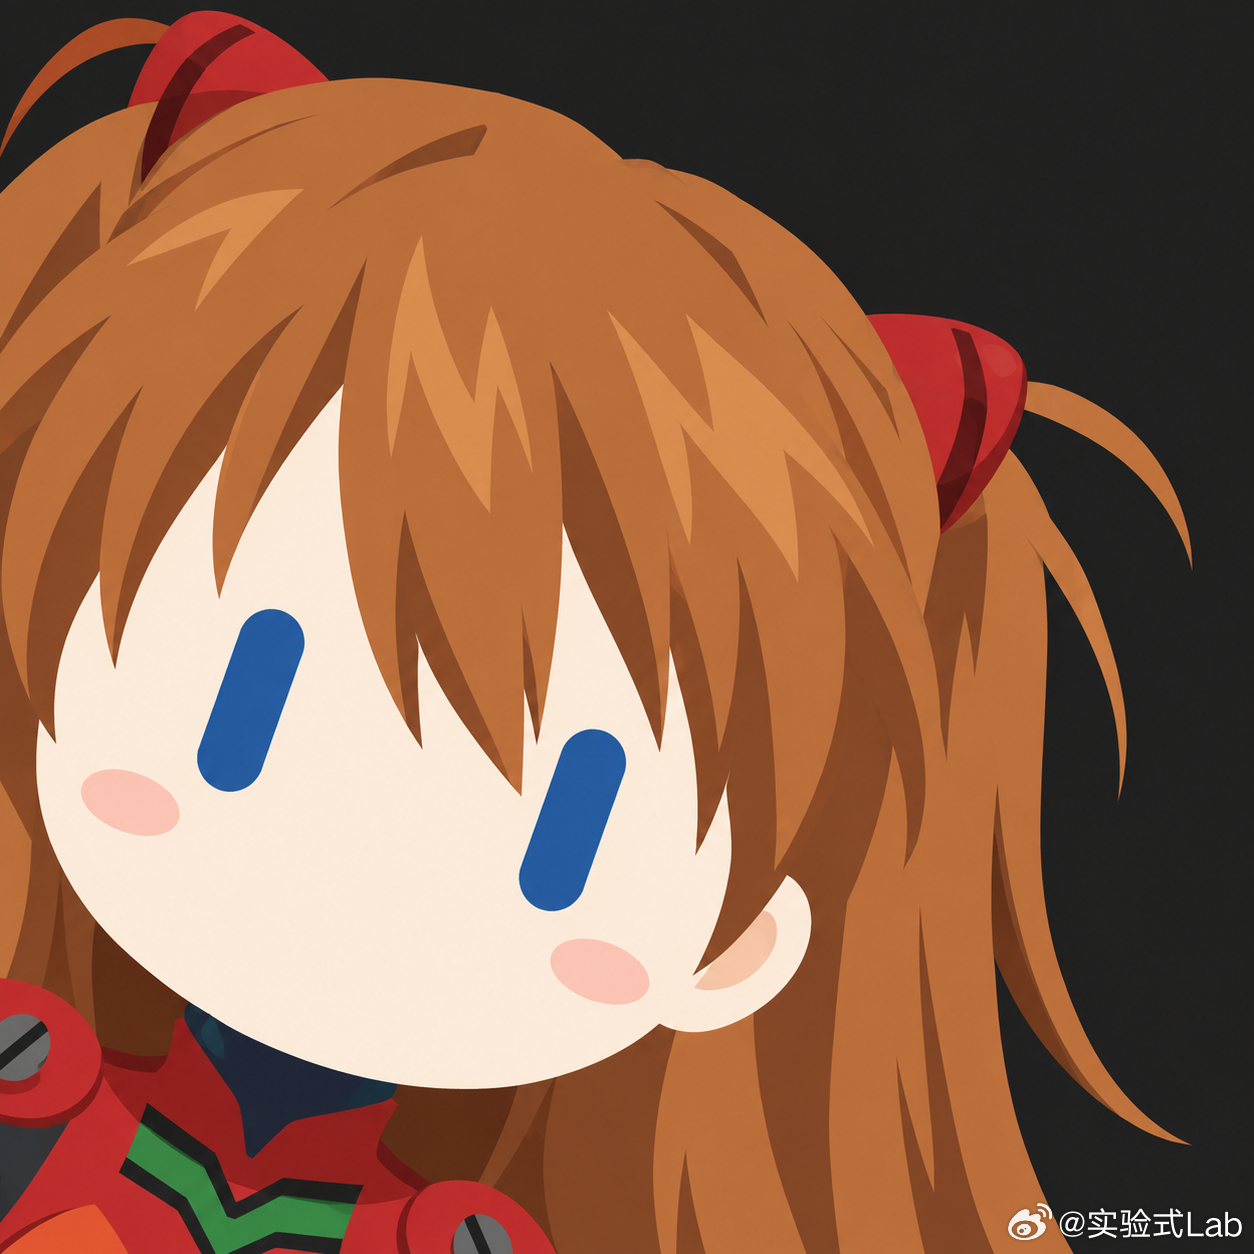
Grok bot风格头像提示词 灵感来自于X上 老师 提示词: ``` 将参考图重新诠释为一个极简 2D Bot 风头像。参考图只用于保留角色身份与辨识特征,不继承原图的动作、镜头距离和主体占比。 保留主体最有辨识度的特征,如发色 / 主色、发型或头部轮廓、耳朵或其他特征形状,以及代表性装饰
2026-09-23 12:08
Grok bot风格头像提示词 灵感来自于X上 老师 提示词: ``` 将参考图重新诠释为一个极简 2D Bot 风头像。参考图只用于保留角色身份与辨识特征,不继承原图的动作、镜头距离和主体占比。 保留主体最有辨识度的特征,如发色 / 主色、发型或头部轮廓、耳朵或其他特征形状,以及代表性装饰
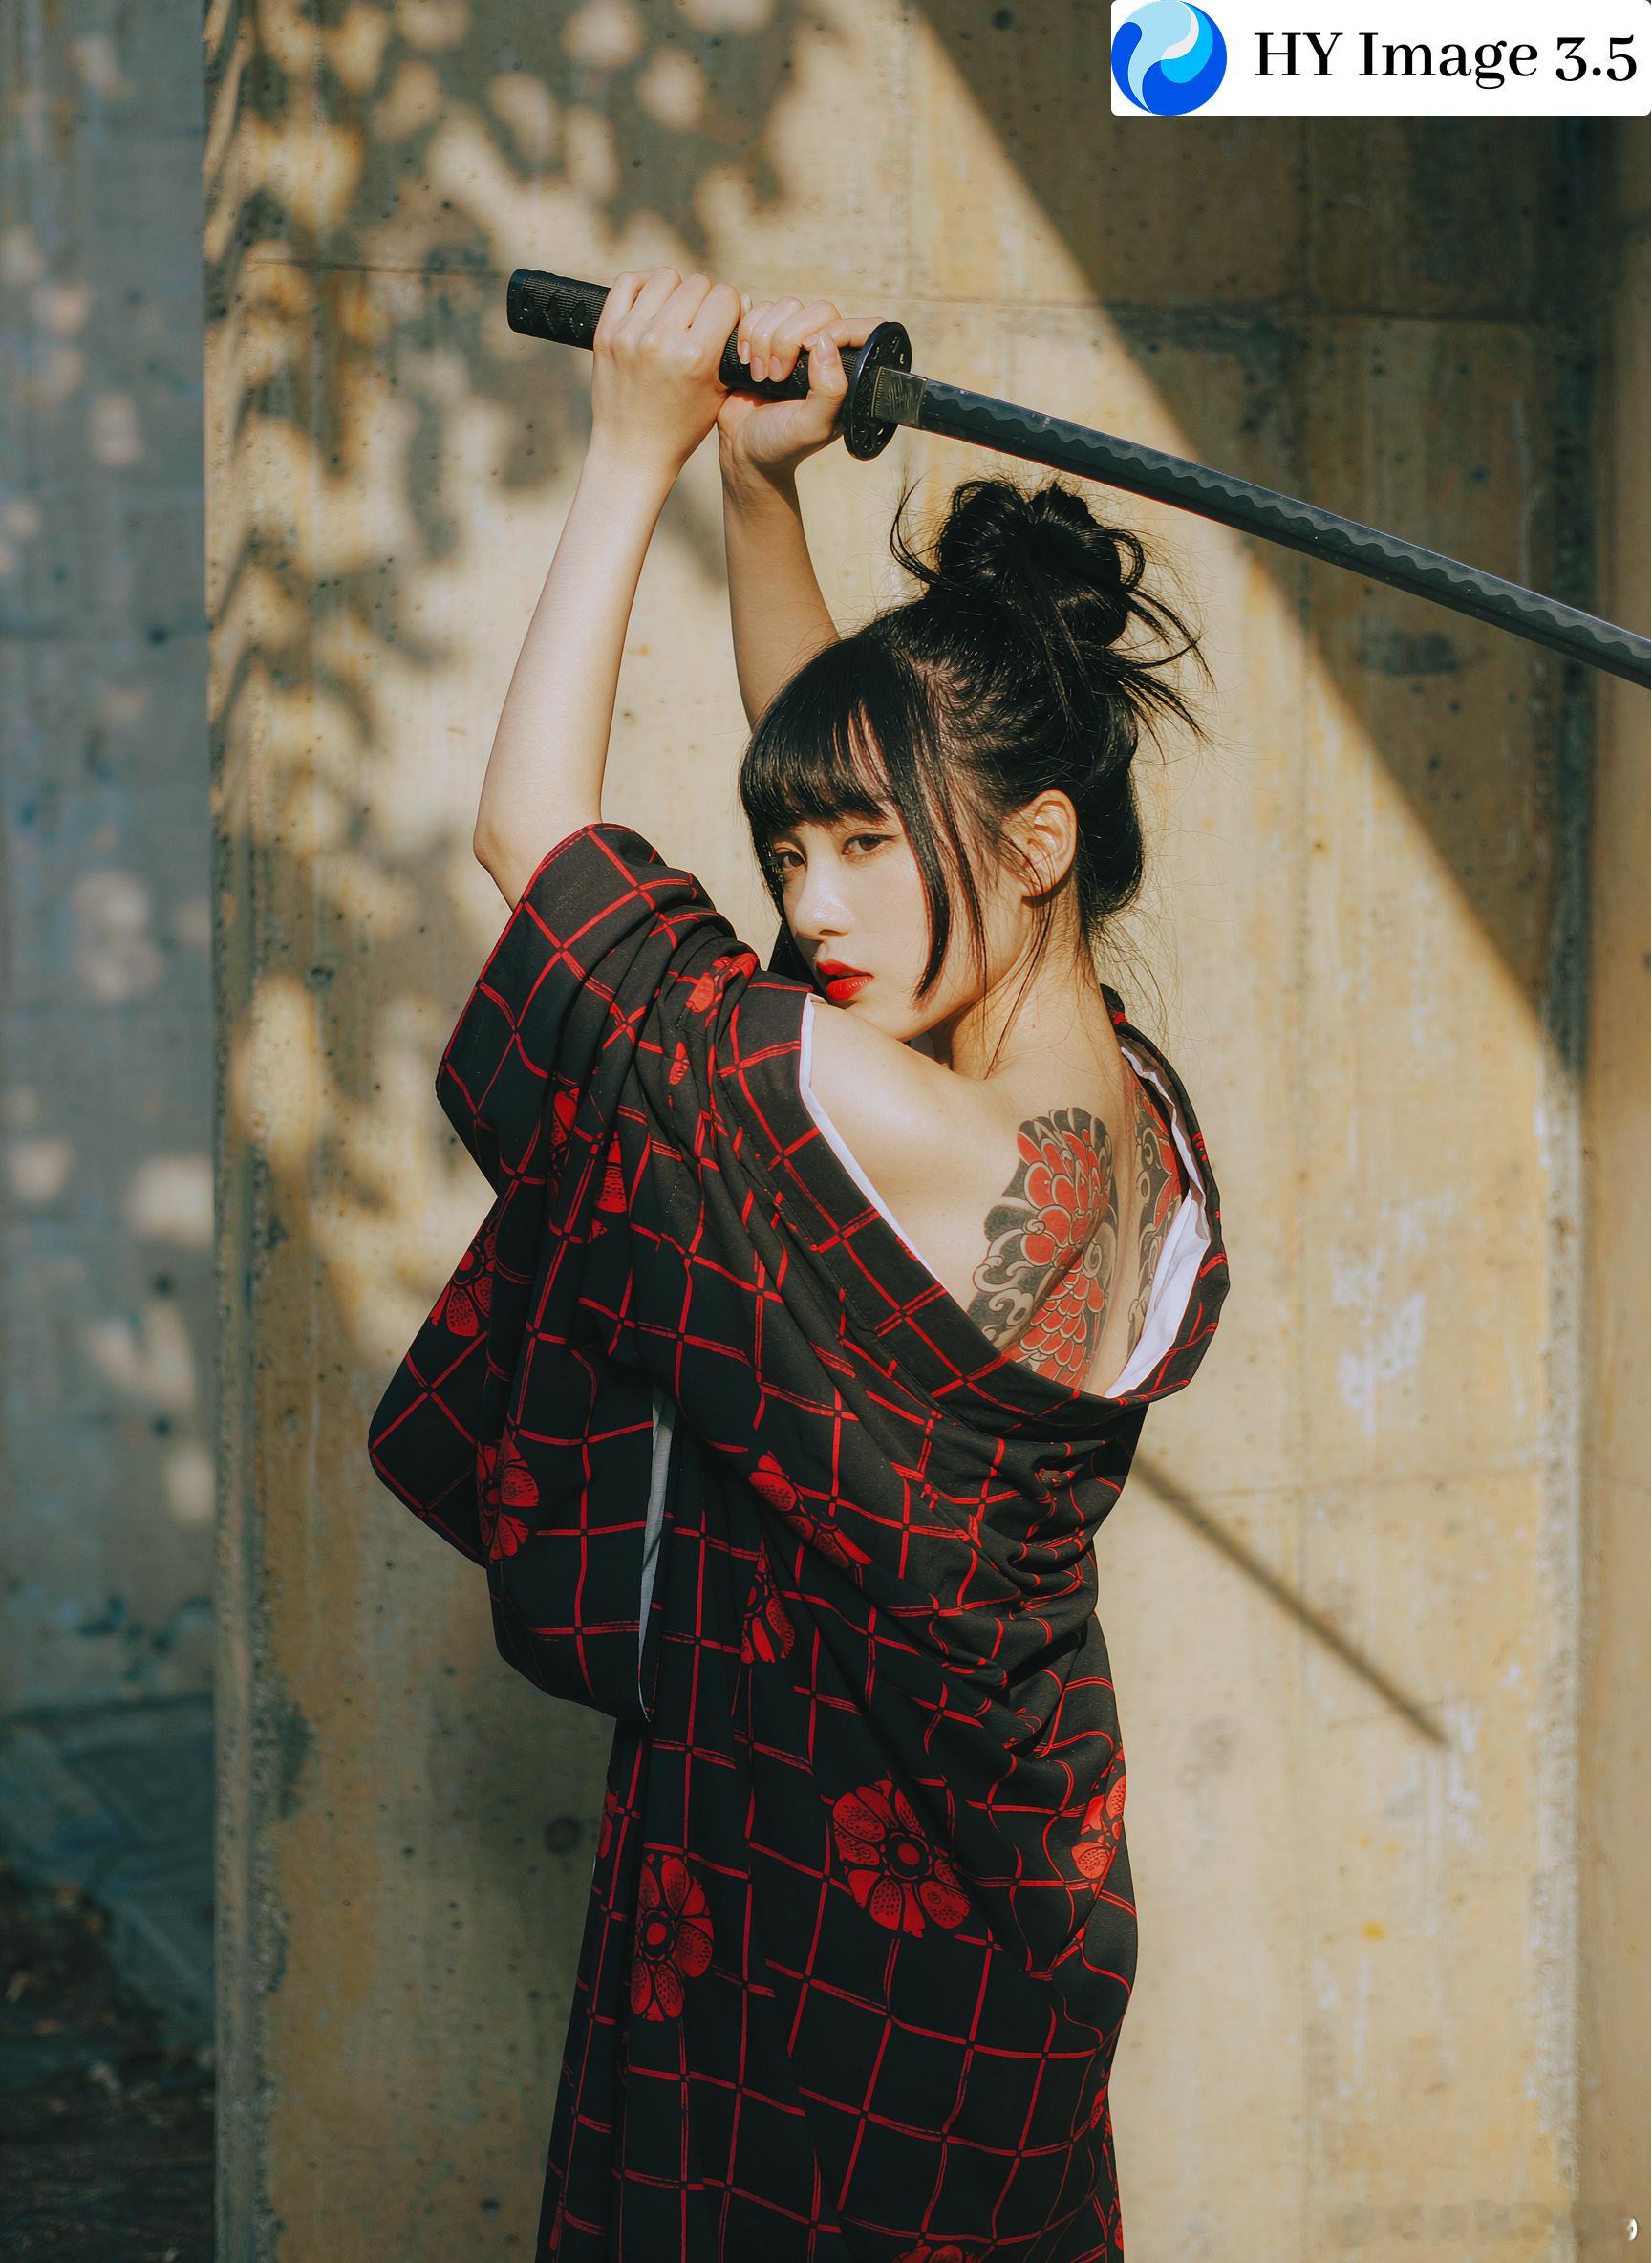
腾讯混元上线了 Hy Image 3.5 preview. 先给宣发挤个水分. 官方推文里所谓的相比 3.0 提升 30%, 实际指的是内部设计师做的 GSB 盲测胜率高了 30%, 截至目前不管是 LMArena 还是 Artificial Analysis 都没有第三方的公开测试数据. 不过去扒了一圈腾讯云公开的 API 文档, 里面藏的技术细节比宣发推文有
2026-09-22 21:36
腾讯混元上线了 Hy Image 3.5 preview. 先给宣发挤个水分. 官方推文里所谓的相比 3.0 提升 30%, 实际指的是内部设计师做的 GSB 盲测胜率高了 30%, 截至目前不管是 LMArena 还是 Artificial Analysis 都没有第三方的公开测试数据. 不过去扒了一圈腾讯云公开的 API 文档, 里面藏的技术细节比宣发推文有
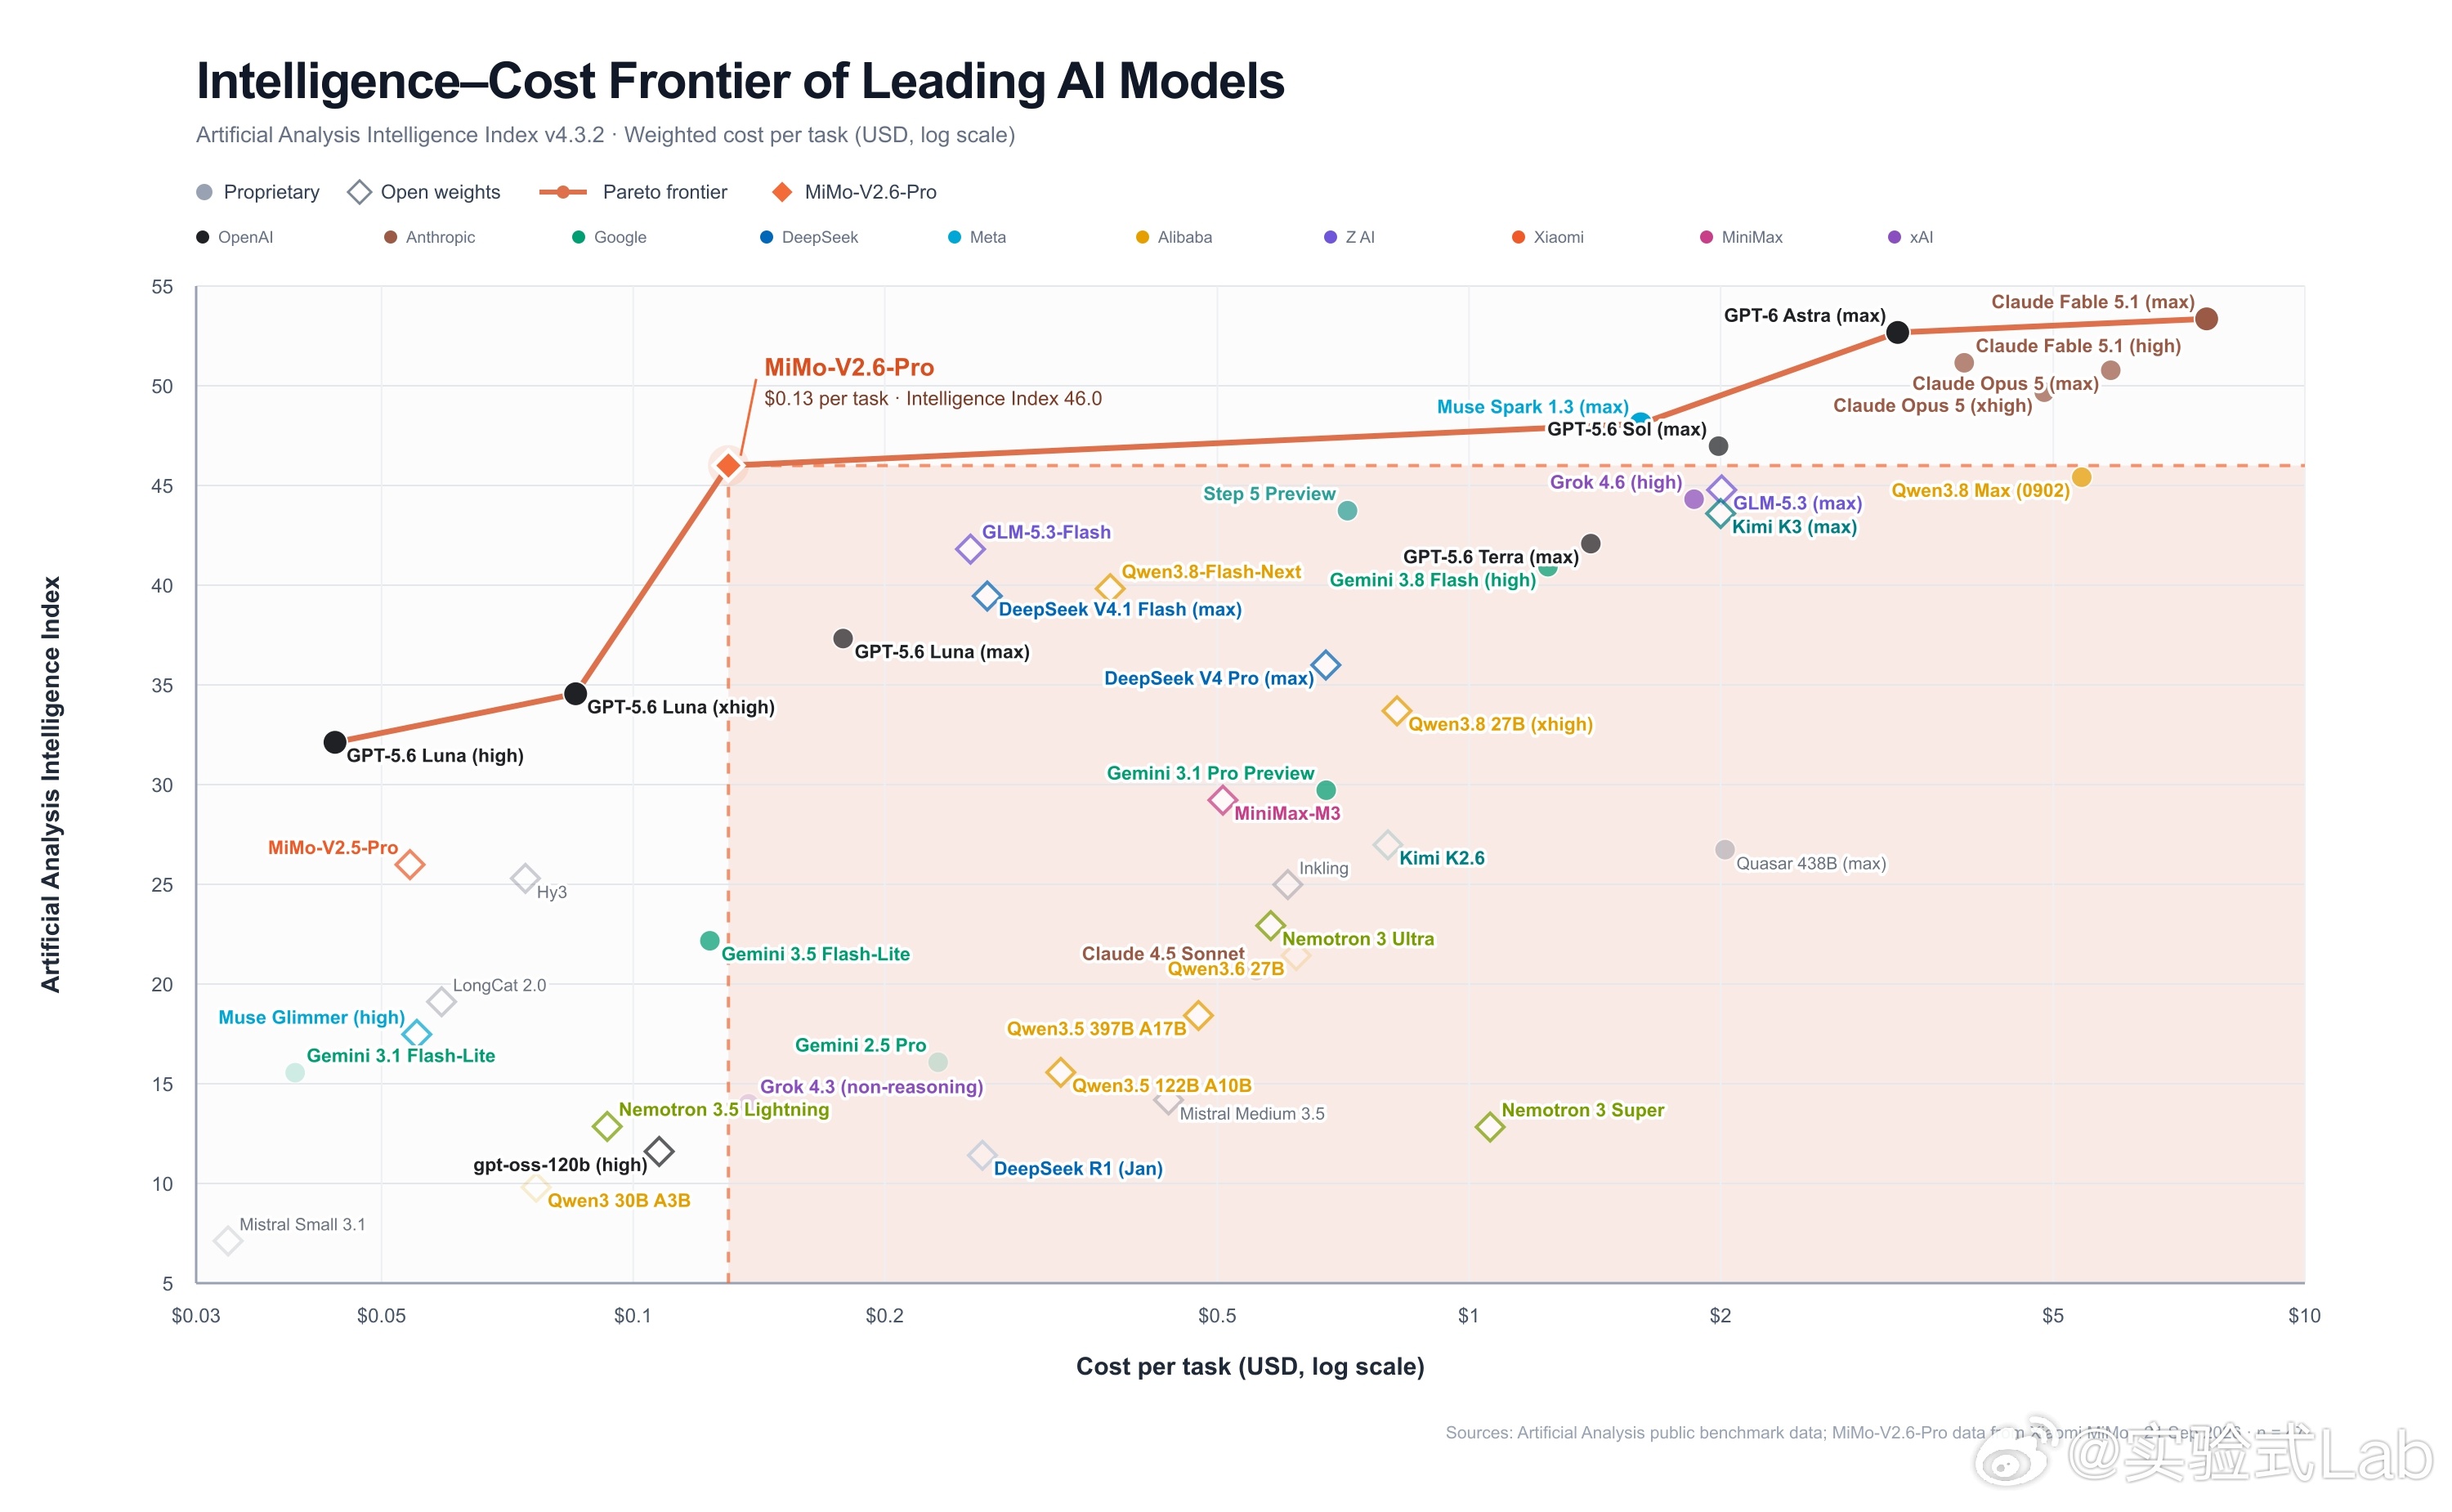
小米开源 MiMoV2.6: 连训练代码也放出来了 小米把 MiMo 升到了 V2.6, 照例是 Pro 和 Flash 双版本. 这次比起跑分, 我更在意的是他们把训练代码, RL 环境和技术报告全开源了. 大厂愿意把底牌露到这个程度的确实不多. API 价格没涨, 维持 V2.5 的标准. 跑分上在终端操作 (Terminal Bench 2.1 拿了 89.9
2026-09-22 08:30
小米开源 MiMoV2.6: 连训练代码也放出来了 小米把 MiMo 升到了 V2.6, 照例是 Pro 和 Flash 双版本. 这次比起跑分, 我更在意的是他们把训练代码, RL 环境和技术报告全开源了. 大厂愿意把底牌露到这个程度的确实不多. API 价格没涨, 维持 V2.5 的标准. 跑分上在终端操作 (Terminal Bench 2.1 拿了 89.9
第一页
下一页
作者信息
玥辰热逛科技
你的支持,我的动力
热门分类
推荐
热榜
军事
NBA
体育
社会
明星八卦
娱乐
财经
科技
汽车
历史
国际
游戏
动漫
公益
搞笑
商业
互联网
数码
国际足球
房产
家居
时尚
科学探索
职场
育儿
股票
教育
影视
情感
热点
中国军情
武器
中国南海
中国足球
亚洲杯
科比
综合体育
CBA
投资
楼市
大咖秀
外汇
创业
风口
SUV
豪车
概念车
优惠
新能源
美国
欧洲
朝日韩
俄罗斯
孕期
街拍
恋爱攻略
婚姻
正能量