英伟达Rubin平台规格调整:HBM4与NVLink带宽权衡分析
规格调整概况
• 10月26日消息,据报道,英伟达近期悄然下调了下一代Vera Rubin超级芯片的HBM4内存带宽与NVLink互连带宽规格。
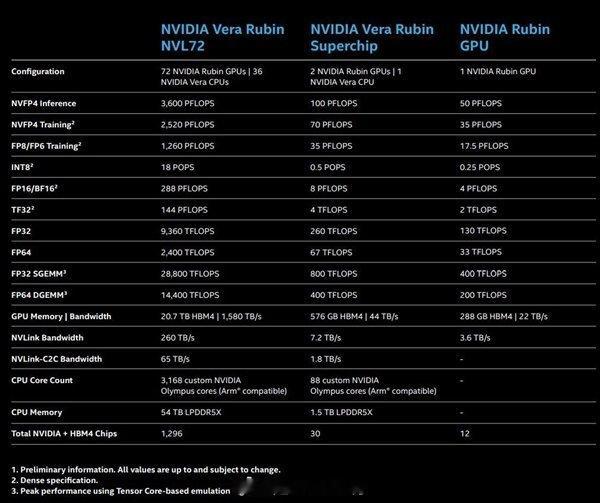
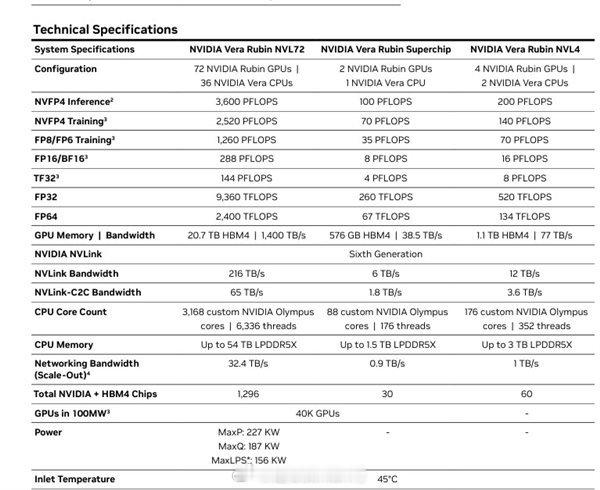
• 与今年6月文档相比,10月最新资料显示,HBM4带宽从44TB/s降至38.5TB/s,降幅约12.5%;NVLink带宽则从7.2TB/s降至6TB/s。
• 具体到单GPU,NVLink带宽从原先的1.8TB/s下调至1.5TB/s,双向带宽由3.6TB/s降至3TB/s。
• NVLink是英伟达GPU之间高速通信的核心技术,其带宽直接决定多卡协同训练的效率。
• 这一调整意味着Rubin平台在芯片间数据交换能力上有所收缩。
网络带宽提升
• 不过,英伟达并非全面降规。
• 横向扩展网络带宽从0.8TB/s提升至0.9TB/s,增幅12.5%。
• 横向扩展网络负责跨机架、跨集群的节点互联,其带宽提升对大规模AI集群的通信效率有正面作用。
行业分析与影响
• 业内分析认为,下调HBM4带宽门槛,可能是为了放宽对HBM4内存的技术要求,让更多供应商的HBM4产品符合Rubin GPU的规格,从而提升最终产量。
• 当前HBM4供应仍处于爬坡阶段,三星、SK海力士等原厂的良率与产能直接制约着Rubin平台的交付节奏。
• 对AI集群而言,这是一次权衡:牺牲部分芯片内互连带宽,换取更高的HBM4供应量,同时用网络带宽的微增来弥补跨节点通信的短板。
• 而Rubin平台的最终性能表现,将取决于英伟达如何在HBM4供应、NVLink带宽与网络架构之间找到新的平衡点。nvidia