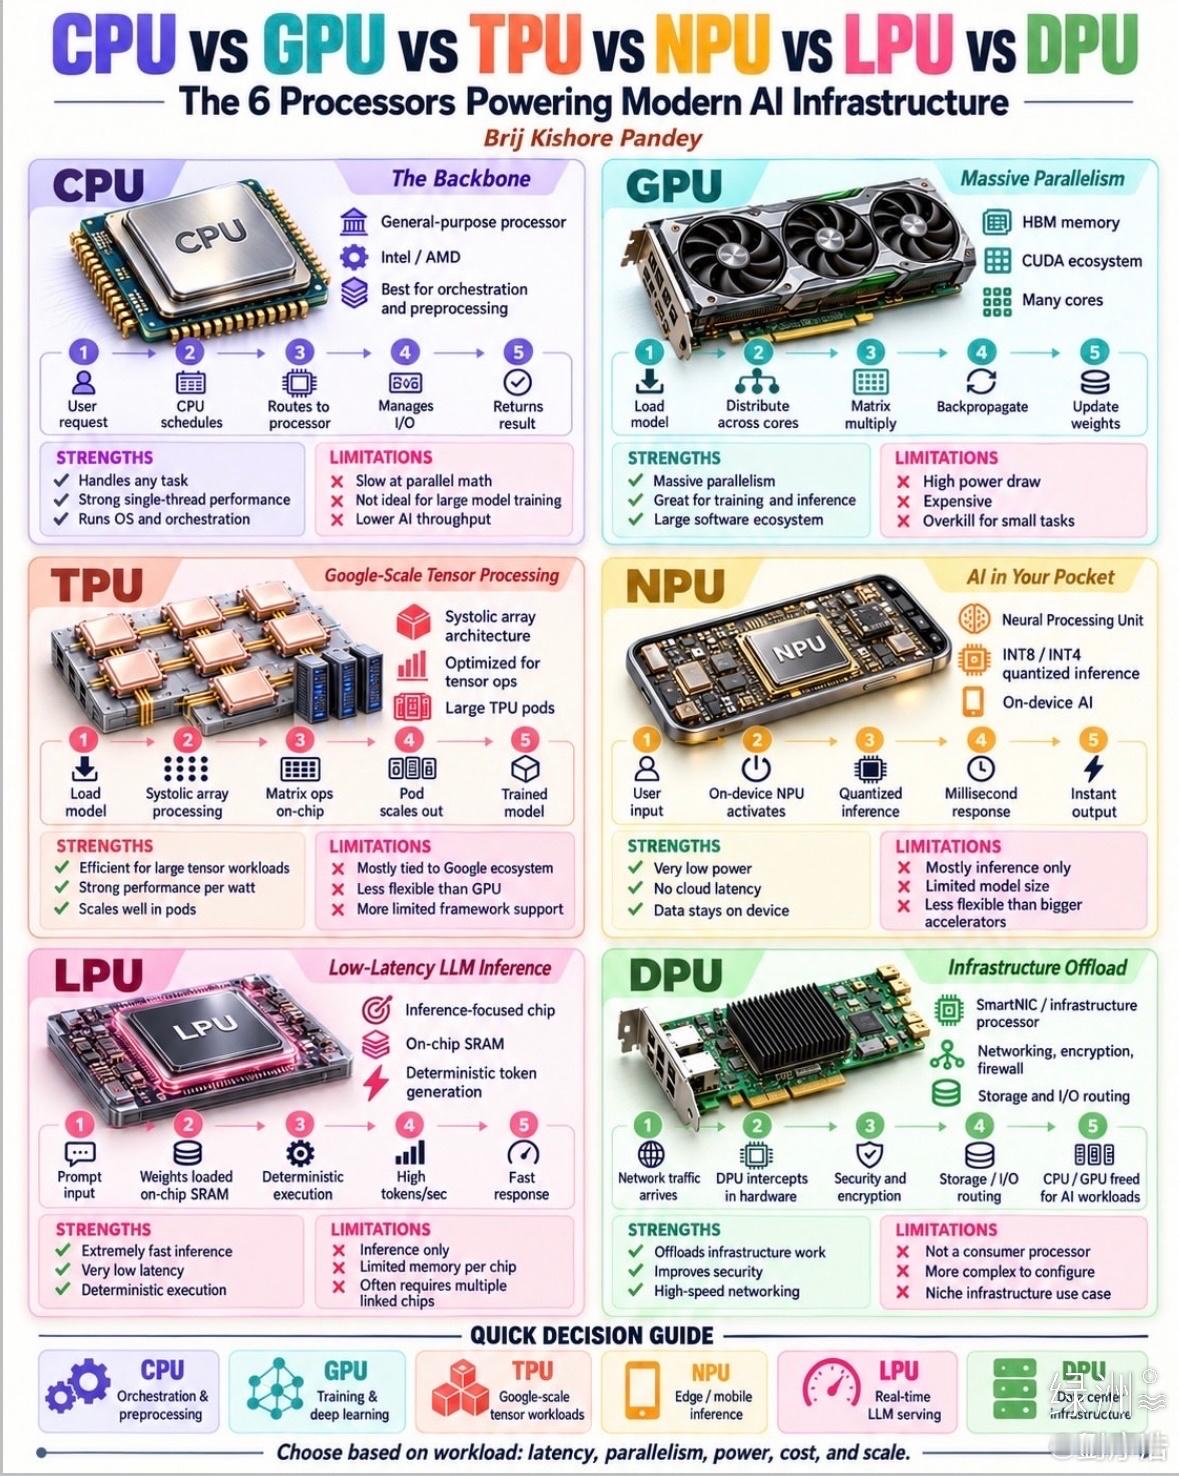
六大處理器/支撐現代AI 基礎設施的六大芯片 一、CPU|The Backbone|支柱定位:通用處理器;代表廠商:英特爾 / AMD;擅長調度與預處理工作流程:接收用戶請求 → 任務排程 → 分配給處理器 → 管理輸入輸出 → 返回結果✅ 優勢:什麼任務都能處理;單線程性能強勁;運行操作系統、統籌調度❌ 短板:並行運算速度慢;不適合超大模型訓練;運算吞吐量偏低
二、GPU|Massive Parallelism|大規模並行算力定位:海量並行計算;搭載 HBM 高速內存;成熟 CUDA 生態;大量計算核心工作流程:載入模型 → 多核分配任務 → 矩陣乘法運算 → 反向傳播 → 更新權重✅ 優勢:超強並行能力;訓練、推理兩相宜;配套軟件生態龐大❌ 短板:功耗巨大;造價昂貴;小任務屬於性能過剩
三、TPU|Google-Scale Tensor Processing|谷歌級張量處理定位:脈動陣列架構;專為張量運算優化;大型 TPU 模組集群工作流程:載入模型 → 脈動陣列運算 → 芯片內矩陣運算 → 模組集群擴容 → 運行訓練完成模型✅ 優勢:超大張量任務效率極高;單位功耗性能出色;集群擴展性強❌ 短板:大多依附谷歌生態;靈活性不及 GPU;框架支持偏少
四、NPU|AI in Your Pocket|口袋裡面的人工智能定位:神經網絡處理單元;主打 INT8 / INT4 量化推理;端側本地 AI工作流程:接收用戶指令 → 啓動本地 NPU → 量化推理運算 → 毫秒級運算 → 輸出結果✅ 優勢:功耗極低;無雲端延遲;數據保留在設備本地❌ 短板:大多只適合推理;模型尺寸受限;對比大型加速器靈活性不足
五、LPU|Low-Latency LLM Inference|低延遲大語言模型推理定位:推理專用芯片;片上高速 SRAM;確定性 Token 生成工作流程:輸入提示詞 → 權重載入片上 SRAM → 確定性運算 → 高速生成 token → 快速響應✅ 優勢:推理速度極快;延遲超低;運算結果穩定可預測❌ 短板:僅限推理使用;單芯片內存有限;常常需要多片聯動
六、DPU|Infrastructure Offload|基礎設施卸載處理器定位:智能網卡 / 基礎設施芯片;網絡、加密、防火牆、存儲與 IO 路由工作流程:網絡流量抵達 → DPU 硬件攔截 → 安全校驗加密 → 存儲與 IO 路由 → 為 AI 負載釋放 CPU✅ 優勢:分擔基礎設施繁重工作;提升安全性;高速網絡處理❌ 短板:不屬於消費級處理器;配置複雜;使用場景局限在數據中心
快速指南• CPU:統籌調度、預處理• GPU:訓練、深度學習• TPU:超大規模張量運算• NPU:移動端、邊緣設備绿洲