H2RB:人类示范怎样教机器人?
人类演示开抽屉,机器人为何仍会伸错手?人手和机械手不仅外观不同,动作幅度、接触方式也不同。H2RB认为,只统一动作坐标还不够:视觉特征与动作输出这两个接口,都需要跨身体对齐。
它从机器人数据预训练的VLA出发,联合学习互不配对的人类和机器人示范。人类提供目标物体或新技能,机器人提供其他任务的操作经验。因此“无需目标任务的机器人示范”,不等于完全没有机器人数据,也不等于看一段任意视频就能部署。
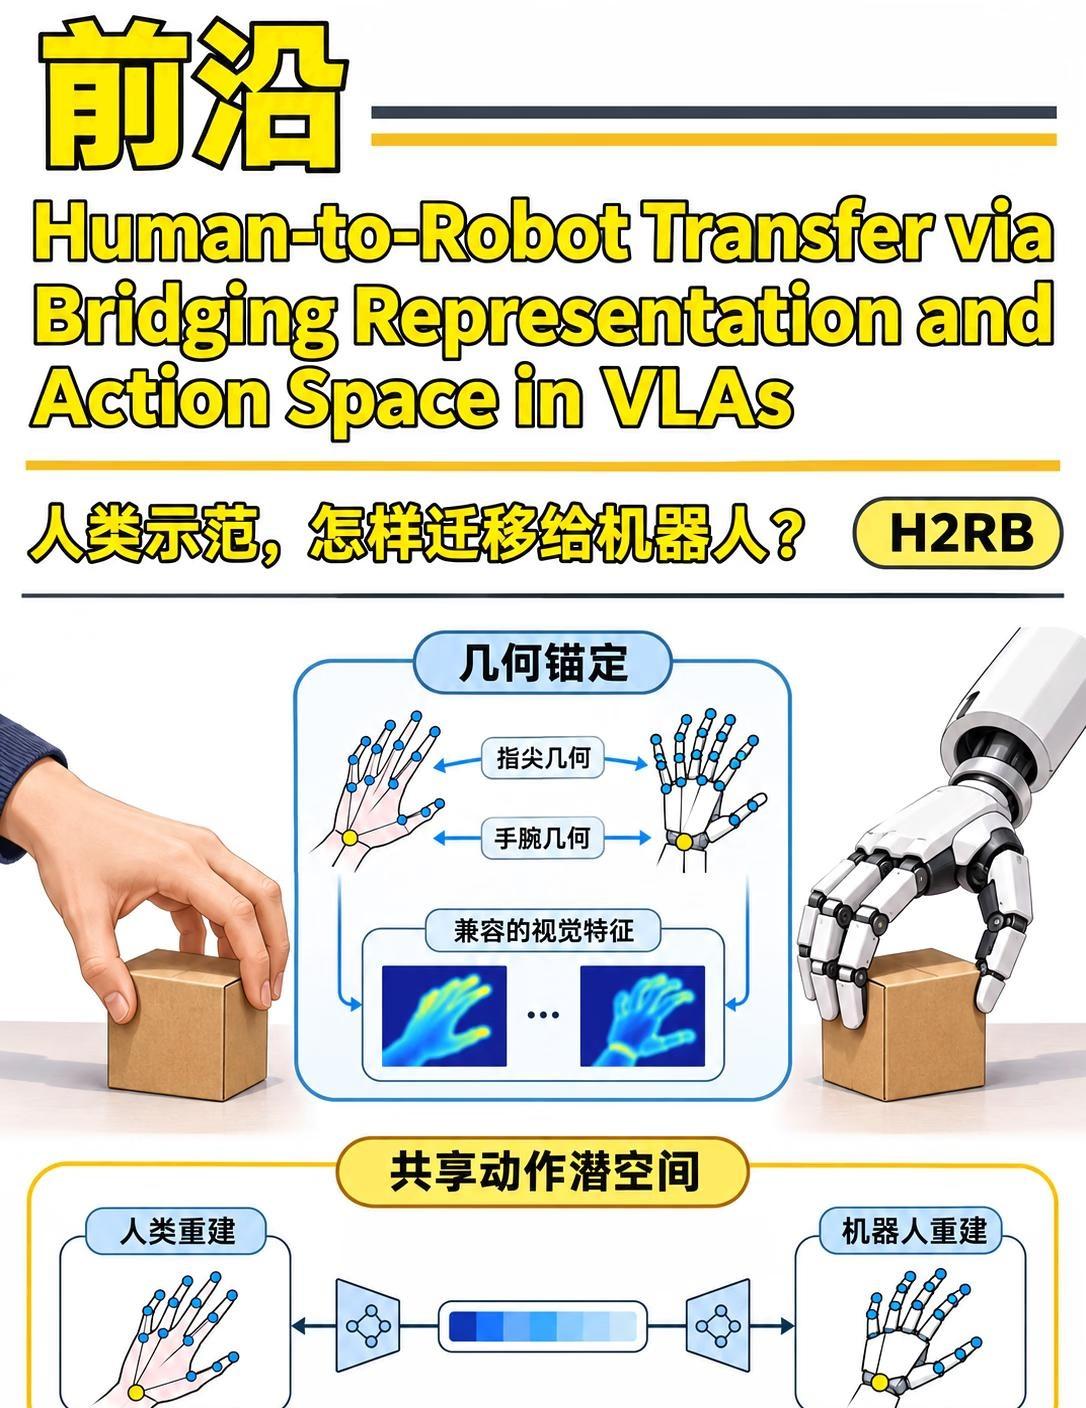
第一座桥是几何锚定。研究者从人类视频重建腕部和手部运动,机器人侧从自身配置取得几何目标;用当前腕部姿态与五个指尖的位置,监督共享残差适配器后的视觉语言特征。每条样本监督自己,不要求人机逐帧对应。几何读出头仅在训练时使用。
第二座桥是动作潜空间。两类动作先转成机器人兼容的腕手表示,再由共享编码器压缩动作片段;人类和机器人各用一套完整解码器重建,保留各自的运动结构。训练还约束两域潜变量的中心、方差与协方差,减少分布错位,同时避免所有表示挤成一点。
随后冻结动作编码器、两套解码器与VLM主干,训练适配器和动作专家,让后者通过流匹配从噪声逐步生成动作潜变量。这里的冻结设置对应任务级微调;额外的大规模异构训练使用另一套参数更新范围。
部署有个容易读反的细节:默认使用人类示范分支的解码器。它输出的已经是机器人兼容表示,再经逆归一化与逆运动学执行,并非把未经转换的人手关节直接发给机械手。
OpenArm实验中,相比普通人机联合训练,物体迁移评分从8.0升至51.8,开关空气炸锅的技能评分从0升至62.7。但这是0至100的进度加权分:触达、抓住、移动到一半都会计分,不能写成51.8%或62.7%的完整成功率。
附录给出的完整完成率更能说明边界:物体迁移为12.2%,技能迁移为30.0%。每套策略分别评估90次物体迁移和30次技能迁移,且每个条件只有一套独立训练策略;还不能据此判断多次训练的波动。
这些测试使用同一环境、相近相机视角,主要覆盖三类物体与开关技能。其价值是让廉价人类示范真正进入机器人策略学习,而不是宣告跨场景、跨硬件的通用迁移已经解决。
机器人学习 视觉语言动作