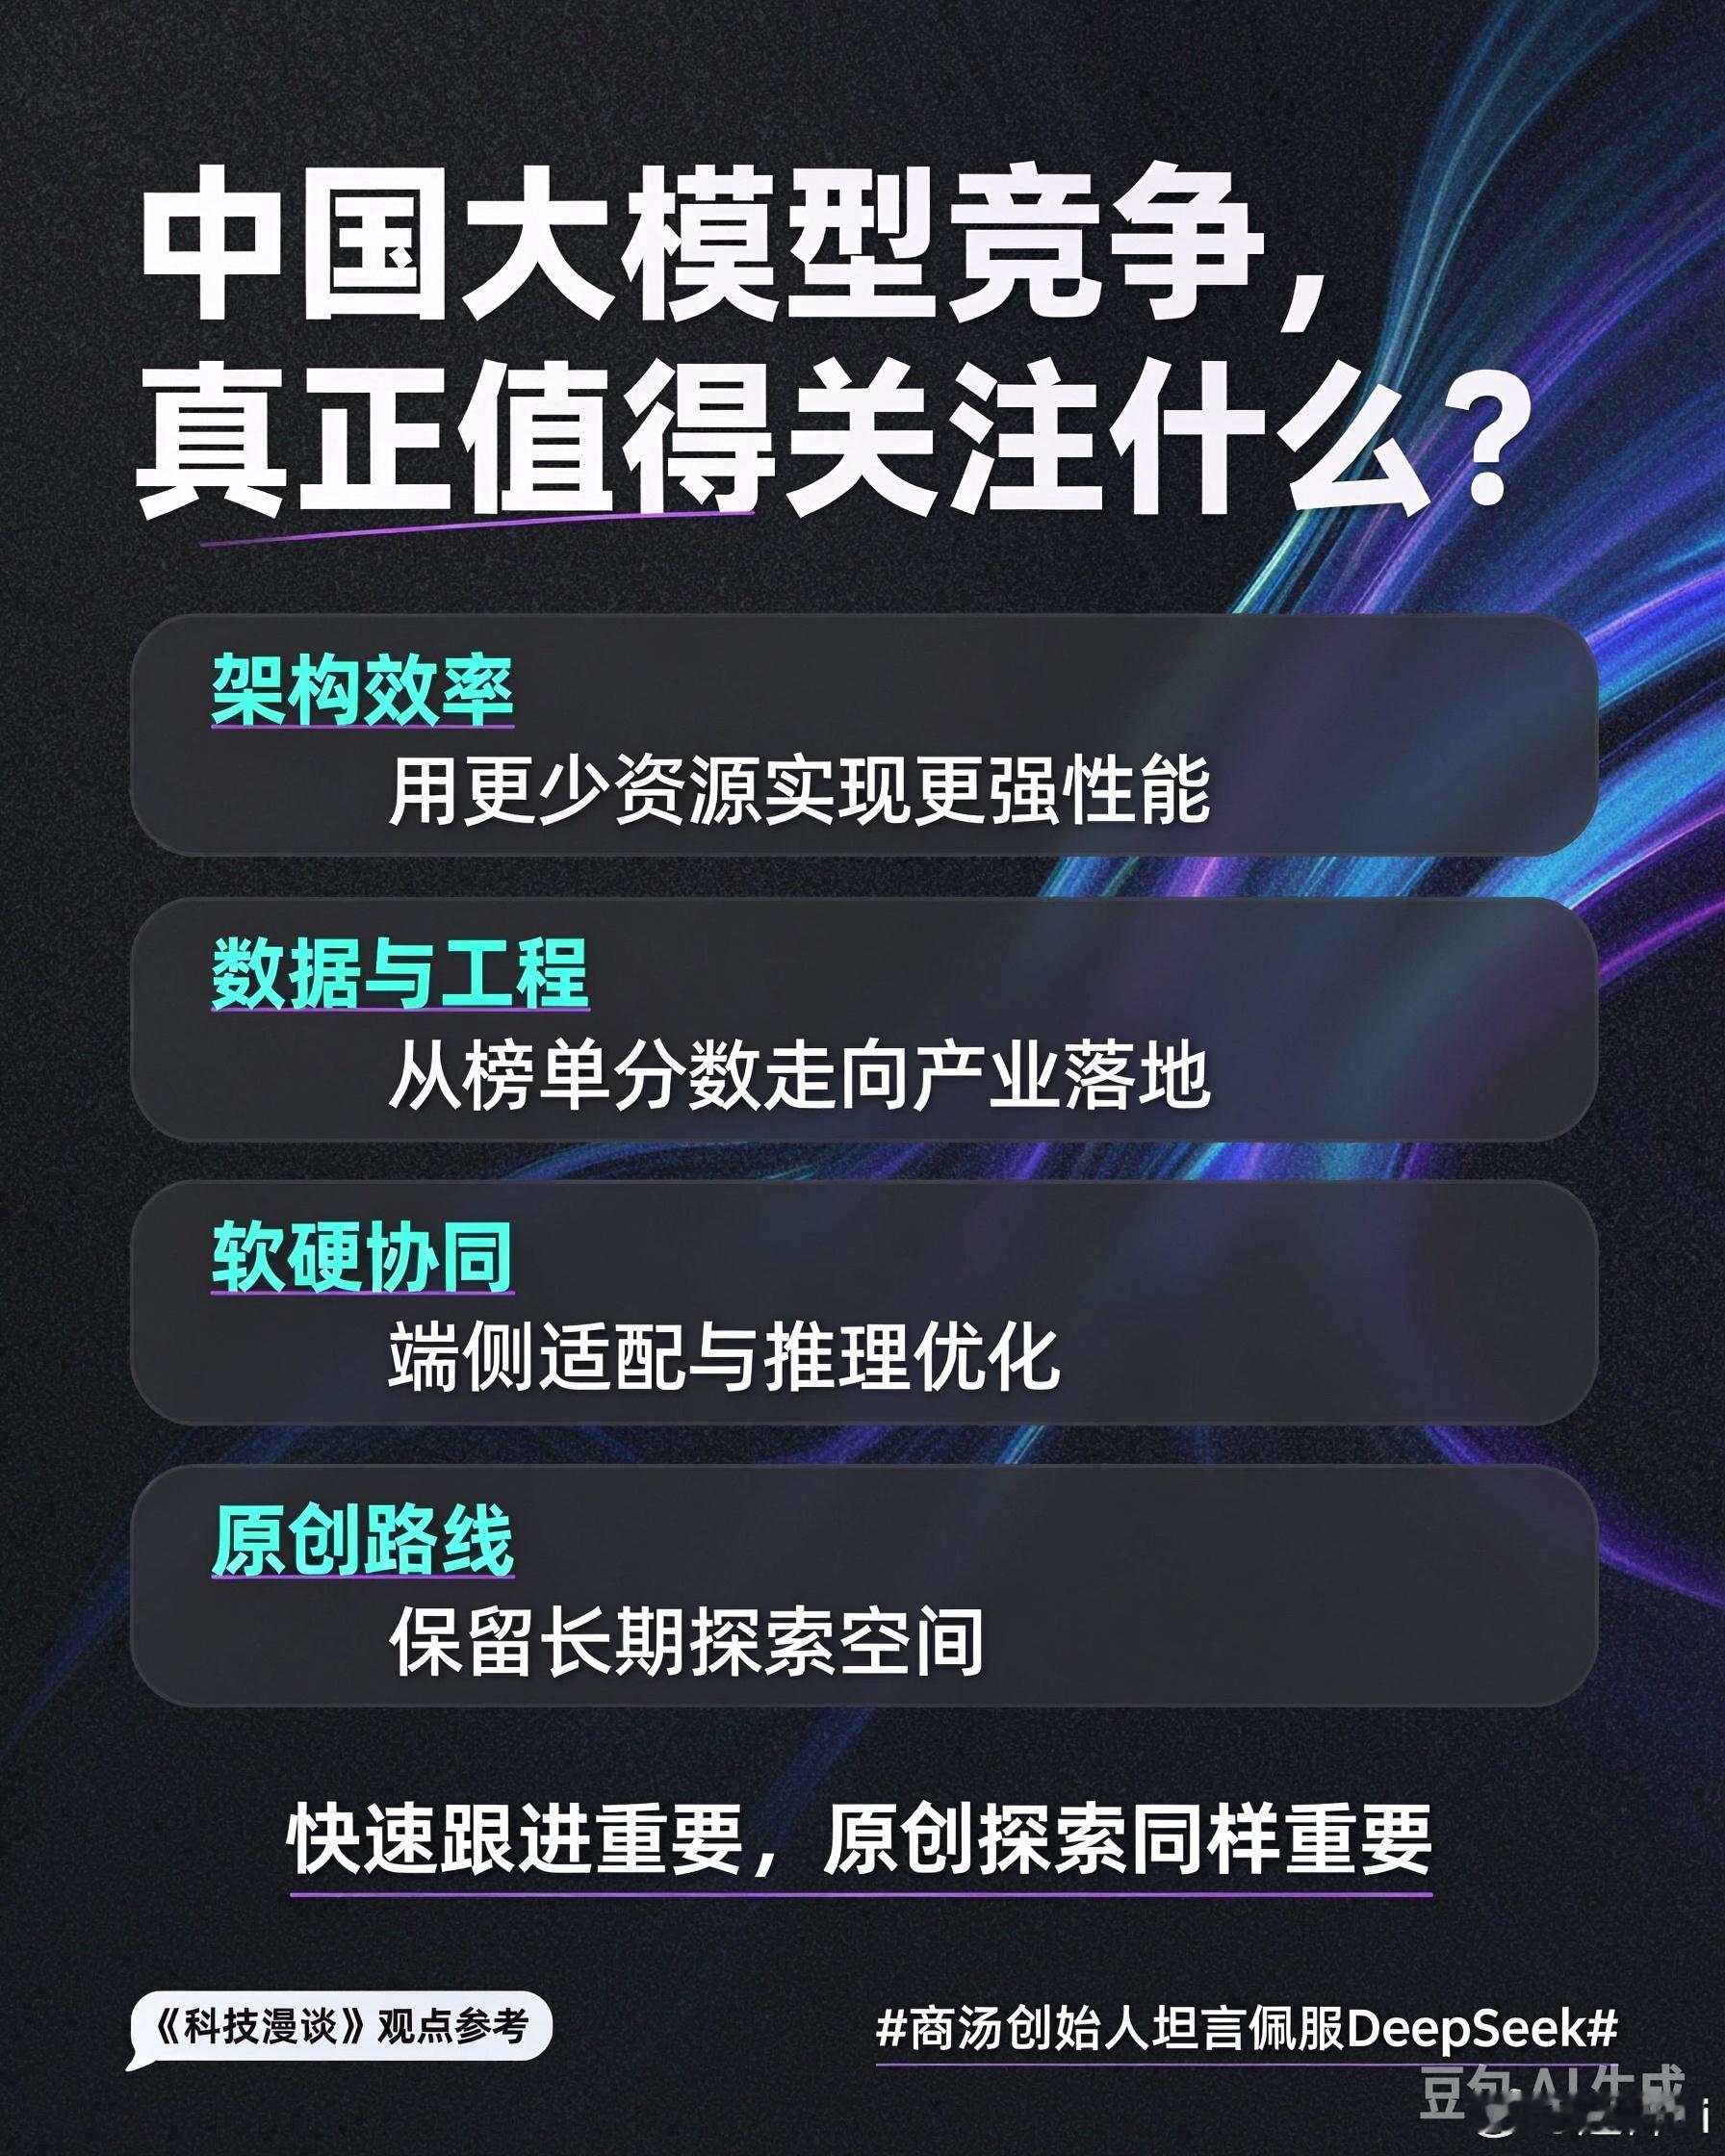
商汤创始人坦言佩服DeepSeek当下国内大模型赛道竞争愈发白热化,各家忙于刷新榜单分数、加快版本迭代,但榜单性能并非衡量大模型价值的唯一标尺。在《科技漫谈》S2EP03当中,商汤创始人林达华表示十分佩服DeepSeek在模型架构效率层面的深耕探索,这也抛出了行业值得深思的命题:在极速内卷的环境下,我们该如何平衡追赶迭代与原创技术探索,走出属于中国AI的创新之路。
DeepSeek最核心的创新,不在于单纯堆参数、拼算力,而是聚焦架构效率做深度打磨,依托稀疏注意力、混合推理等技术,在保障模型推理、长文本、代码能力的同时,压低训练与推理成本,用更经济的资源实现第一梯队的模型效果,为行业提供了不靠算力堆砌实现突破的范本。抛开榜单跑分,高质量中文数据集建设、软硬协同适配优化、端侧轻量化落地、智能体Agent工程化实践,还有安全对齐技术,同样是决定大模型能否真正产业落地的关键创新方向,远比纸面分数更有长期价值。
快速跟进迭代与原创探索二者并非完全对立,但行业不能一味陷入“版本竞速”的内卷循环。快速跟进可以帮助我们补齐差距、跟上全球技术节奏,可如果全部资源都投入短期迭代,就会挤压新技术路线试错的空间,难以诞生颠覆性成果。对于国内AI企业而言,一方面要吸收全球前沿技术成果,做好工程化落地,另一方面也要保留足够耐心投入底层原始创新,立足国内海量产业场景,从数据、算法、应用全链条打造差异化优势,不盲从海外技术路径,沉淀独有的技术积累,这样才能在全球AI竞争当中持续输出中国的技术价值,真正实现长久的行业突破。