现在很多人用Agent干活,都被同一个设定影响过:能力是打包给的。界面上摆着几个档位,你选一个,然后把活丢进去,它跑,你等。至于背后是哪个模型在接活、为什么是它而不是别的,你既看不到,也不好改。
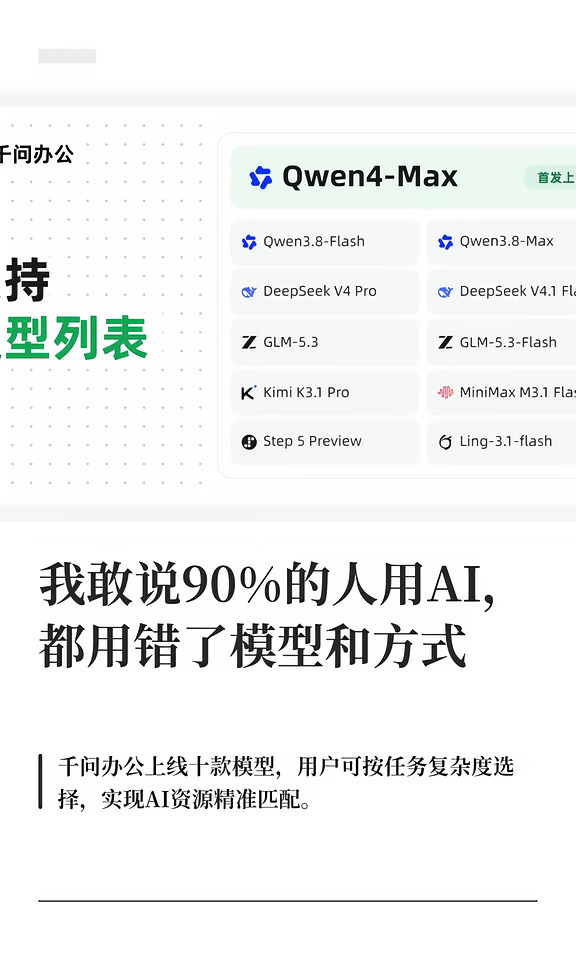
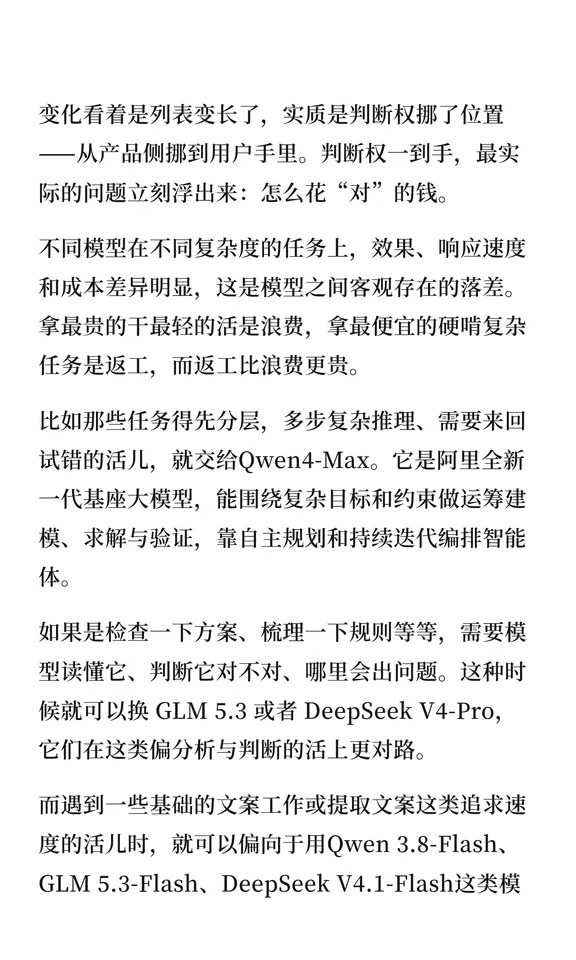
今天这套设定终于被改变了,千问办公一口气上线10款模型,包括刚刚发布的Qwen4-Max,以及 Kimi K3.1、GLM 5.3、DeepSeek、MiniMax、Step等一批三方大模型。模型列表已经向用户开放选择,个人版和企业标准版用户可以按自己的场景挑。此前它给的是标准、高级、Qwen3.8-Max三档,现在等于把每一档背后的具体型号摊到了台面上。
变化看着是列表变长了,实质是判断权挪了位置——从产品侧挪到用户手里。判断权一到手,最实际的问题立刻浮出来:怎么花“对”的钱。
不同模型在不同复杂度的任务上,效果、响应速度和成本差异明显,这是模型之间客观存在的落差。拿最贵的干最轻的活是浪费,拿最便宜的硬啃复杂任务是返工,而返工比浪费更贵。
比如那些任务得先分层,多步复杂推理、需要来回试错的活儿,就交给Qwen4-Max。它是阿里全新一代基座大模型,能围绕复杂目标和约束做运筹建模、求解与验证,靠自主规划和持续迭代编排智能体。
如果是检查一下方案、梳理一下规则等等,需要模型读懂它、判断它对不对、哪里会出问题。这种时候就可以换 GLM 5.3 或者 DeepSeek V4-Pro,它们在这类偏分析与判断的活上更对路。
而遇到一些基础的文案工作或提取文案这类追求速度的活儿时,就可以偏向于用Qwen 3.8-Flash、GLM 5.3-Flash、DeepSeek V4.1-Flash这类模型,它们的定位本来就是响应快、价格更低的一档。
企业侧也一起放开了。管理员可以按部门、用户组或者成员配置模型权限,不同岗位、不同复杂度的工作配不同档位。“按任务配模型”于是从一个用户的个人习惯,变成组织可以统一安排的事——写标书的、跑数据的、做设计的各拿各的,AI资产才算真的被管起来。
模型从三档变成十款,列表本身不构成进步,配得准才算。真正被改掉的是一句默认判断:以前是“有什么用什么”,现在是“这活该配哪一档”。这笔账算清楚了,Agent 才算从“能用”走到“划算”。
#ai #AI办公 #工作效率