实测Kimi 3.1 pro 在证券领域进步了多少?
Kimi K3.1 Pro 发布时提到,金融研究和长程Agent能力都有明显提升。我们拿 10 道按证券一线岗位真实委托设计的交付题,对比了它和上一代Kimi K3的差距。交上来的 Excel 和 Word,我们逐项复核:
📊 均分涨了 11 分,关键项只涨了 3 个百分点
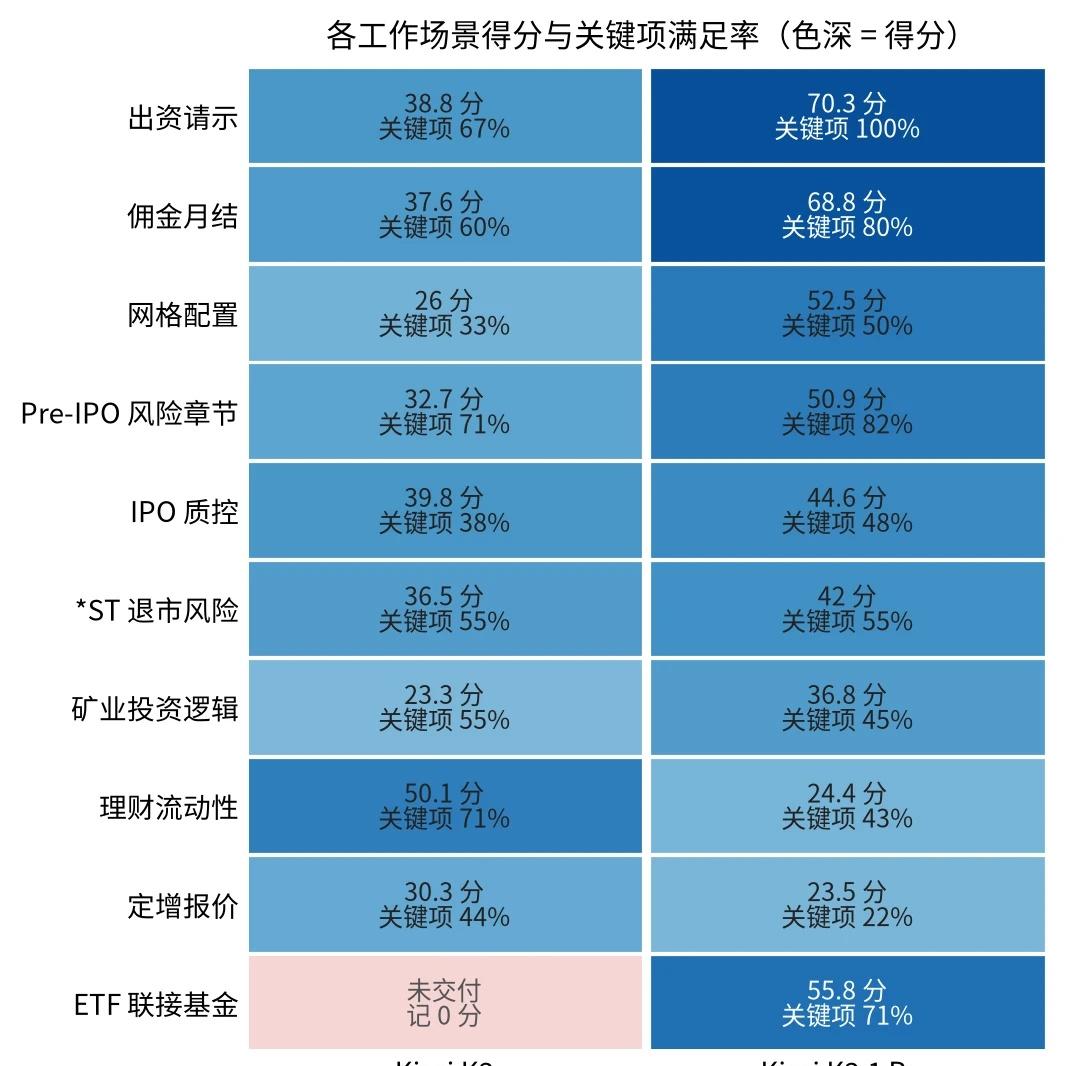
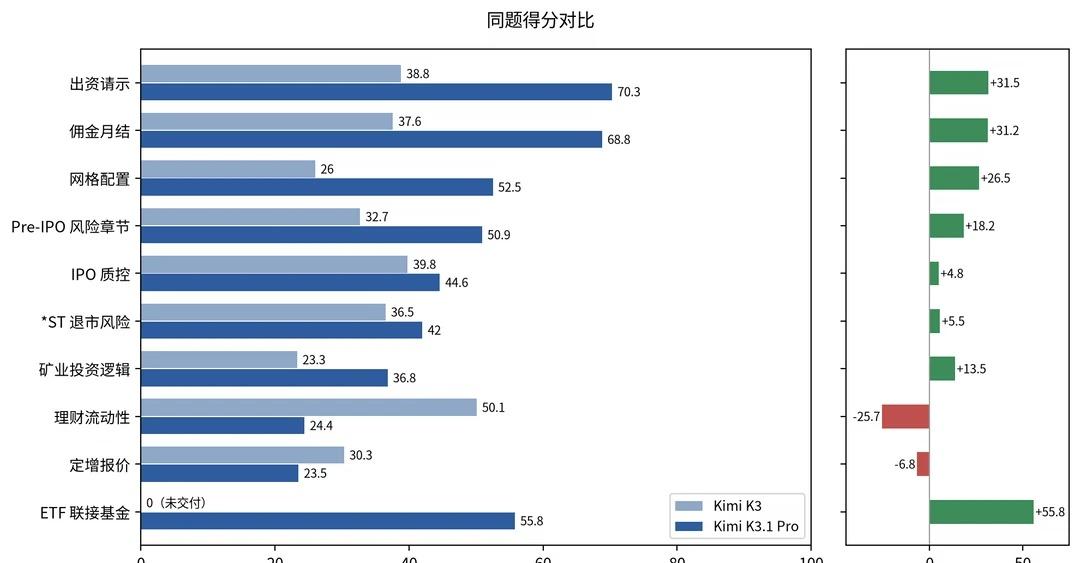
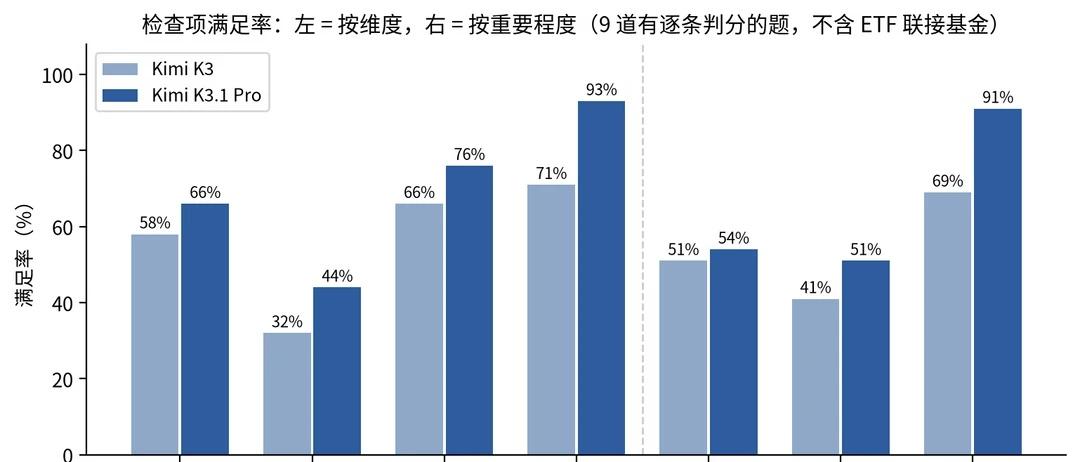
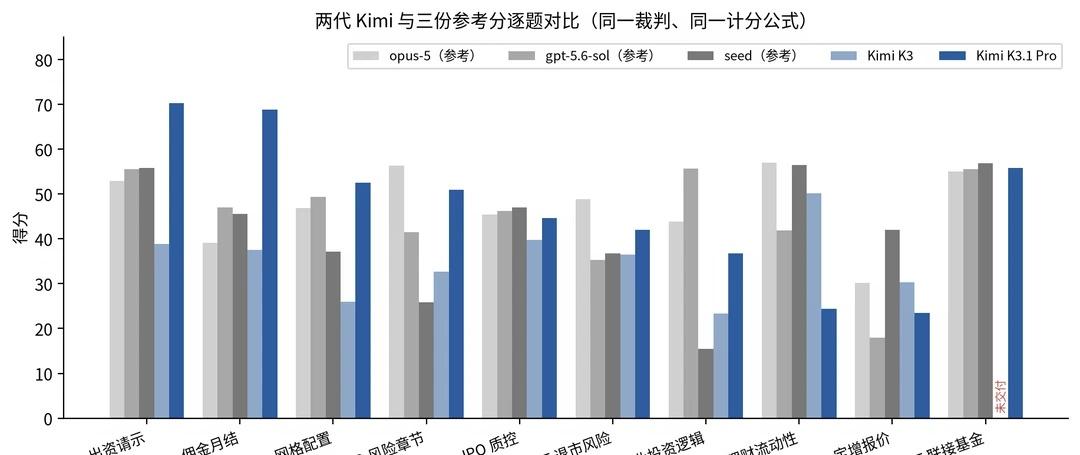
两代 Kimi 用同一套 Agent 和沙箱做 10 道证券实务题,每题附 5–12 份材料,由模型裁判逐项核查。双方都交付的 9 题中,均分 35.0 → 46.0,Pro 领先 7 题、落后 2 题。格式满足率 71% → 93%,逐题平均关键项满足率 55% → 58%(按检查项汇总为 51% → 54%)。ETF 联接基金题,K3 三次未交付,Pro 得 55.8 分。计入这题,10 题均分 31.5 → 47.0。
🔍 出资请示拿了最高分,算可用现金却漏了条件
Pro 在出资请示、佣金月结两题拿到 70.3、68.8 分,均比上一代高 30 分以上,也是各题五款模型中的最高分。流动性压力测试低了 25.7 分。Pro 漏筛账户类型,把受限保证金和待交收资金算进可用现金,连带算错缺口、覆盖率和回购额度。两代都算错了定增档位累计规则。Pro 还出现过表号写得清楚、数字却对不上源表的情况。
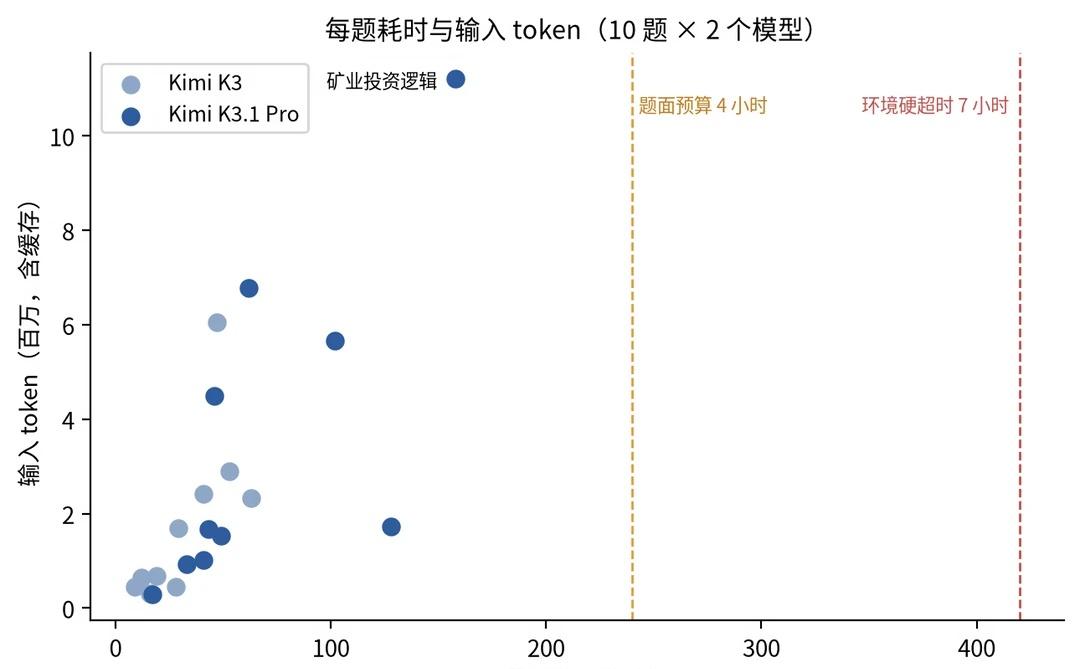
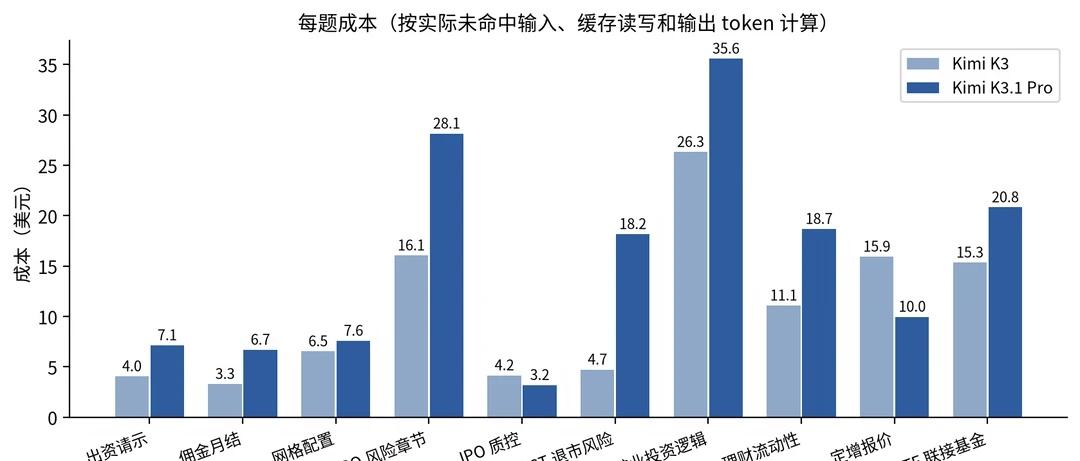
⏱️ 平均每题 32 → 68 分钟,总成本 107 → 156 美元
Pro 单价更低,输入 Token 接近翻倍。按双方均交付的 9 题算,Pro 每分成本高约一成。同题均分中,Pro(46.0)接近 opus-5(46.7),高于 gpt-5.6-sol(43.4)和 seed(40.2)。
现阶段,可以让 AI 梳材料、搭底稿、写初稿。正式交付前,人工重点核对筛选条件、取数规则、舍入精度,以及报告数字能否对上底稿和原表。
*测评数据来自本次运行记录
AI测评 Kimi 证券行业 金融研究 AI搞事业howto 大模型 AI人工智能 证券