绕开GPU的“换道超车”:灵晟用全CPU架构把超算和智算焊在一起
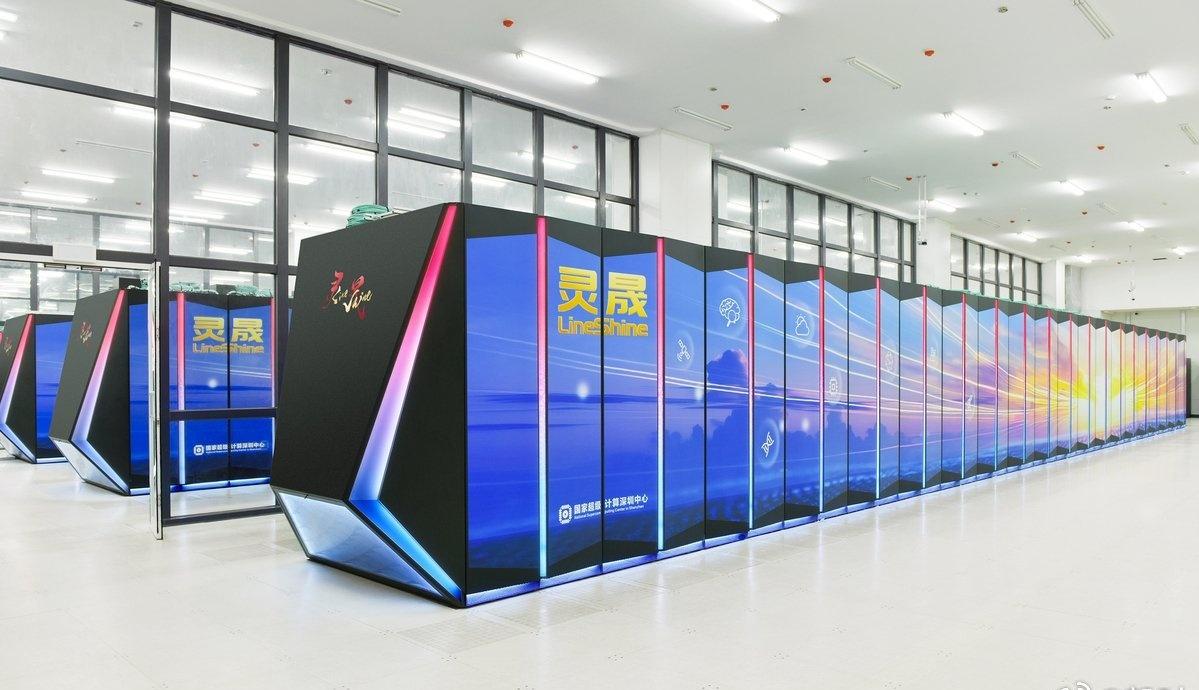
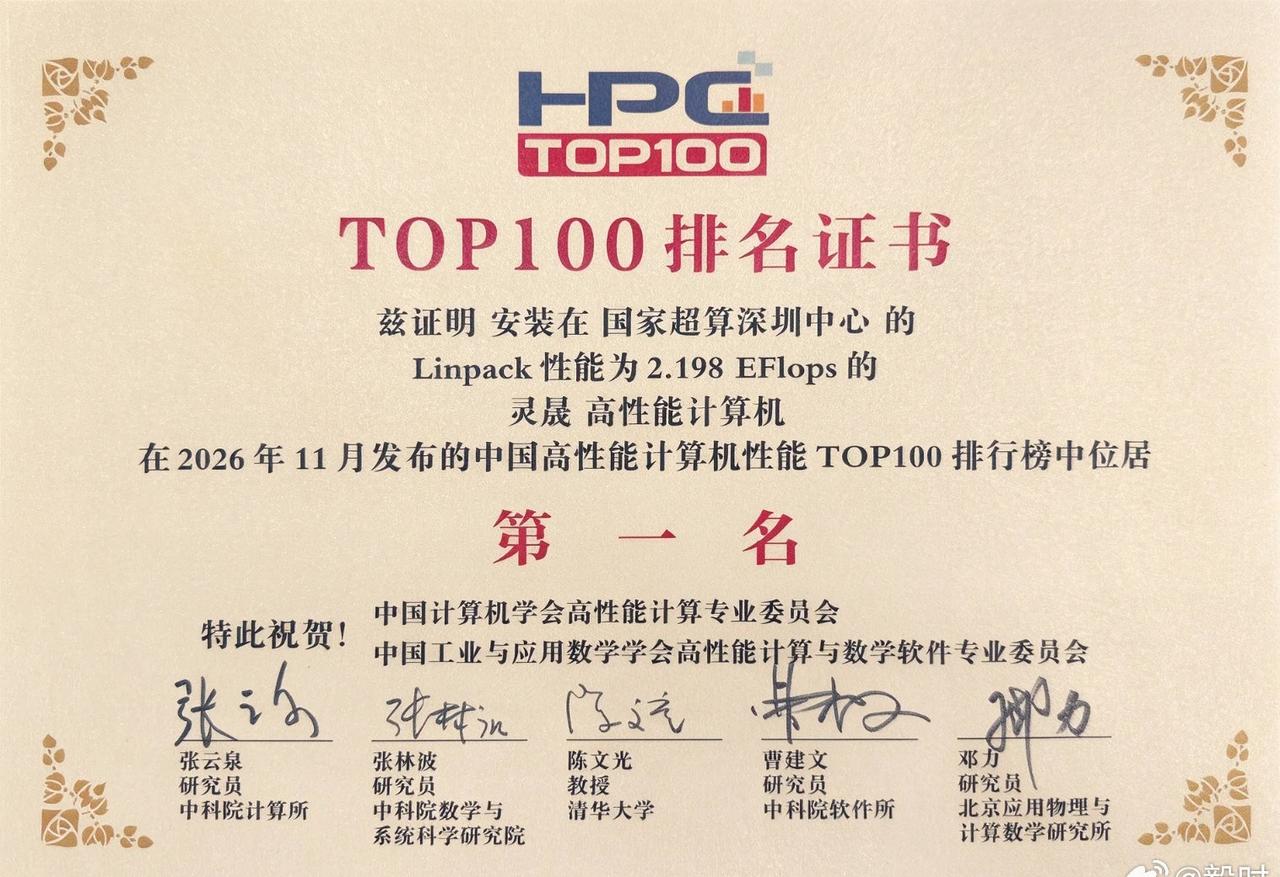
2026年11月,国家超级计算深圳中心“灵晟”以2.198 EFlops的Linpack双精度性能位列中国超算TOP100榜首。半年多前,它已在ISC2026上登顶全球TOP500,并拿下HPCG榜单第一,成为“双料冠军”。
真正让“灵晟”区别于El Capitan、Frontier的,是它没有走堆GPU加速卡的路线。它首创全CPU的Online Acceleration架构,把矩阵加速单元直接做进LX2 CPU内部,让计算与加速在同一块芯片上完成,省掉了CPU与GPU之间反复搬运数据的开销。配合国产高带宽内存、灵启高速互连与全液冷散热,从芯片到系统软件实现了全栈自主。
这套架构的指向很明确:HPC与AI的融合,不必依赖异构堆叠。上线数月,已支撑遥感大模型端到端训练、单日十万亿级化合物虚拟筛选等应用,平均扩展效率达84.4%。灵晟的意义不在于多了一个全球第一,而在于它证明了超算通往科学智能的路,可以不由GPU定义。