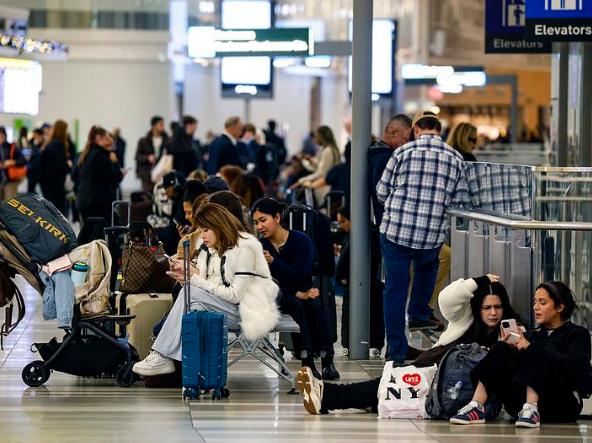
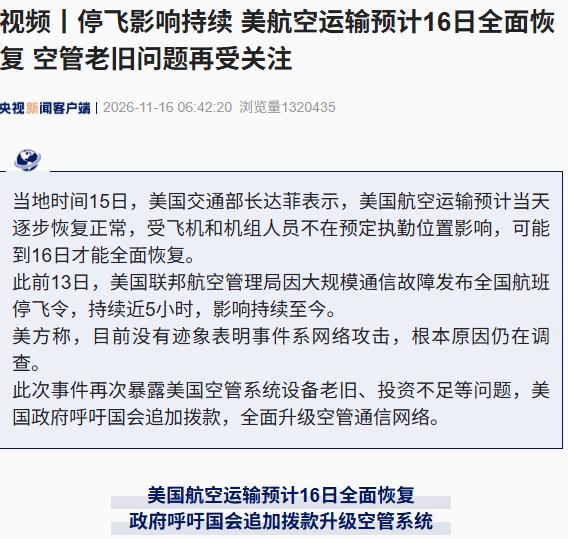
一根铜缆,凭什么让整个美国的天空“掉线”?近万架次航班取消或延误,17个区域空管中心受影响。表面看,这是一次升级调试中的“技术意外”;往深里看,它更像一场被推迟了很多年的系统性体检,终于以最难看的方式交出了报告。
按目前披露的说法,承包商L3哈里斯负责升级改造,把老式铜缆换成光纤。方向没错,但在安装调试路由器时出现异常:设备每四五秒就向外发起上千次连接请求,相当于一台机器在网上不断刷屏、狂发垃圾数据,形成数据洪峰。
这套通信网连着全美22个区域空管中心里的17个,老路由器、交换机扛不住这种“骚扰式刷屏”,过载卡死,管制中心与飞机之间的联络随之中断。看到没?真正致命的不是那根被换掉的铜缆,而是新旧系统交接时那个没人完全摸透的“接口”。
现代化最危险的时刻,往往不是旧系统还在跑,而是新系统已经来了、旧系统还没退、两者被迫同床共枕的时候。信号卡了,飞机为什么就不能飞?很多人第一反应是:雷达不是还看得见吗?问题恰恰在于,空管的核心从来不只是“看见”,而是“传话”。
航空安全有一条铁规矩:空管看不见飞机、没法传递位置和间隔指令,就不能放行。整个美国的天空就像一个超大的网约车调度平台,空管员是调度员,飞行员是司机。正常情况下,调度随时告诉司机哪条路堵、哪里修路、在哪靠边。
现在的情况,不是雷达看不见飞机,而是调度和司机的对讲线路掉线了:调度喊不出指令,飞行员也收不到最新的安全提醒。这时候还让飞机往上冲,等于闭眼盲开,很容易在空中玩“碰碰车”。
所以,一刀切停飞不是反应过度,而是安全冗余的必然代价——天上飞的可以落地,地面上的先别起飞。这也是美国自2001年“9·11”恐怖袭击事件以来,规模最大的一次全国性停飞。
其实,美国空管系统的老化,是一笔拖了几十年的账。2007年推出的下一代航空运输系统计划,原本想用卫星导航和数字通信取代陆基雷达,预算数百亿美元级,结果进度一拖再拖、成本一涨再涨,很多核心环节至今仍在“过渡期”。
2023年1月,NOTAM系统故障导致全美航班短暂停飞,上万架次受影响;2022年冬季,西南航空因调度系统老旧叠加风暴,取消上万架次;2024年7月,一家安全软件公司的更新失误让全球Windows设备蓝屏,达美航空又取消数千架次。
把这些事件排在一起看,规律很清楚:现代航空不是败在飞机不够先进,而是败在地面那套“看不见的操作系统”太脆。飞机越来越智能,空管后台却像一台补丁摞补丁的祖传电脑,平时能开机,一装新驱动就蓝屏。
更值得追问的是治理结构。这次升级由承包商操刀,政府监管,老设备继续服役,责任界面天然模糊。出了事,承包商说“按规范调试”,监管方说“根源仍在调查”,航空公司只能取消航班。
专业的事交给专业的人,本身没啥问题。问题在于,当关键基础设施的“现代化”被拆成一份份采购合同、一个个预算周期、一层层验收流程时,系统级的风险很容易被切碎,最后谁都不对“整体能不能扛住”负总责。
旧设备为什么没换?因为换不起、停不下、审批慢;新设备为什么一上就出事?因为测试环境永远模拟不出真实网络的复杂度。于是形成一个尴尬循环:不升级,等死;升级,可能猝死。
其实,所谓韧性并不等于堆冗余,冗余也不等于安全。传统思路是“多备一套”,可如果备份系统和主系统同源、同架构、同供应商,那它只是把单点故障变成了“双份单点故障”。真正的韧性,是允许系统“降级运行”:
新路由器发疯时,老通道能不能自动隔离?数据洪峰涌来时,有没有限流和熔断?管制员能不能在失去部分自动化的情况下,用更原始但可靠的方式维持最低限度放行?这次事件暴露的,恰恰是“全有或全无”的脆弱——要么正常,要么全国停飞,中间缺少缓冲地带。
美国航空能按预期恢复正常吗?短期看,大概率能。换掉异常设备、回滚配置、加限流策略,让系统重新上线,这是工程问题。但“恢复”不等于“修好”。只要老铜缆、老交换机、老逻辑还在网里,只要升级仍在“边飞边改”,下一次数据洪峰就只是时间问题!