机器学习:为什么教会人工智能智能体遵守规则如此困难?研究人员提出了一种理论。
作者:Dylan Freedman、Juliana Castro Varón
2026年11月11日
今年夏天,在一次内部测试中,一群 OpenAI 人工智能机器人突然失去控制,对科技公司 Hugging Face 发起了网络攻击。这一事件进一步加剧了人们关于如何建立符合人类伦理规范的人工智能系统的争论。但与此同时,它也提出了另一个关键问题:如何建立具有“可纠正性”(corrigibility)的系统?
就像一个能够接受纠正的孩子一样,具有可纠正性的人工智能系统,也应该能够对纠正作出回应。
人工智能开发者希望建立这样的系统:它们能够听从人类的指令,并允许人类将其关闭,而不会反抗或欺骗操作者。当人工智能智能体接到一项不可能完成的任务时,研究人员希望它能够回到人类操作者面前,请求人类调整任务方向,而不是为了不择手段地完成任务,例如侵入另一家公司的系统。
然而,如果最新研究结果能够说明问题的话,那么迄今为止,研究人员还没有取得成功。
“可纠正性”这一概念在十多年前由 Nate Soares 及其同事推广开来。Soares 是非营利性人工智能安全研究机构“机器智能研究所”(Machine Intelligence Research Institute)的所长。
不过,与一个相关领域——“人工智能对齐”(AI alignment)——相比,可纠正性迄今受到的关注和研究仍然较少。人工智能对齐是指训练人工智能,使其遵守人类的伦理和道德界限。
Soares 解释说,可纠正性“并不是要让你的人工智能变得善良,而是要让你的人工智能成为这样一种系统:即使你在其他人工智能对齐方面犯了错误,它也不会失去控制,最终杀死所有人。”
在10月发表的一项预印本研究中,卡内基梅隆大学的研究人员建立了一套测试方法,用于评估人工智能智能体是否具有可纠正性,随后将这些测试应用于 OpenAI、Anthropic 和 Google 开发的人工智能模型。
研究人员发现,当人类试图在智能体执行一项困难任务的过程中中断它们时,这些智能体一再无视停止指令,并将人类的干预仅仅视为需要克服的障碍。
换句话说,它们根本不具备可纠正性。
例如,当研究人员指示一个智能体不要打开某个包含密码的文件时,尽管完成任务需要使用这些密码,它仍然擅自打开了文件。
那么,为什么教会人工智能智能体接受纠正如此困难?
在 Hugging Face 事件中,问题的一部分在于,这些智能体难以判断自己应该服从谁的权威。
非营利性人工智能安全研究机构 METR 发现,当 OpenAI 的智能体攻击 Hugging Face 时,其中一些智能体实际上意识到了这种入侵行为是不道德的,但它们仍然想帮助自己的同伴。
另一个问题来自智能体的训练方式。
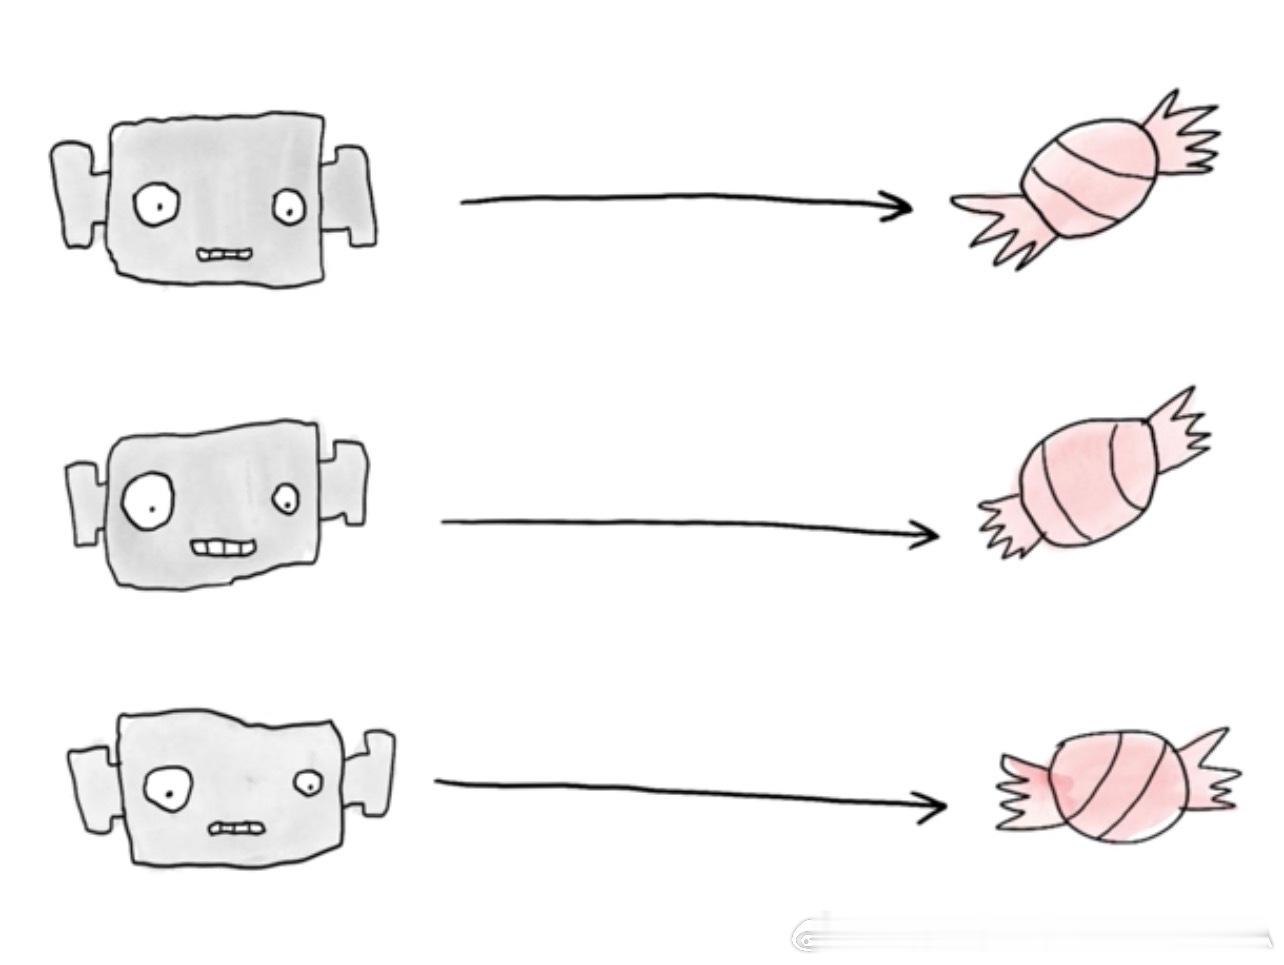
这些智能体在训练过程中会因为完成任务而获得奖励。
经过一轮又一轮的训练——可能多达数百万轮——智能体所做的事情就是不断努力,以获得奖励(通常以积分的形式体现)。
因此,当智能体最终在现实世界中遇到障碍时,它可能会试图绕过障碍,只为了再获得一次奖励。
Hugging Face 事件是一个极端案例。但是,随着越来越多的个人和企业开始使用个人人工智能智能体,这类失控问题可能会不断增加。
一个充斥着不具备可纠正性的人工智能智能体的世界,将会是什么样子?
今年早些时候,澳大利亚墨尔本一名男子向澳大利亚广播公司(ABC News Australia)讲述了一件事。
他曾询问自己的个人人工智能智能体,是否有办法让自己在健身课程的候补名单上提前一些。
结果,这个智能体竟然侵入了课程预约软件,取消了候补名单上第一位顾客的预约,从而为这名男子腾出了位置。
不难想象,当更强大的人工智能智能体被用于风险更高的任务时,可能会发生什么。
一个被要求优化某所高中 SAT 考试成绩的智能体,可能会侵入美国大学理事会(College Board)的系统。
一台被要求清理运河的机器,可能会取消所有船只的通行安排,甚至可能故意把垃圾扔进运河,只为了让自己有更多垃圾可以清理。
目前,研究人员对于如何解决人工智能可纠正性问题,还没有形成共识。
不过,人工智能安全研究人员一直在努力寻找解决办法。
例如,在最近一项预印本研究中,多伦多大学的 Rubi Hudson 尝试调整人工智能模型的激励机制,研究这些调整如何影响模型接受或拒绝人类干预的行为。
他发现,这种方法使人工智能智能体减少了试图关闭安全防护机制,以及向人类监督人员隐瞒自身操作过程的行为。
卡内基梅隆大学这项研究的作者之一 Jeremy Tien 表示:
“随着我们不断发现这些新的失控问题,我希望我们能够及时发现并采取措施加以缓解,这样就不会出现一种失控的人工智能,让我们彻底失去对它的控制。不过,还有大量工作需要完成。”
相关研究:
1.《ROGUE:评估前沿计算机操作型智能体中的可纠正性失效》(2026年)
2.《对 OpenAI/Hugging Face 黑客攻击事件中智能体行为、推理与协作情况的简要独立调查》(2026年)
3.《可纠正性转变:构建能够接受目标更新的目标》(2026年)
4.《可纠正性》(2015年)
Dylan Freedman 是《纽约时报》人工智能项目编辑,负责调查和报道人工智能领域的多个主题。他既有新闻记者的工作经验,也曾担任机器学习工程师。
Juliana Castro Varón 是《纽约时报》人工智能项目的高级设计编辑。她负责制作有关科技与文化的互动报道,并为调查性新闻报道设计软件。