国产AI大模型再突破!腾讯混元文生视频模型开源,性能比肩Sora
全球文生视频的天花板,根本不是大家吹爆的Sora!
之前全网都默认国产文生视频大模型追平Sora至少还要三五年,结果腾讯混元刚放出来的公测成绩单,直接把所有人的脸都打肿了。
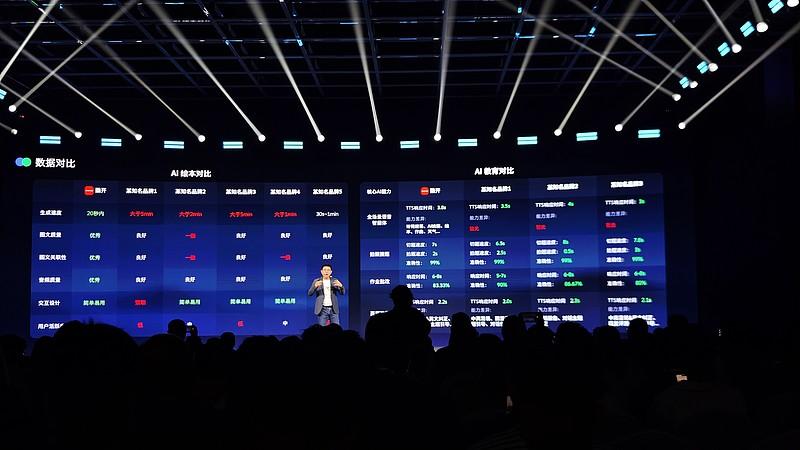
数据摆出来明明白白:文本对齐能力比Sora领先14.1个百分点,运动画面质量领先11.8个百分点,核心视觉质量直接和Sora完全持平。
比OpenAI晚发布好几个月的混元,现在生成冲浪、跳街舞这类大动态的画面,流畅度高到你逐帧挑都找不出卡顿bug。
这个只有130亿参数的大模型,是目前市面上最大的开源视频大模型之一。
你要生成古建筑飞檐翘角的精细纹路,传统服饰上的刺绣暗纹,刚出锅的中式美食油亮的色泽,它的还原度高到离谱。
第三方评测机构给它的视觉质量打分95.7%,实打实和Sora站在了同一条水平线上。
技术路线上它和Sora一样走的是DiT架构扩散模型,但腾讯偷偷在细节上做了三处没人想到的狠升级。
第一是适配了新一代文本编码器,你哪怕给它输入好几个主体的复杂剧情描述,它全能精准理解,不会乱生成八竿子打不着的内容。
第二是采用了统一全注意力机制,跨镜头转场丝滑到不行,再也不会出现上一秒是古装侠客下一秒突然冒出现代汽车的跳戏bug。
第三是自研了图像视频混合VAE,之前所有AI视频都解决不了的小人脸糊成马赛克、高速运动镜头拖影的老毛病,直接被它根治了。
最狠的操作还得是全开源。
模型权重、推理代码、全套算法直接挂在Hugging Face和GitHub上,企业和个人开发者点进去就能免费拿,随便改随便商用都没人管。
这意味着什么?
开广告公司的都懂,以前拍一条创意短片,租场地租演员搭景大几万打不住,现在用混元生成,成本直接降到传统拍摄的几十分之一。
做影视行业的更赚,开机前先用混元跑一遍全片概念验证,哪里逻辑不通哪里画面不对提前调整,省下的都是几百万上千万的真金白银。
腾讯这波打法特别务实,先啃企业端市场。
API按使用量付费,价格直接定成同类国际产品的六到七折,还拍胸脯承诺所有用户数据绝对不会流出境内。
对国内合规要求严格的国企、金融、政务类企业来说,光这两条,就比用海外模型香一百倍。
普通个人用户也不用急,混元已经在往微信视频号、腾讯视频里部署了,过不了多久普通人随手就能用AI生成自己想要的短视频。
而且这波国产AI的爆发,根本不是腾讯一家的独角戏。
阿里的QwQ-32B靠大规模强化学习,直接在数学和代码领域捅破了国际天花板。
刚发布的Manus上线24小时就刷爆了整个国内AI圈。
更早出圈的DeepSeek,也是这波国产AI集体突围的代表产品。
这哪里是单个产品的胜利,分明是整个中国AI产业攒了好几年的劲,终于集体爆发了。
有调研机构测算,到2030年全球文生视频大模型市场规模能冲到22亿美元,年复合增长率超过56%,这块大蛋糕谁都眼红。
以前跟着别人的路线跑,追得再快也只能捡点剩下的残羹冷炙。
现在我们直接从追赶到并跑,实打实拿到了全球AI核心赛道的入场券。
接下来就看谁能先跑出完全属于中国团队的独家新赛道,到时候就该海外同行追着我们的脚步跑了。
就冲这波全开源的格局,你觉得国产AI接下来多久能实现反超?