Meta给Muse加上脸和嗓子,直接视频聊!
AI语音助手最尴尬的时刻,可能不是答错问题,而是你还没说完,它已经自顾自讲完了一大段。
Meta这次给 AI 补上的,恰好是更像真人对话的能力。
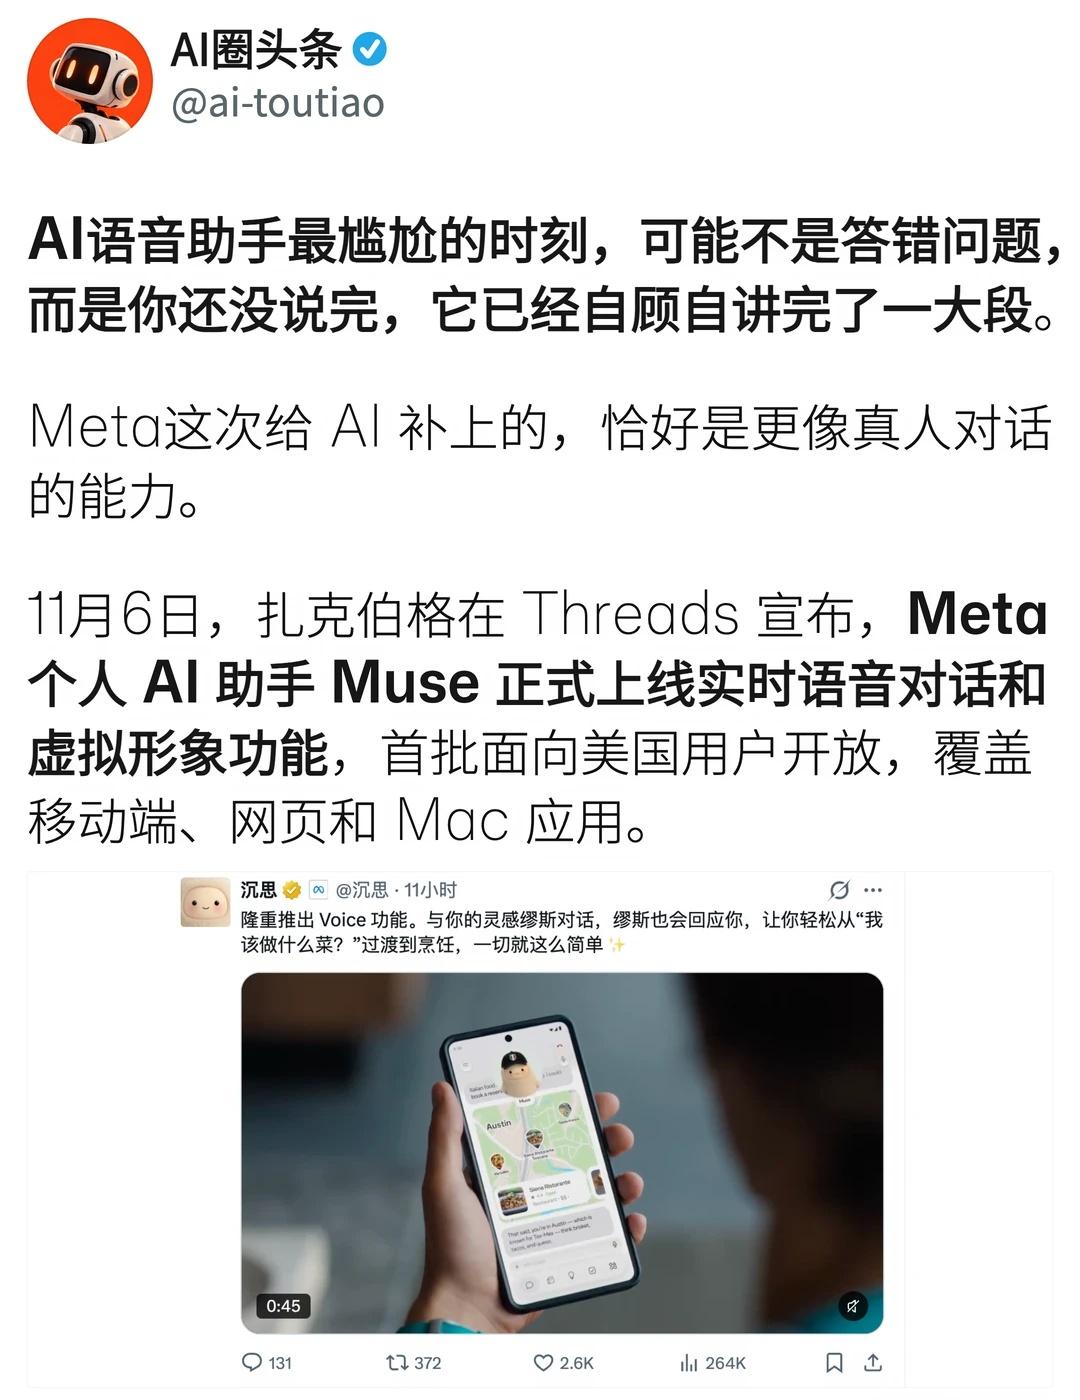
11月6日,扎克伯格在 Threads 宣布,Meta 个人 AI 助手 Muse 正式上线实时语音对话和虚拟形象功能,首批面向美国用户开放,覆盖移动端、网页和 Mac 应用。
打开 Muse,点击右上角的电话图标,就能直接开始视频式对话。更有意思的是,你可以随时打断它,不必等 AI 把一整段话说完。
背后是两个模型协同工作:Muse Realtime Voice 负责实时生成语音,不仅决定说什么,还决定怎么说;Muse Realtime Avatar 则根据同一路数据流生成表情、口型和动作,让声音与画面保持同步。
官方给出的技术指标也挺有意思:虚拟形象支持 448×768 分辨率、每秒25帧的视频流。从用户说完话,到收到第一个音画响应,约870毫秒。
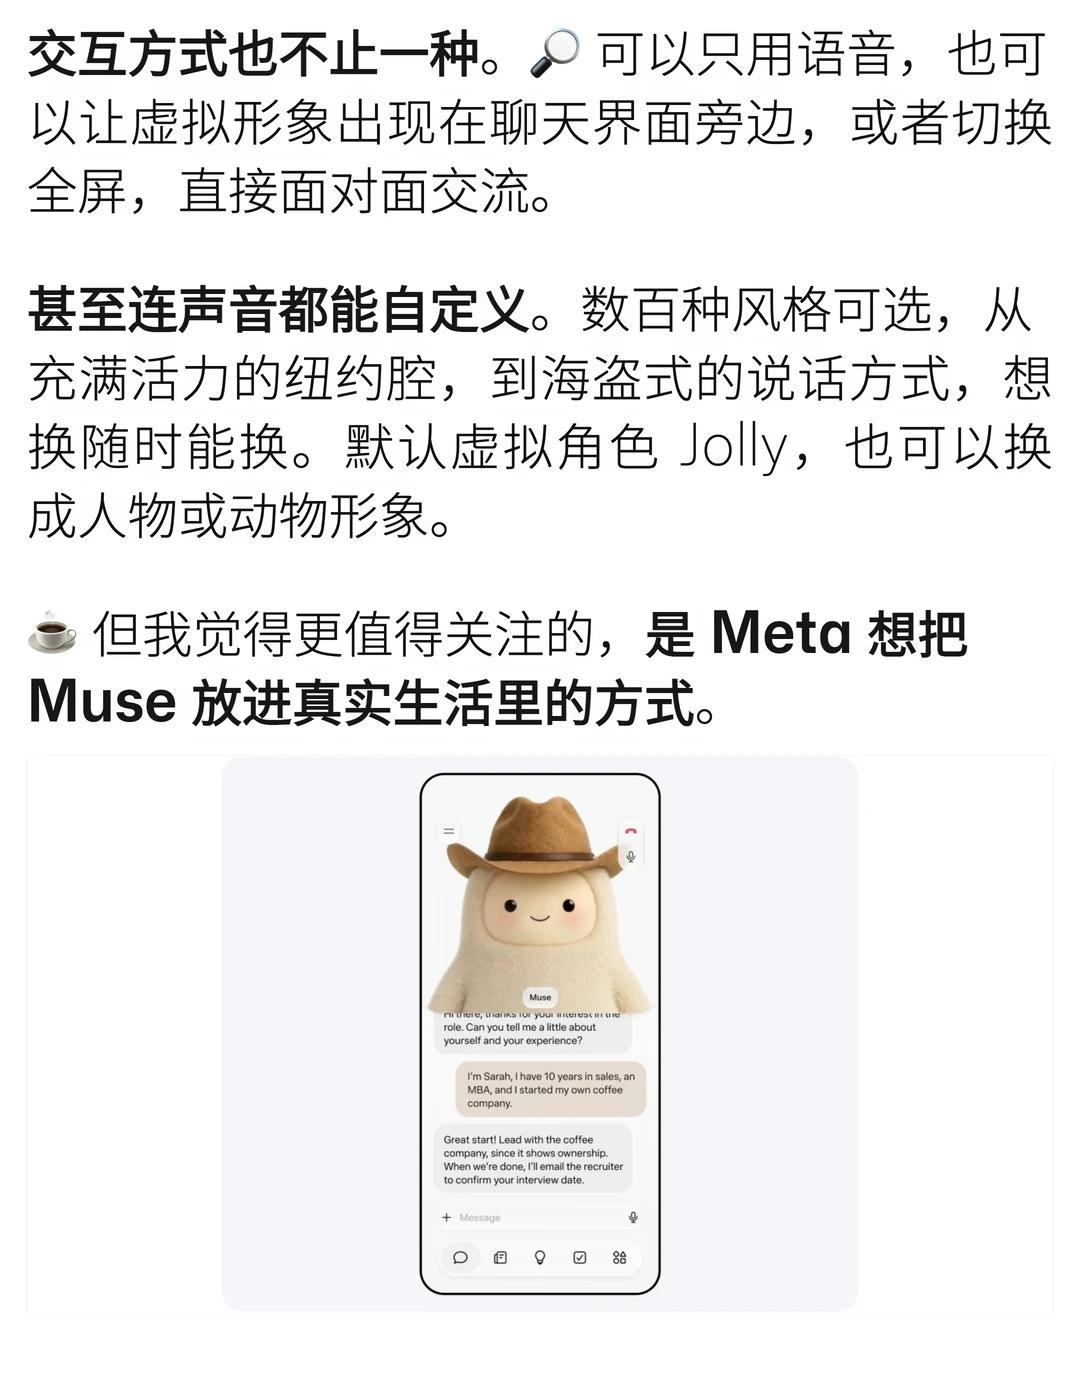
交互方式也不止一种。可以只用语音,也可以让虚拟形象出现在聊天界面旁边,或者切换全屏,直接面对面交流。
甚至连声音都能自定义。数百种风格可选,从充满活力的纽约腔,到海盗式的说话方式,想换随时能换。默认虚拟角色 Jolly,也可以换成人物或动物形象。
但我觉得更值得关注的,是 Meta 想把 Muse 放进真实生活里的方式。
比如散步、做饭、双手忙着的时候,直接开口告诉它要做什么,让它在后台继续处理。头脑风暴、旅行规划、面试彩排,也不必每次都先想好一套完整提示词,想到哪说到哪就行。
这次更新最值得观察的,其实不是 AI 有没有一张脸,而是它能不能跟上人类真实的说话节奏。
能听、能插话、能回应,还能通过表情和动作表达反应。AI 助手正在从一个等待指令的输入框,变成一个可以持续交流的交互对象。
接下来,AI 陪聊产品之间的竞争,可能真的要从声音卷到表情和真人感了。Meta Muse 人工智能 AI助手 实时语音 虚拟形象 AI视频聊天 多模态AI 智能体