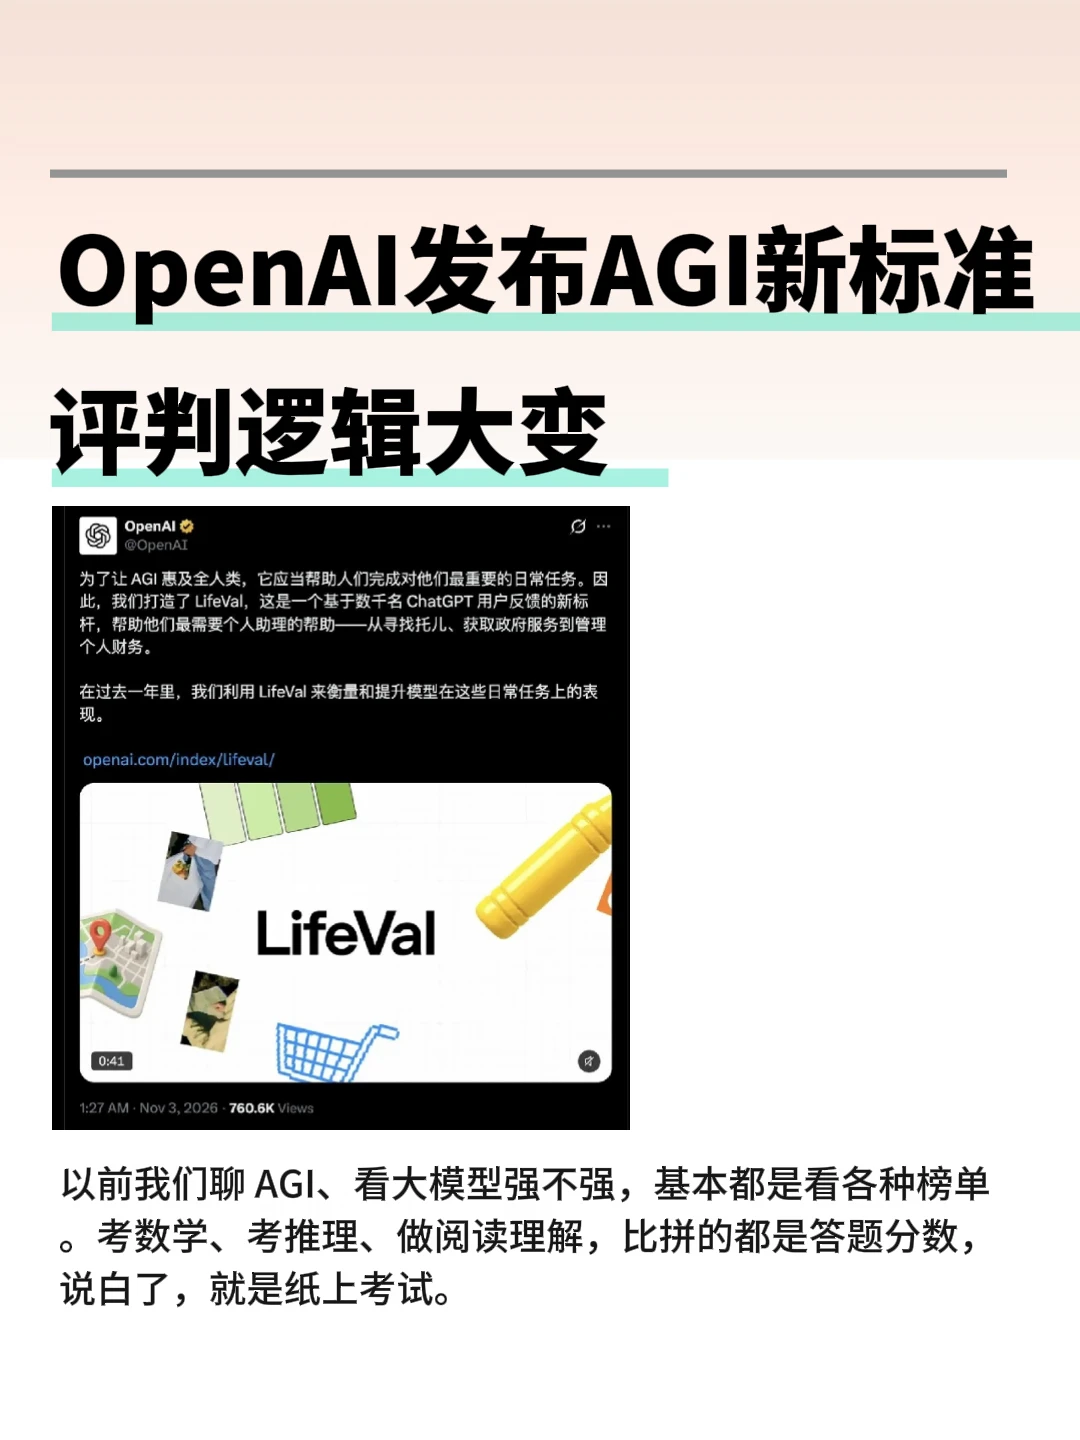
以前我们聊AGI、看大模型强不强,基本都是看各种榜单。 考数学、考推理、做阅读理解,比拼的都是答题分数,说白了,就是纸上考试。
但这次OpenAI 直接换了一套评判逻辑,推出了新的 AGI 评估基准。 不再把重点放在刷题库、答考题上面,考核场景直接搬到真实世界里。
它要看的不是 AI 会不会解一道固定题目,而是能不能自主理解目标、调用工具、一步步完成现实里复杂的任务。 像是跨平台处理信息、多步骤办事、遇到意外情况自己调整方案,把一整件事从头到尾闭环落地。
这套 ARC-AGI-3、LifeVal 评测体系一出来,整个行业的风向标都变了。 简单说:过去是 “会做题就是厉害”,未来是 “能办成事才算通用智能”。这也意味着,AGI 的竞争,已经从卷面分数的比拼,进入智能体落地能力的比拼。
到底什么样才算真正的通用人工智能?答案不再藏在试卷里,而是藏在真实、多变的现实场景中。 新标准落地之后,后续各家大模型的研发方向,都会跟着这条新标尺重新调整。AGI 赛道,正式开启下一个阶段的较量。
#OpenAI#AGI#AI前沿#大模型#智能体#未来科技#AIGC#人工智能