大模型真正的数据荒,其实才刚刚开始。
最近读到Open Athena团队的David Hall写的一篇博客,点破了一个行业真相:我们在大模型的“预训练”阶段运气太好了,但在“后训练”阶段,根本没有现成的数据池。过去五十年,人类通过维基百科、ArXiv和Common Crawl,攒出了10PB以上的公开文本。GPT-3有60%的训练语料直接来自这些现成文档。但现在AI向智能体进化,重心转向了强化学习的后训练。
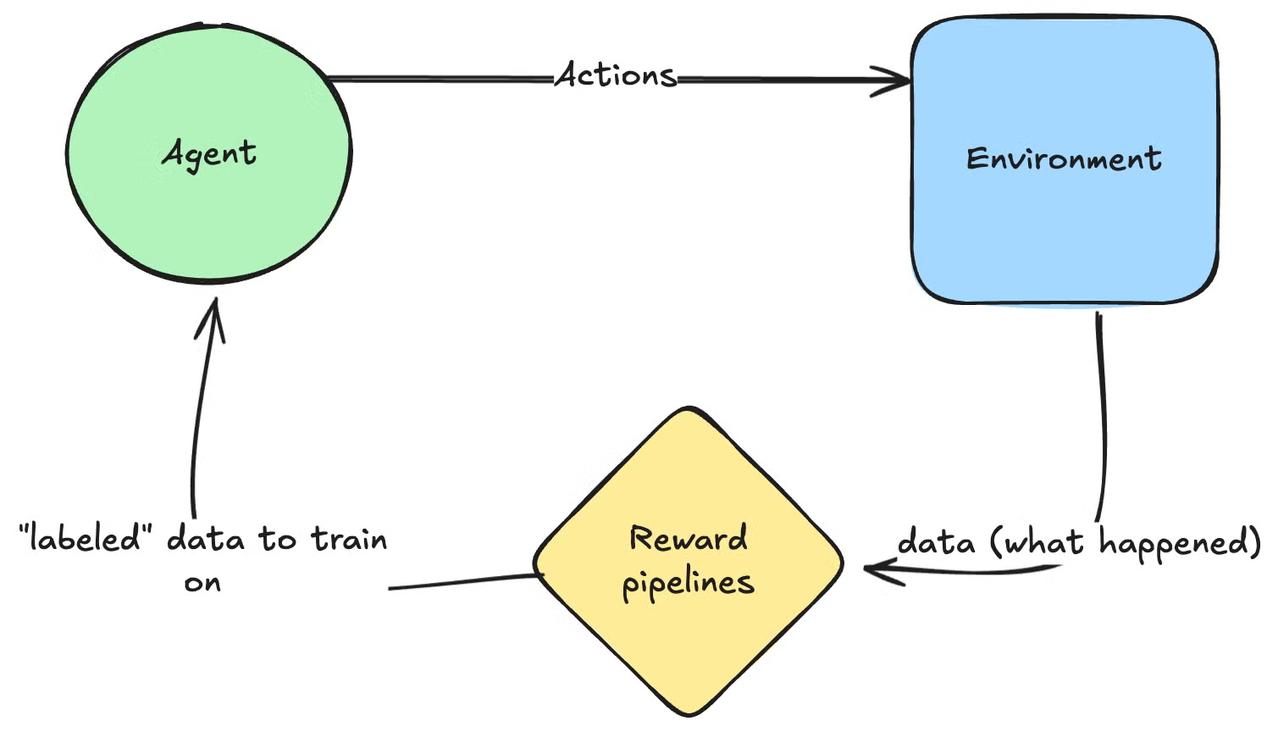
预训练吃的是静态“文档”,而后训练吃的是动态“任务”。
一个合格的强化学习任务,必须同时打包四个要素:环境状态、意图、操作工具和自动评分器。连数字化程度最高的软件工程都很难做到这一点。最著名的编程基准SWE-bench,抓取了GitHub上9万多个代码提交,清洗后发现只有2294个能跑通。后来OpenAI雇了93个资深程序员人工审核,又砍掉了三分之二,只剩500个可用。
连写代码都这么难,律师、医生、财务的工作过程更是随着具体情境生灭,根本没有现成的记录。
说白了,预训练是捡现成的果子,而后训练是一场重工业制造。
现在OpenAI等巨头正在花重金雇佣各行各业的专家,把他们脑子里的隐性工作流“刻录”成AI独占的私有资产。这也是为什么斯坦福衍生出的Marin社区和Hugging Face正在推动开源“智能体轨迹”,呼吁大家捐出工作流数据。
这件事对普通人是个巨大的提醒:AI时代的护城河已经变了。谁能把行业里那些难以言传的判断标准、试错过程,封装成可重复执行的标准化任务,谁就掌握了最高价值的资产。
你的工作如果只剩结果,很容易被替代;但如果你能定义并记录下解决问题的完整过程,你的工作数据就是训练AI最宝贵的素材。