腾讯混元的AI科学家换赛道:不解题了,改造工具
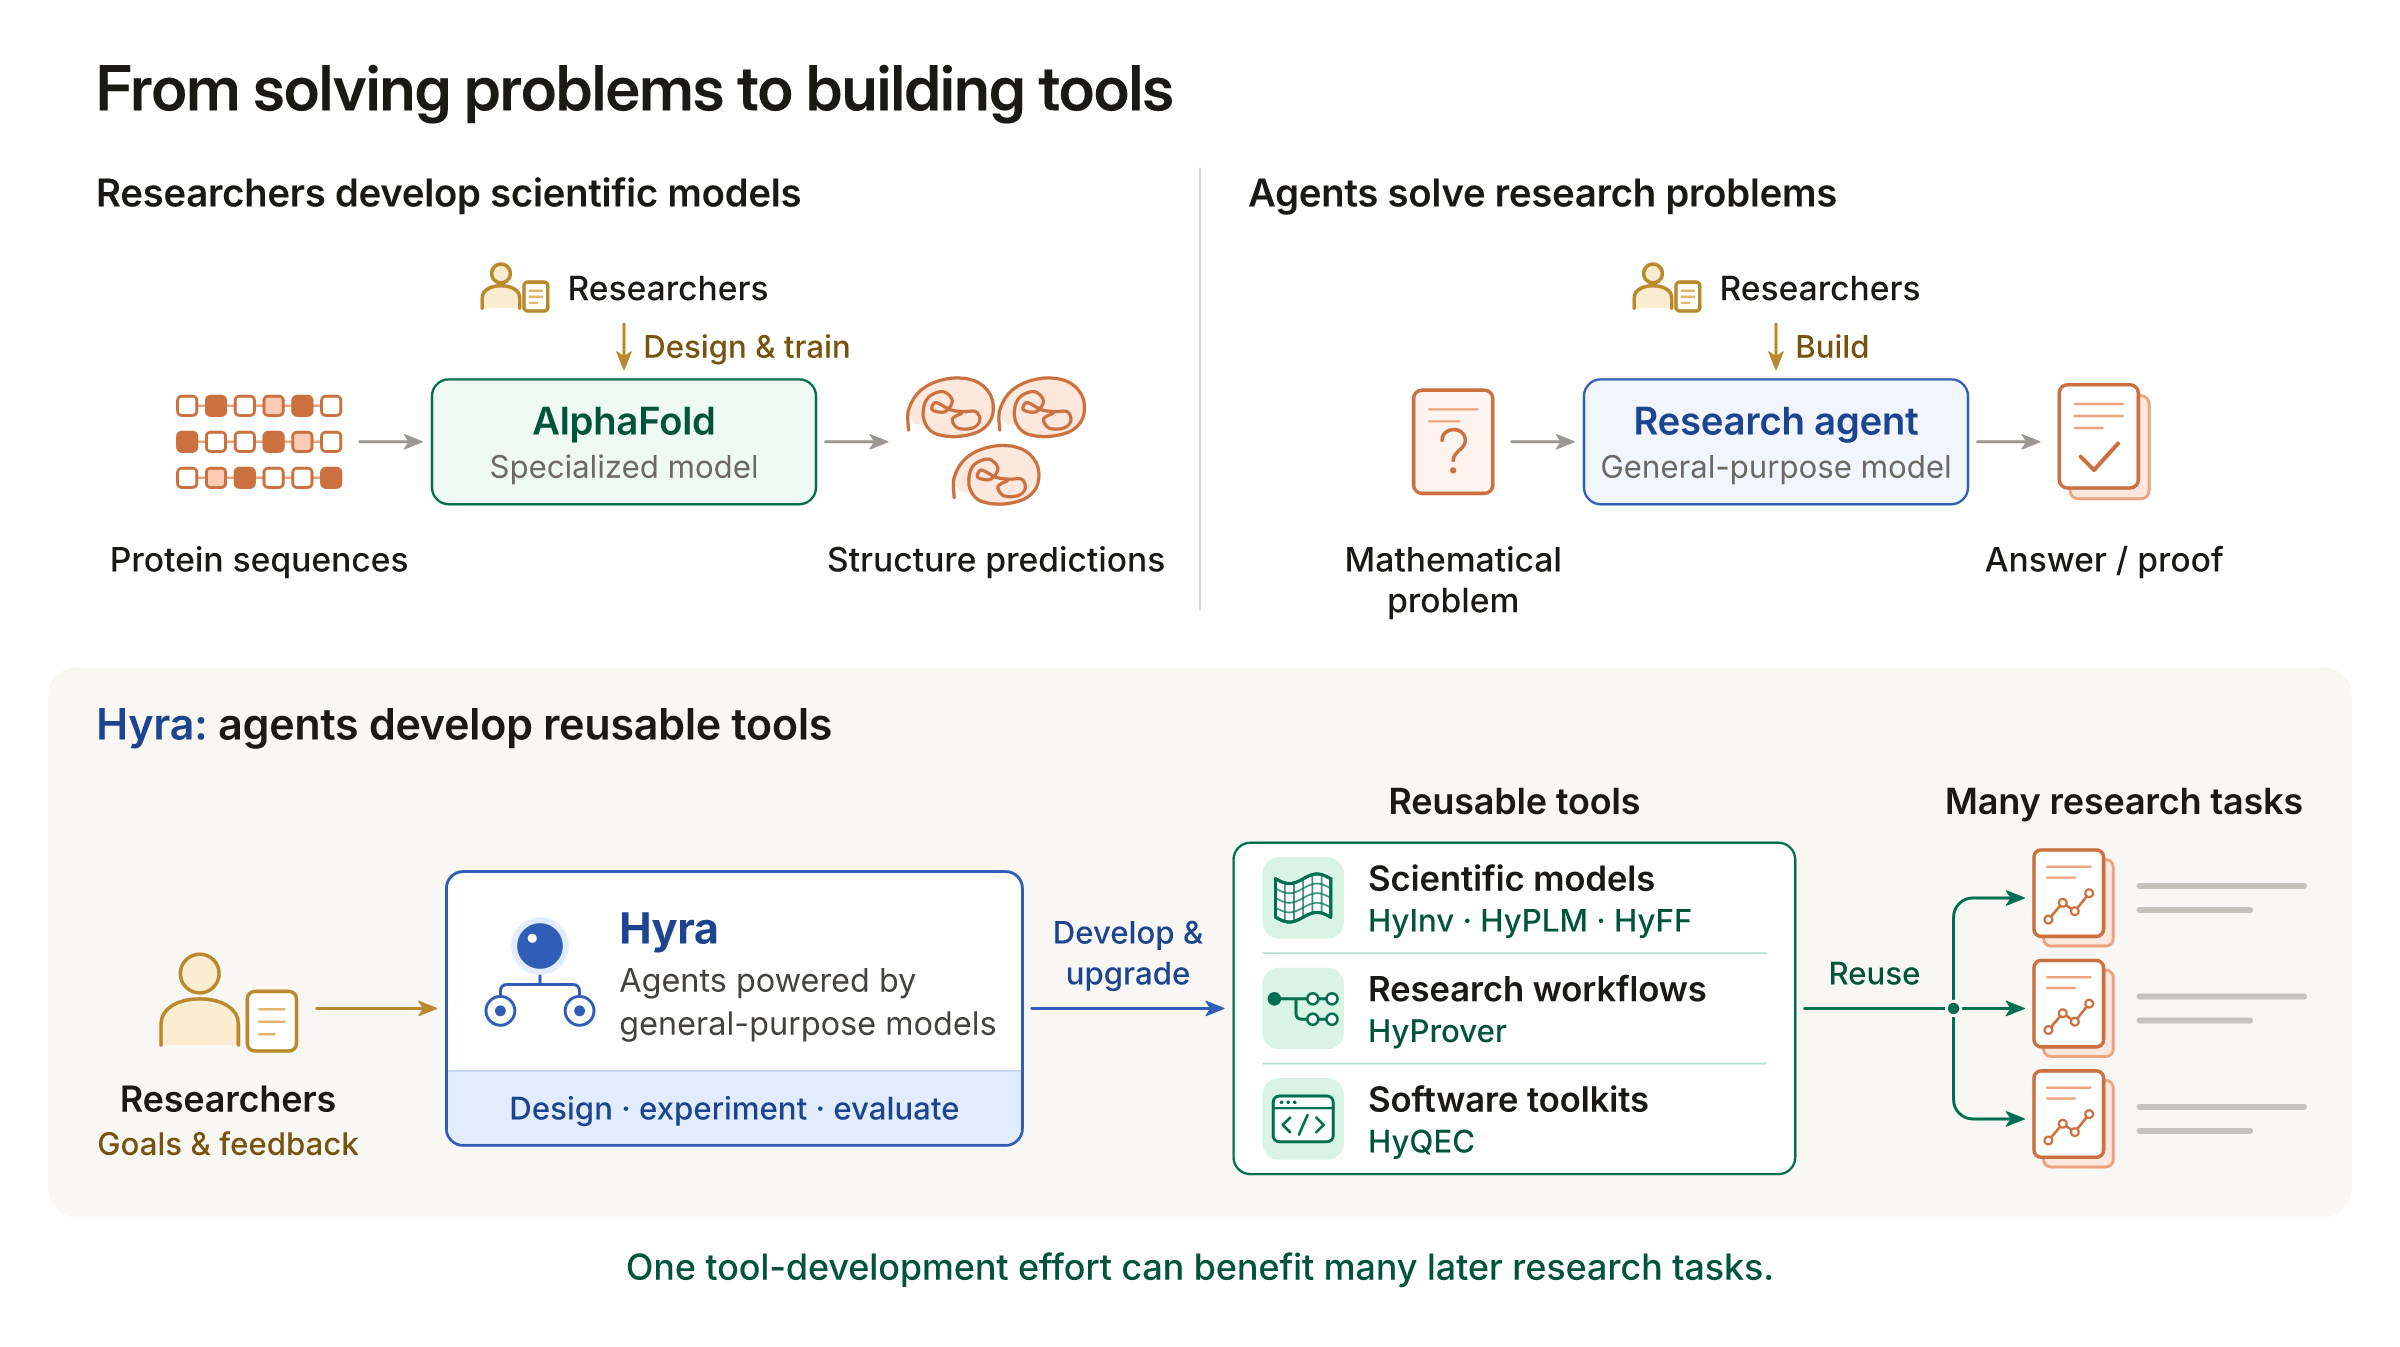
11月2日,腾讯混元发布 AI 科研系统 Hyra 2.0。落点很明确:不再让 AI 直接攻克科学难题,而是让通用 Agent 去研发和升级科学模型、研究工作流和软件工具。
逻辑得从三个月前说起。Hyra 1.0 发布一周后就驱动开源模型 Hy3 解决了加法组合学里悬置五十多年的问题,国产开源模型首次全自动解决数学开放问题。
但团队想明白了一件事:解题只收获一个答案,成果不会自动提升下一次研究的能力;升级一件工具,所有下游任务跟着受益,他们管这叫“智能复利”。
造工具比解题难管:训练一个模型动辄数天到数周,几条线并行,实验等待、资源分配、改方向,一个不断延长的 agent 会话罩不住。
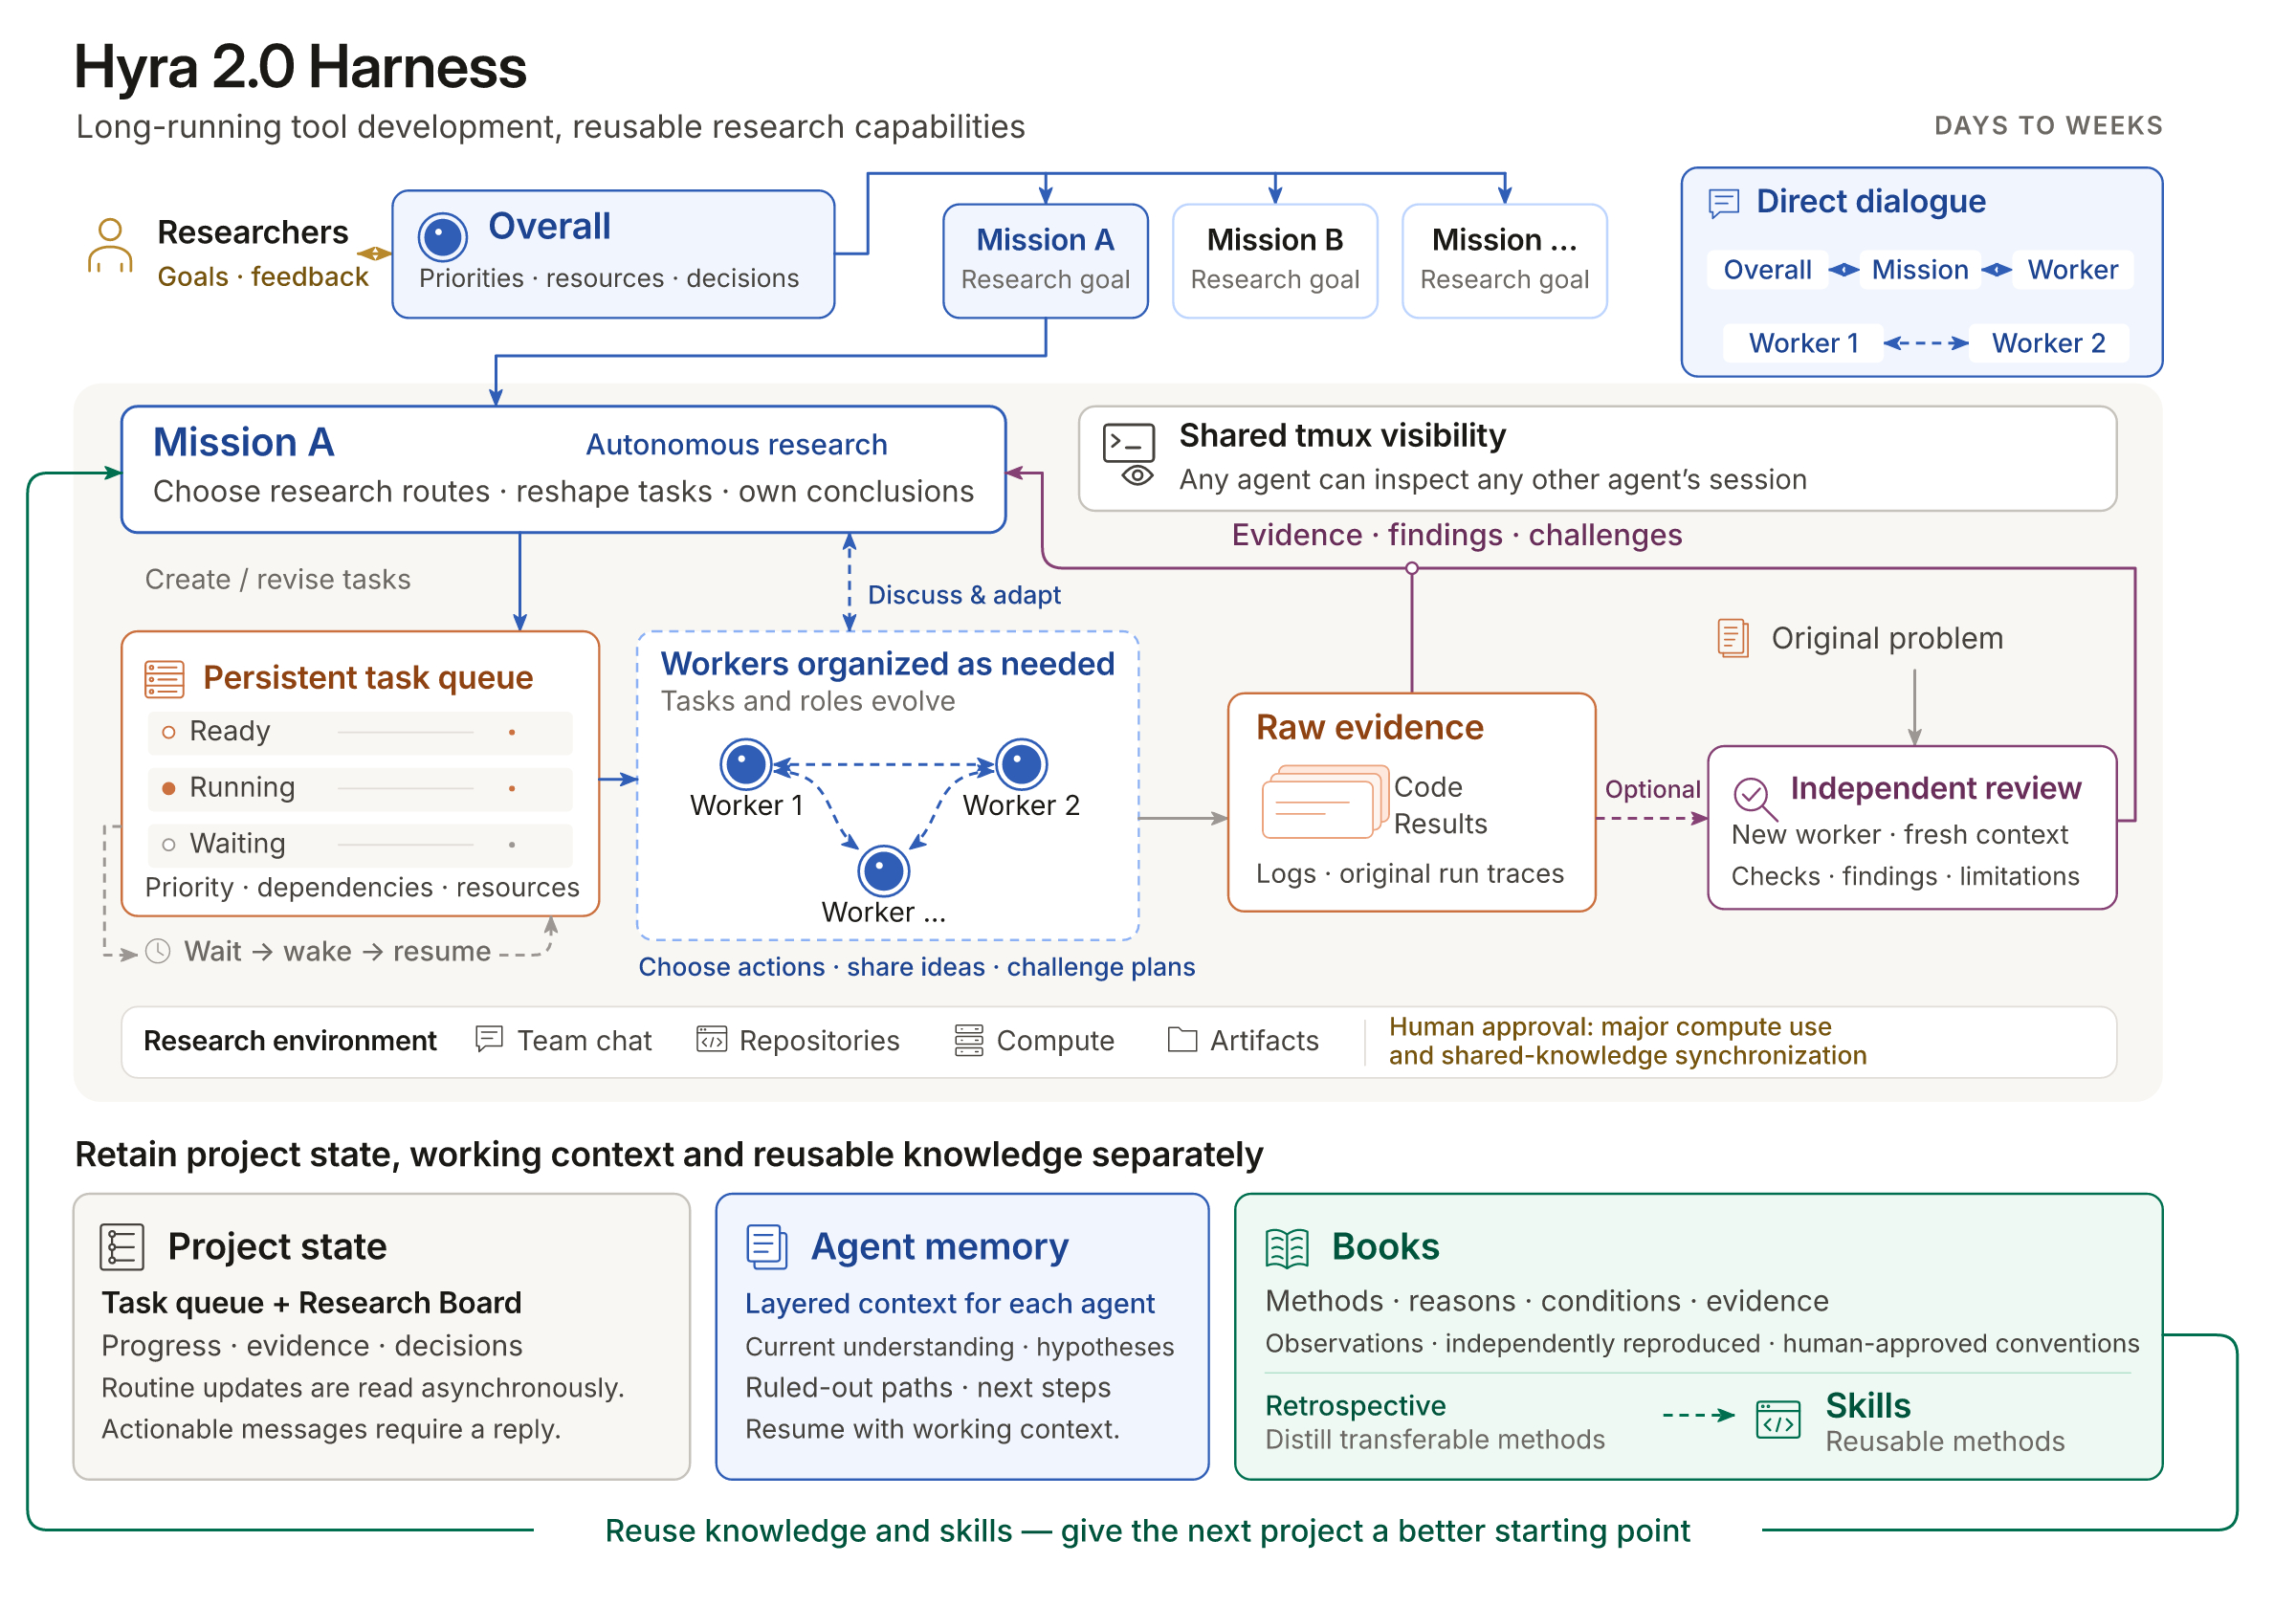
所以 2.0 拆成三层,Overall 对接人类研究者、管优先级和资源;Mission 长期盯一个研究问题,定路线、对结论负责;Worker 独立读代码、跑实验,甚至可以质疑 Mission,不同 Worker 还能用不同模型互核。
任务进持久化队列,等训练或审批时别的活照跑。
系统接进了真实研发环境:企业微信对需求,计算平台跑实验,代码仓库改代码,大算力开销和知识同步要人工审批,这不是无人值守的“全自动科学家”,是关键路口会停下来问人的系统。
Worker 交活必须附代码、结果和日志,存疑的另起 Review Worker 复核。
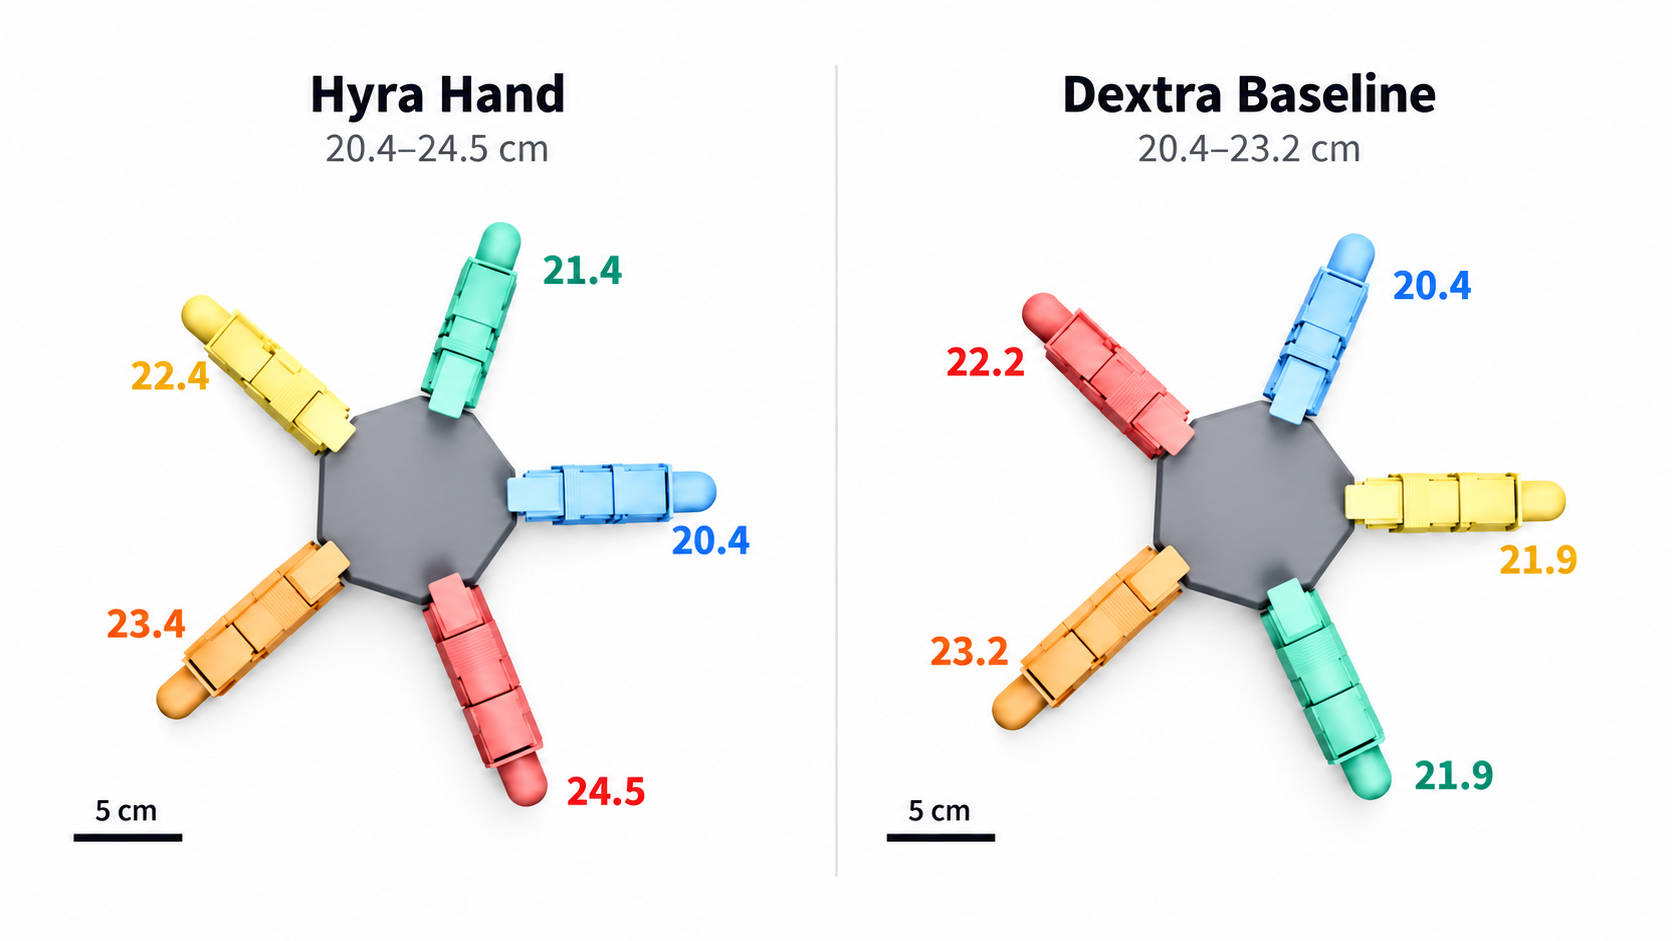
成果公开在 GitHub 的 hyra-results 仓库(是成果不是系统本身):196万参数的 HyInv 做蛋白质逆折叠,比常用的 ProteinMPNN 快57倍;HyPLM-Flash 用约 ESM-2 七成的训练量做到12个同类模型里推理最快;数学工作流 HyProver 与数学家核验了丘成桐圆周作用猜想的证明;量子码系统 HyQEC 把 qLDPC 榜首指标提升约48%。
最值得留意的是:Hyra 2.0 已经在参与下一代混元模型的预训练基建和后训练管线,当 AI 开始改良造 AI 的工具,这个循环通向哪,官方自己也没遮掩。