腾讯乐享的 AI 知识库做得真心不错。这两天上手体验了一下,感觉这个产品应该可以解决很多企业在使用 AI 时遇到的问题。
其实,叫它知识库,已经不够准确。
毕竟过去我们一提到知识库,想到的就是把一堆文件放进去,方便搜索和查阅。但现在企业级知识库一个很重要的作用,是为 Agent 提供企业的 Context。
所以,更准确地说,可以把企业知识库理解成 Agent 的 Context 中枢。这就是腾讯乐享正在做的事情。
可能很多人会和我一样,刚开始会觉得,现在 Codex、Claude Code、WorkBuddy 这样的 Agent 已经很强大了,直接通过 MCP、CLI 等方式就能够获取企业内部的 Context,为什么还需要独立的知识库层?
是这样,如果一家公司的知识来源比较单一,文档结构也很清晰,那确实没必要再单独建设一套企业知识库。
但只要公司规模稍微大一些,就会发现很多知识其实分散在不同的系统中。
有些来自企业微信、飞书这样的 IM 和办公平台,有些来自内部的研发管理系统,还有些来自 CRM、财务系统、OA 等等。
而且,在不同的系统里,同一件事可能还存在不同的版本。
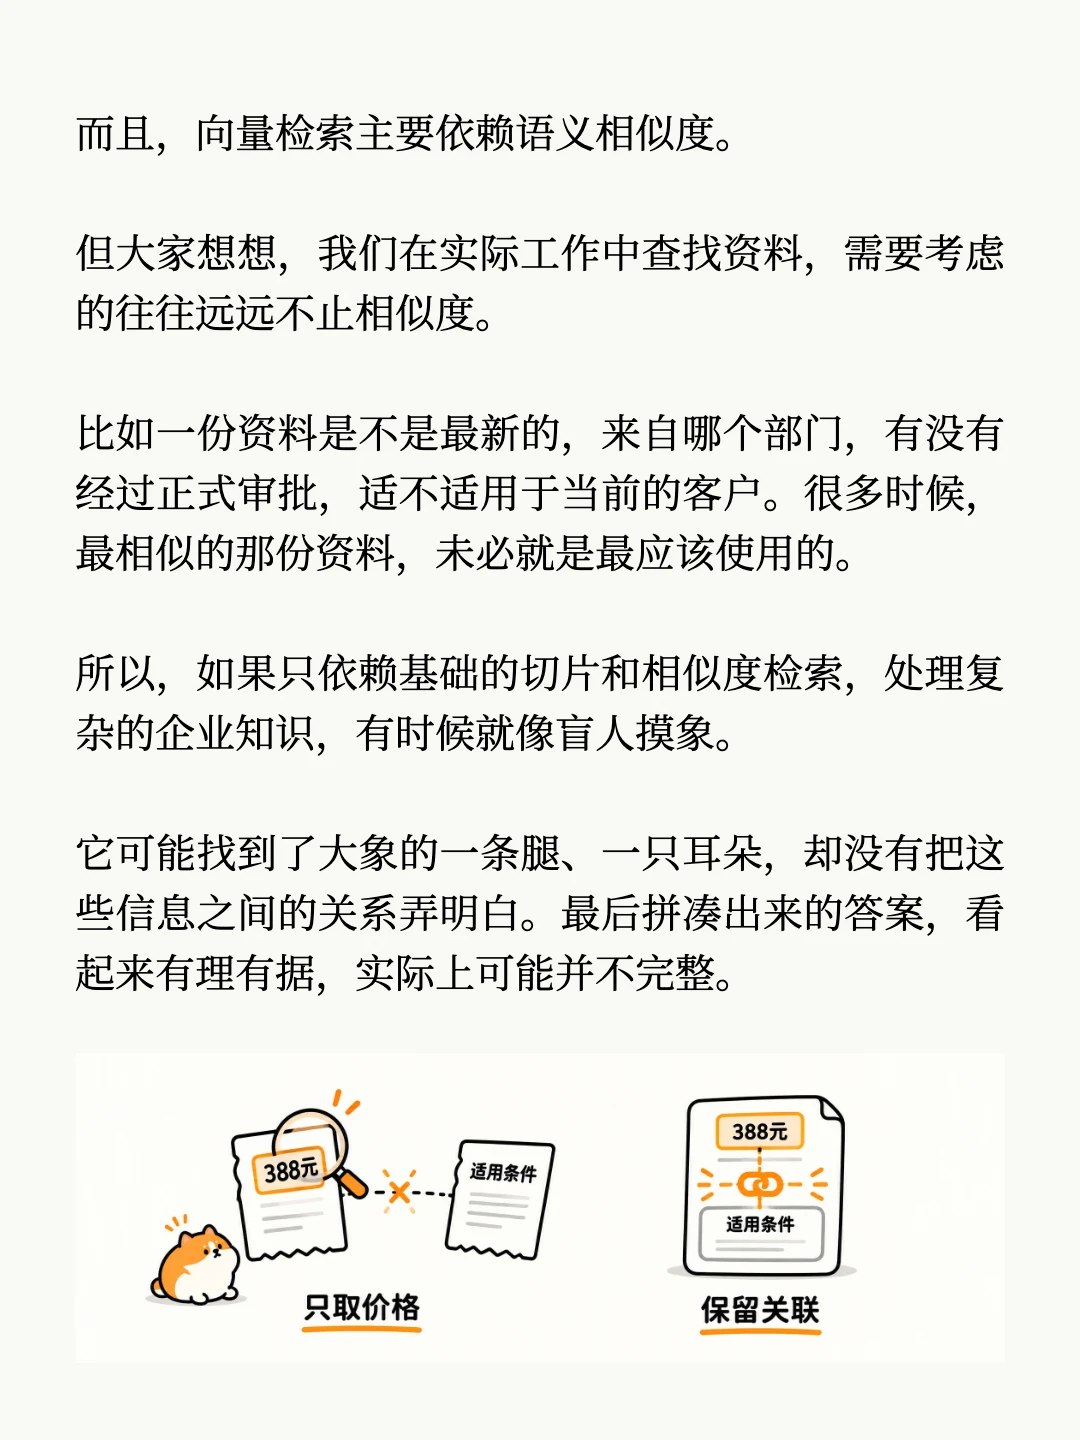
比如同样一款产品,针对不同的客户、地区和销售渠道,可能有不同的报价。一份文档里写着 388 元,另一份写着 488 元。
这俩价格可能都没错,但 AI 在给客户准备报价时,到底应该使用哪一个?
其实这就是企业知识库的价值。
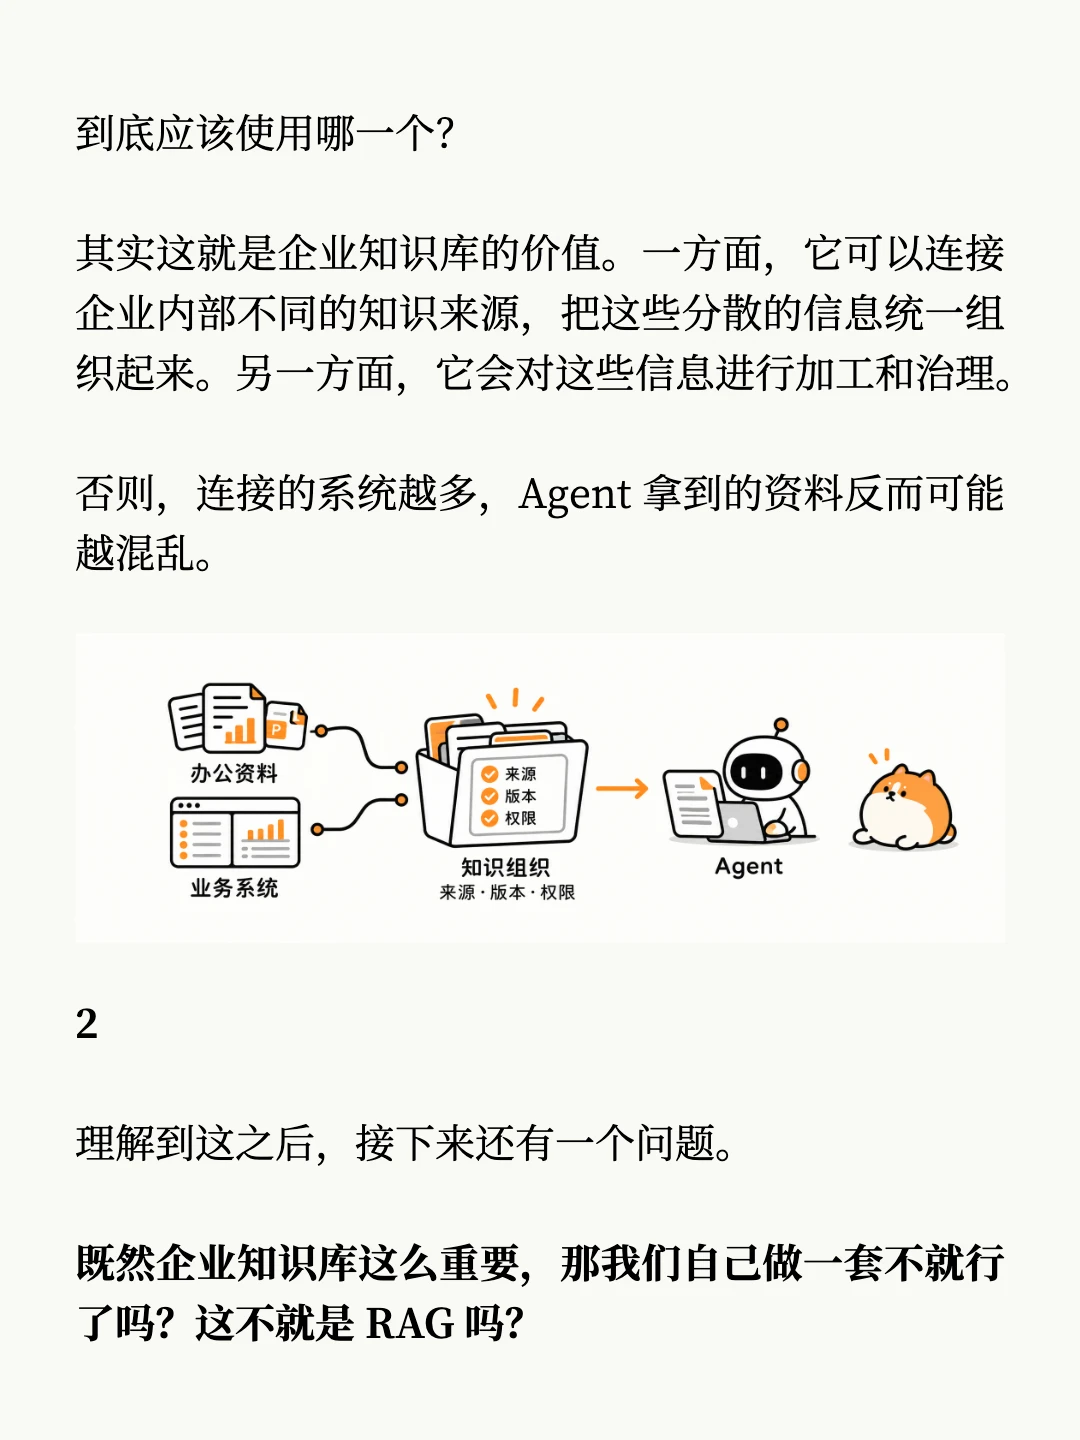
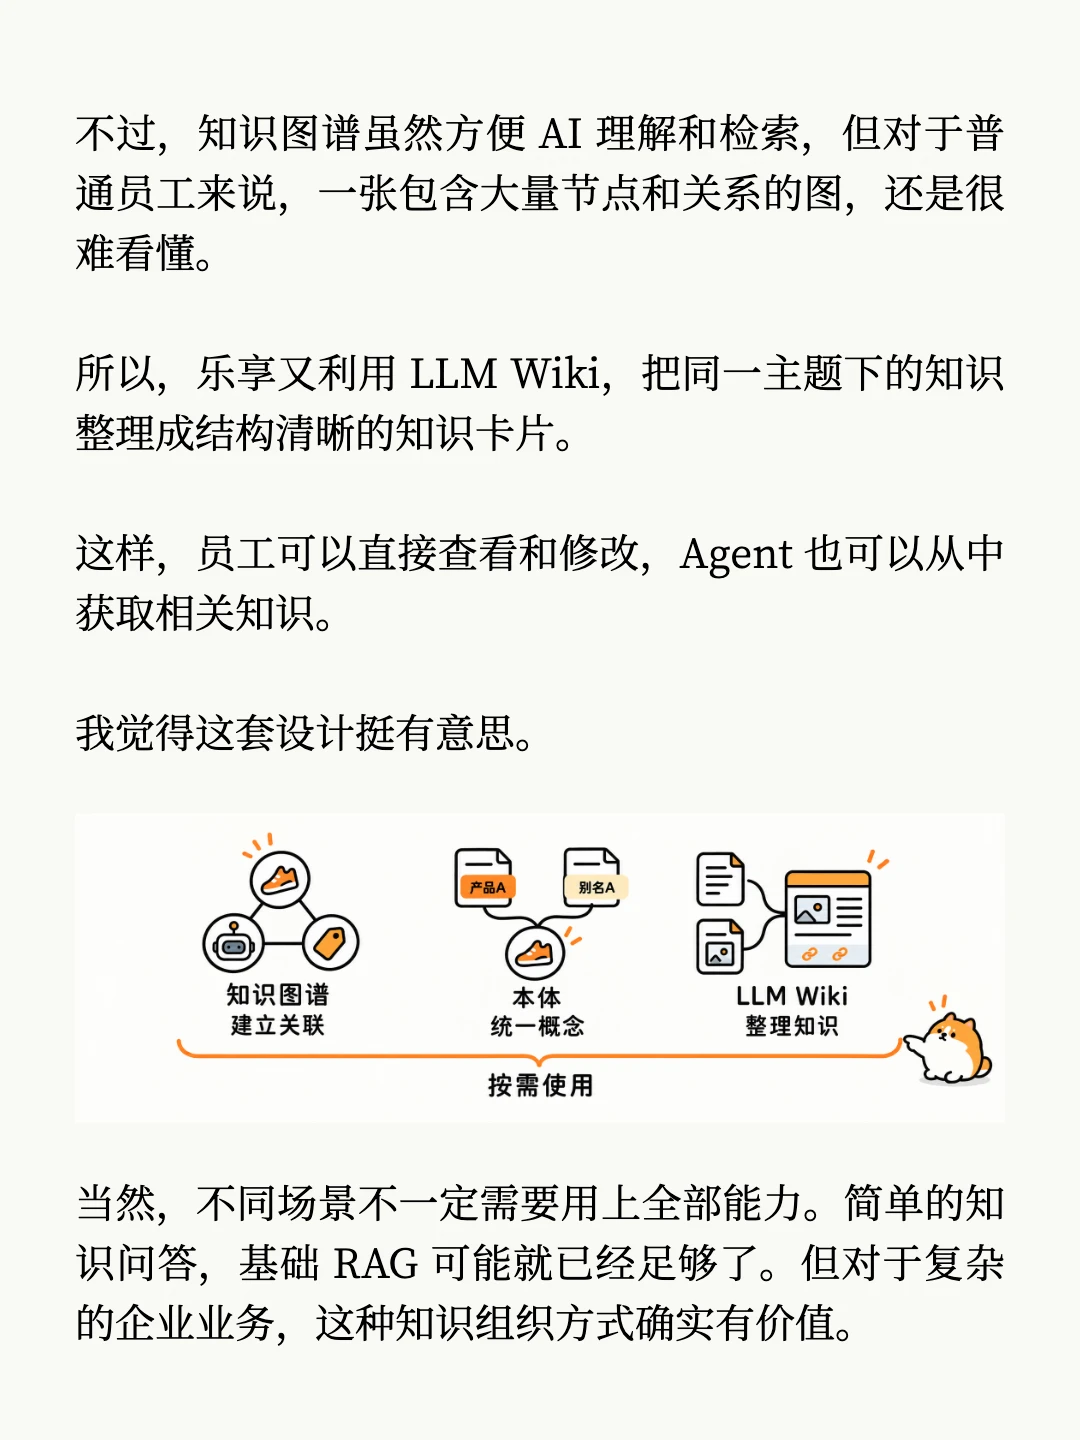
一方面,它可以连接企业内部不同的知识来源,把这些分散的信息统一组织起来。另一方面,它会对这些信息进行加工和治理。
否则,连接的系统越多,Agent 拿到的资料反而可能越混乱。
理解到这之后,接下来还有一个问题。
既然企业知识库这么重要,那我们自己做一套不就行了吗?这不就是 RAG 吗?
我之前其实也这么想过,而且自己还动手搭过类似的系统。
如果按照比较基础的 RAG 方案,我们通常会先把企业文档导入知识库,解析出其中的内容,再切成一个个片段,转换成向量,建立检索索引。
等 AI 需要查询某个问题时,再通过关键词或者向量检索,根据相似度找到最相关的几个片段,交给模型生成答案。
这个办法当然能够解决不少问题,但它有一个挺大的局限。
因为文档一旦被切成很多片段,就可能丢失原来的结构和上下文关系。