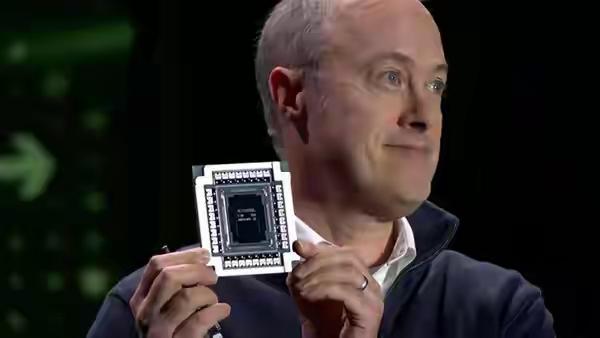
光要进芯片,贴着封装基板已经不够了。英伟达这次的做法是把光引擎直接放上承载 GPU 的硅中介层,中间那层有机基板被绕开。
现在量产的共封装光学,光引擎还在交换芯片旁边的有机基板上。电信号从芯片出来,得穿过中介层再穿过基板,才轮到电光转换。损耗从老方案的 22dB 压到 4dB,已经算不错。
再往下压,就得动位置。英伟达在 SEMICON West 上展示的这套叫 OOI,用短距离细间距布线把光学引擎搬到中介层上,电信号不用绕基板。配套的还有一个八波长方案,一根光纤里跑八路,单纤 256Gb/s。光纤数量加不上去的时候,只能靠波长复用抬容量。
我看这套东西的意义不在参数。它说明一件事,AI 芯片的瓶颈已经从算力挪到了数据怎么出去。算力堆得再多,出不去也是白搭。
我也不觉得它能很快落地。最大的拦路虎是热。光学元件对温度敏感,要和几百瓦的芯片封在同一层中介层上,热管理比现有方案难得多。良率和可维修性也是难题,英伟达自己说还在研究阶段,没有商业化时间表。
这类技术我一般看两件事。一是原型样品有没有做出来,这次有了。二是有没有人愿意为它改产线,这个还没有。
决定它什么时候来的,不是英伟达的 PPT,是台积电和封测厂愿不愿意开这条线。
你在意显卡的互连带宽吗,还是只看算力和显存?