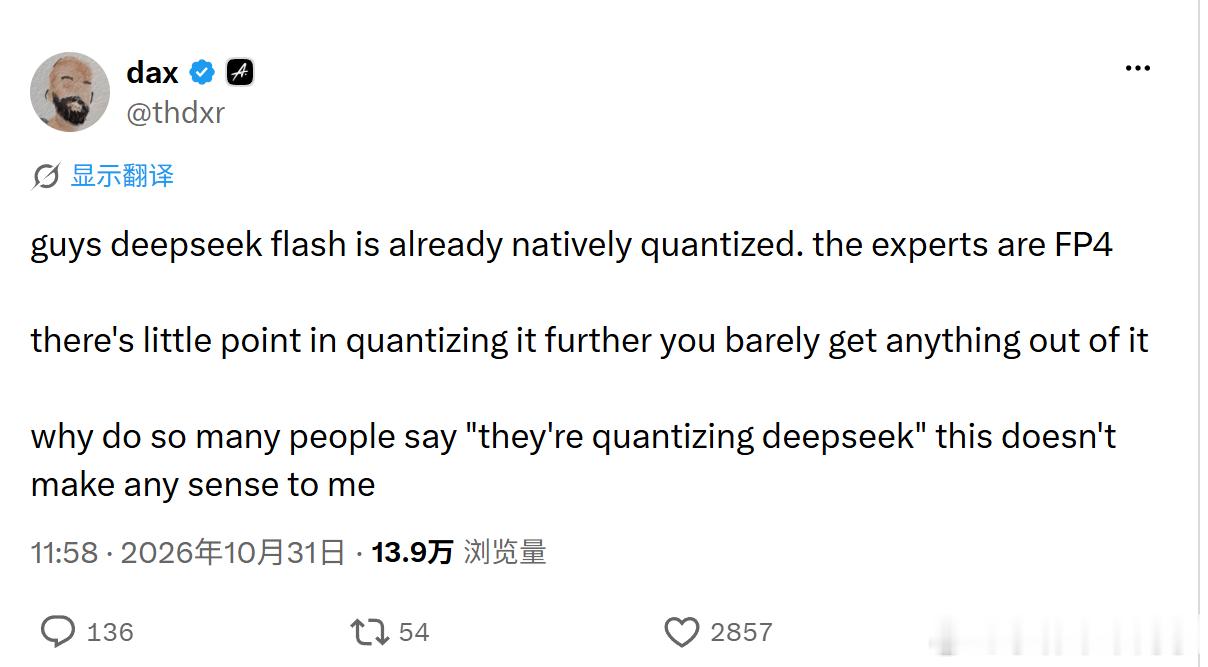
【「DeepSeek 被量化了」?Dax:它本来就是 FP4,再压也榨不出东西】
X 上 OpenCode 的 Dax(月 31 日发了条很短的帖子,把最近关于 DeepSeek 的猜测直接怼了回去:
「DeepSeek Flash 本来就是原生量化的,专家层已经是 FP4。再往下量化基本榨不出东西,收益极小。为什么这么多人都在说『他们在量化 DeepSeek』?我是真想不通。」
他凭什么说得这么笃定?因为 OpenCode 不是转发 API 的中间商——他们自己在 GPU 机架上跑 DeepSeek 推理。10 月 18 日他写过:新机架首次测试的 price/perf「比我们找到的所有供应商都好」,而且「还有优化空间」。
我的几点看法:
① 「被量化」这个猜测,方向就错了。FP4 是 DeepSeek 模型自带的精度形态,不是第三方为了省钱砍出来的。大家争「谁动了手脚」,可人家厨房本来就是冷链直达。
② 真正的问题不是精度,是服务商的方差。同一份权重,换一套推理栈、换一组采样参数,体感就能差一个档。用户骂的「变笨」,大概率出在部署侧,而不是量化本身。
再补一个反常识数据。Dax 10 月 27 日算过一笔账:OpenRouter 是最大的模型路由,它一天全部的 DeepSeek 流量,一台 GB300 机架就几乎吃得下,「哪怕真实需求是 10 倍,也就是不到 1 亿美元的算力」。这和「DeepSeek 需求爆炸」的叙事是反着的。
我的结论:开源模型的口碑,越来越取决于「谁来托管」,而不是「模型本身」。DeepSeek 把权重开放出去了,也把体验的方差一起开放出去了——这既是开源的好处,也是它最难解的那道题。
DeepSeekOpenCode大模型推理优化