临床试验早期70人数据训练出预测模型
ESMO 2026 上,美国精准肿瘤学公司 Genialis 用数据证明了一件事:临床试验早期那几十个病人的数据,也能训练出靠谱的疗效预测模型。
他们评估了三个小队列——黑色素瘤 41 人、胃癌 45 人、KRAS G12C 非小细胞肺癌 66 人。在留出集测试里,AI 模型在每个队列都赢了传统基因表达模型。最亮眼的是肺癌队列:预测 sotorasib 响应的 AUROC 到 0.8,对面最好的基因表达模型只有 0.6;预测会响应的病人中位治疗了 337 天,预测不响应的只有 178 天。
背后的思路叫「生物学优先」:模型先基于数十万个转录组样本,把每个肿瘤约 2 万个基因的表达压成几十个可解释的「biomodules」(致癌信号、免疫激活、DNA 损伤应答……),再用这些生物学特征去建模。小样本过拟合的问题被绕开了,预测结果还能讲清楚为什么。
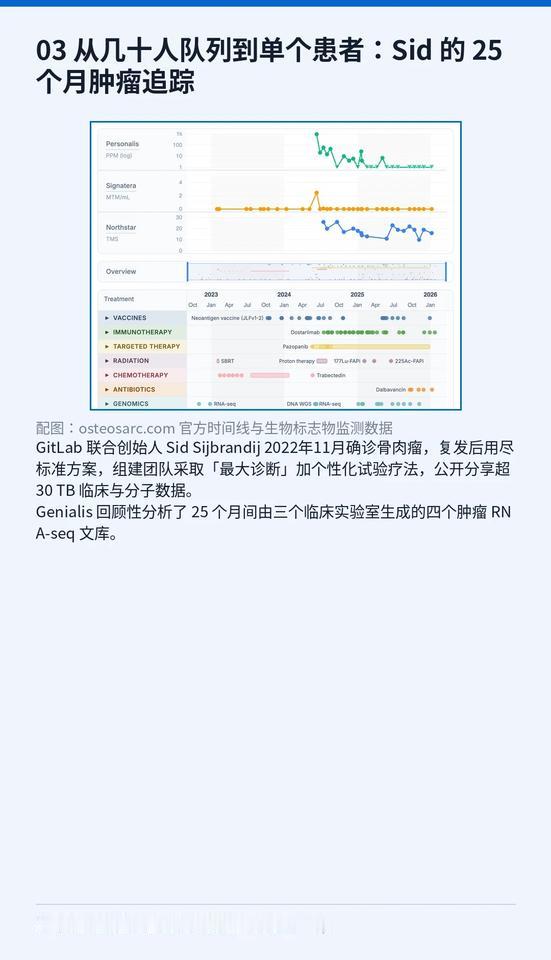
更打动人的是单患者案例:GitLab 联合创始人 Sid Sijbrandij 2022 年确诊骨肉瘤,公开分享了 30 TB 的临床和分子数据。Genialis 把他 25 个月、4 个 RNA-seq 文库(来自 3 家实验室)放进同一个生物学坐标系——两家实验室独立测序同一肿瘤时,原始基因表达相关性只有 0.65,但映射到 biomodule 空间后涨到 0.83,几乎追平同实验室重复测量的 0.82。
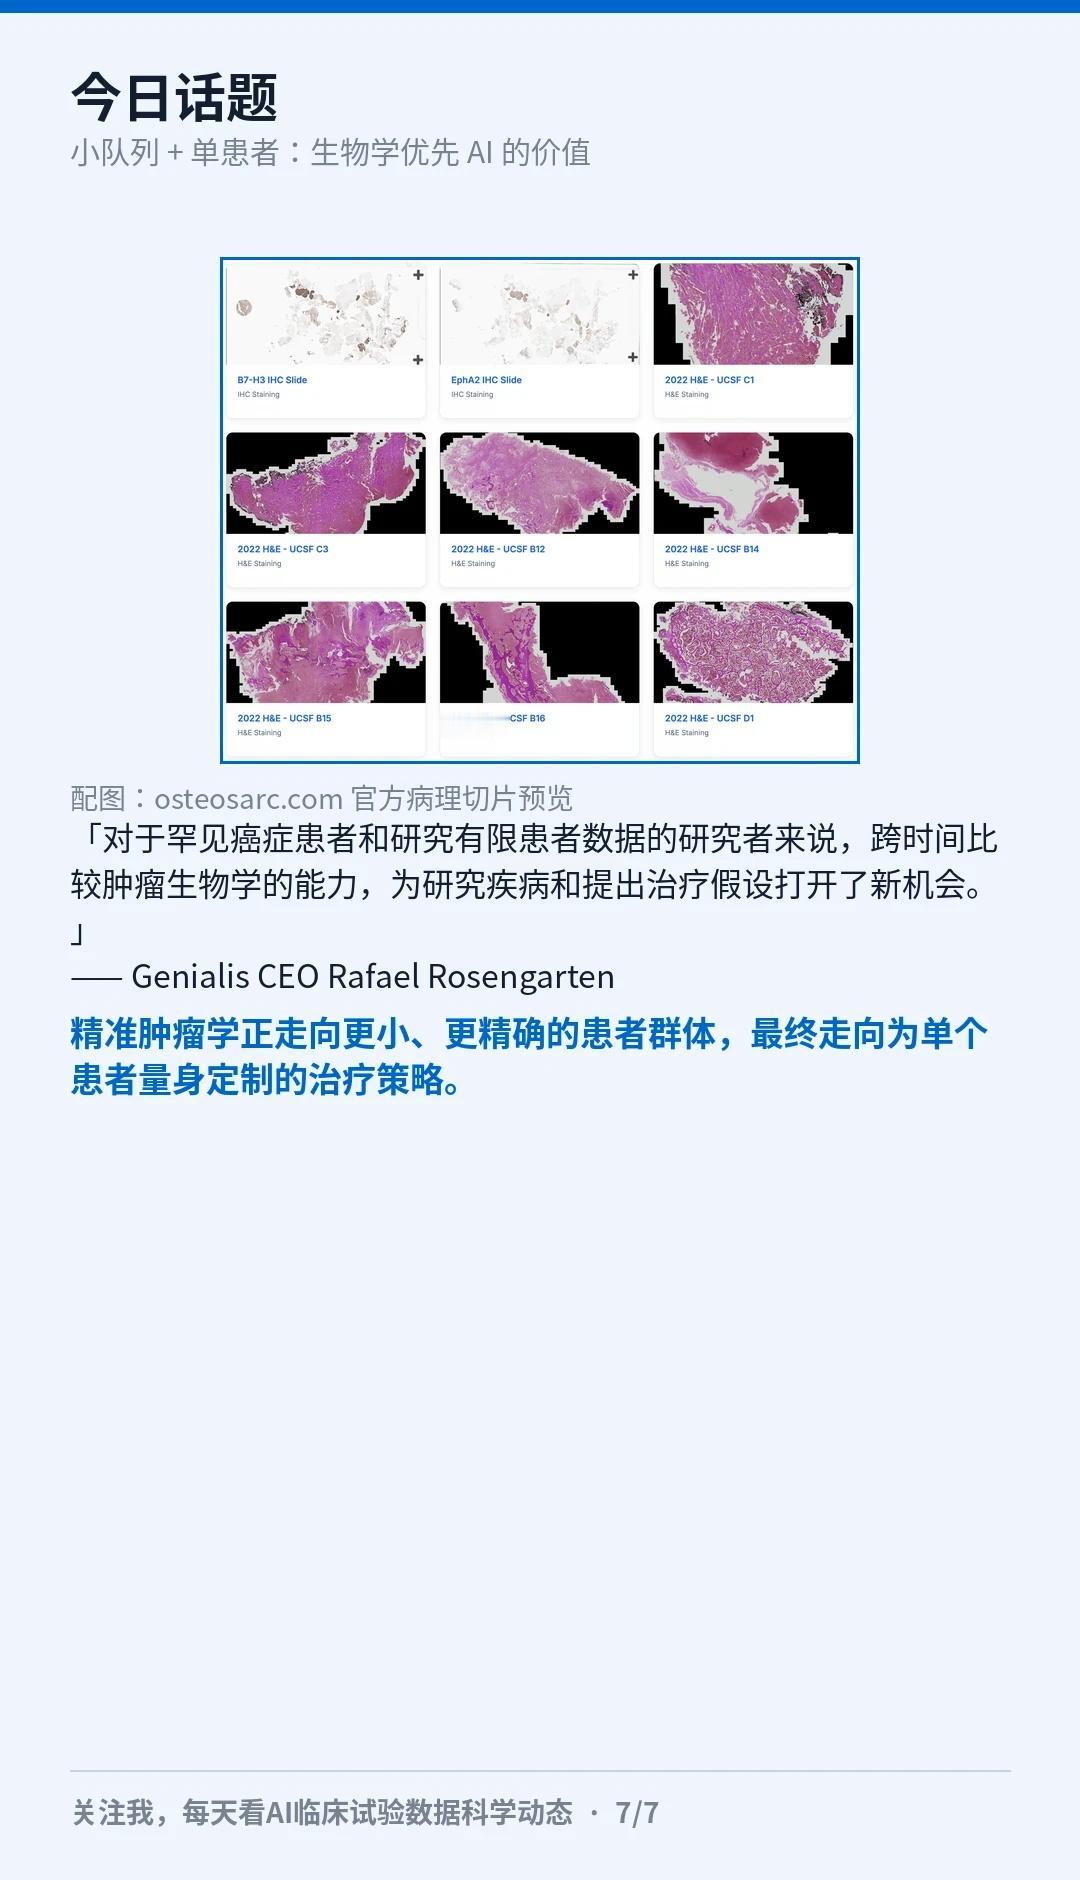
精准肿瘤学正在走向更小的队列,甚至单个患者。能从小数据里稳定提取洞见的 AI,会越来越值钱。
关注我,每天看AI临床试验数据科学动态
AI临床试验数据科学 AI制药 人工智能 数据科学 机器学习 精准医疗