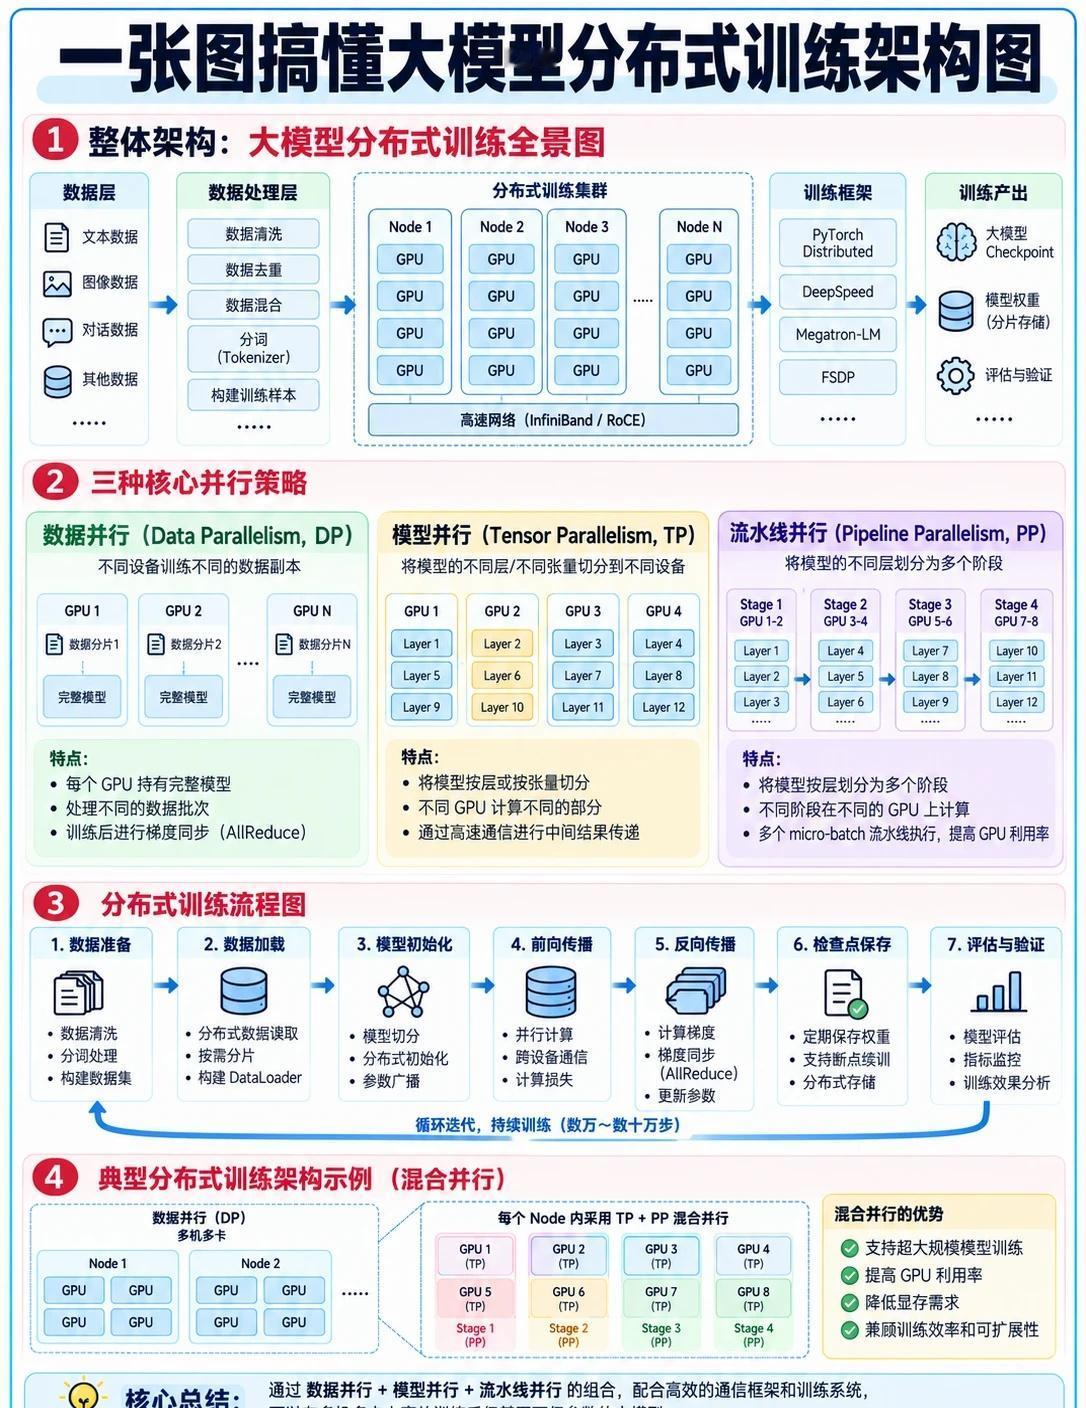
一张图搞懂大模型分布式训练架构
① 整体架构:从数据到模型
完整训练链路主要包括:
数据采集 → 数据清洗 → Tokenizer → 训练样本构建 → 分布式训练集群 → 模型保存 → 评估验证。
底层依靠 GPU 集群提供算力,通过高速网络实现跨节点通信。
常见训练框架包括 PyTorch Distributed、DeepSpeed、Megatron-LM、FSDP。
② 三种核心并行策略
📌 数据并行(DP)
每张 GPU 保存一份完整模型,但处理不同的数据批次。
各 GPU 独立计算梯度,再通过 AllReduce 等方式同步。
适合模型能够放进单卡显存的场景。
📌 模型并行(TP)
当模型太大,单张 GPU 放不下时,可以将模型中的张量计算拆分到不同 GPU。
多卡共同完成一层的计算,但需要频繁通信。
📌 流水线并行(PP)
把模型不同层划分为多个阶段,分别部署在不同 GPU 上。
通过 Micro-batch 流水线执行,提高设备利用率。
③ 分布式训练完整流程
数据准备 → 分布式加载 → 模型初始化 → 前向传播 → 反向传播 → 梯度同步 → Checkpoint 保存 → 评估验证。
整个过程会持续循环,直到模型达到训练目标。
④ 为什么大模型要混合并行?
实际训练中,往往不会只采用一种并行策略。
而是将 DP、TP、PP 组合使用:
DP 提升数据处理吞吐量;
TP 解决单层参数过大的问题;
PP 解决模型层数过多、单卡无法容纳的问题。
三者协同,才能更高效地训练超大规模模型。
⑤ 大模型开发必须理解什么?
不一定要亲自训练千亿参数模型,但至少要搞清楚:
为什么需要多卡训练?
DP、TP、PP 有什么区别?
梯度同步为什么会影响性能?
显存不足应该如何处理?
Checkpoint 为什么重要?
这些才是理解大模型训练工程的关键。
最后总结:
大模型分布式训练,本质上就是通过合理拆分数据、模型和计算任务,让多张 GPU 协同完成原本单卡无法承担的训练工作。
真正理解分布式训练,才能看懂大模型背后的工程架构。
大模型 大模型开发 大模型应用 多模态人工智能 AI人工智能 Agent开发 AI大模型开发 AI开发