为什么现在的Attention越来越爱output gate
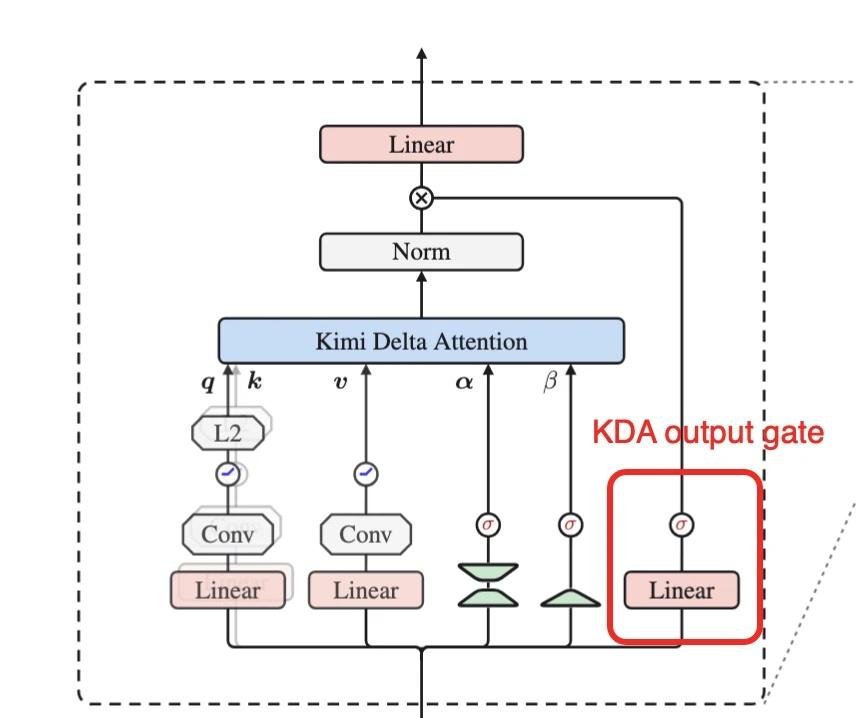
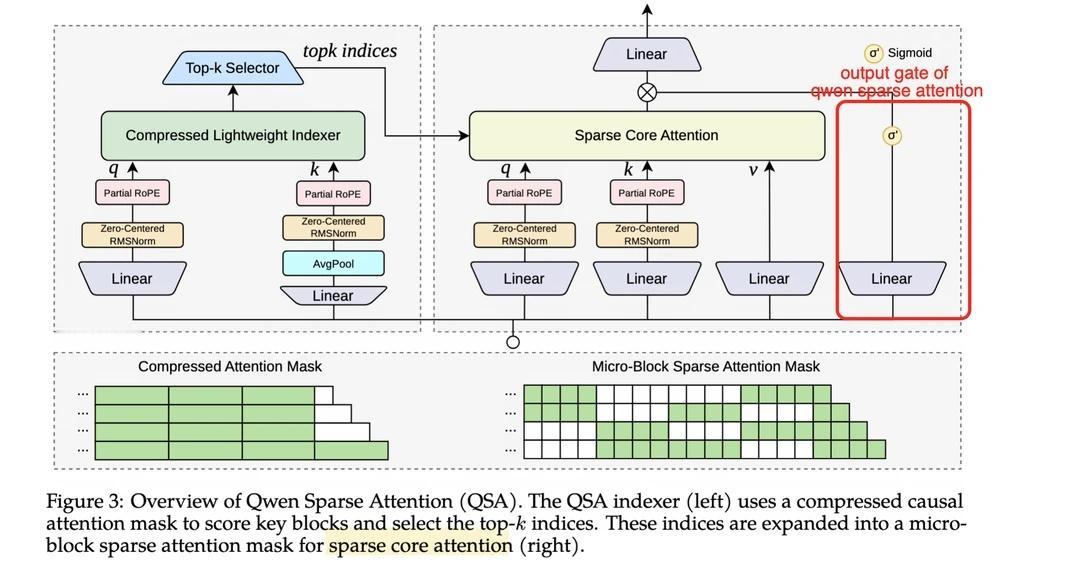
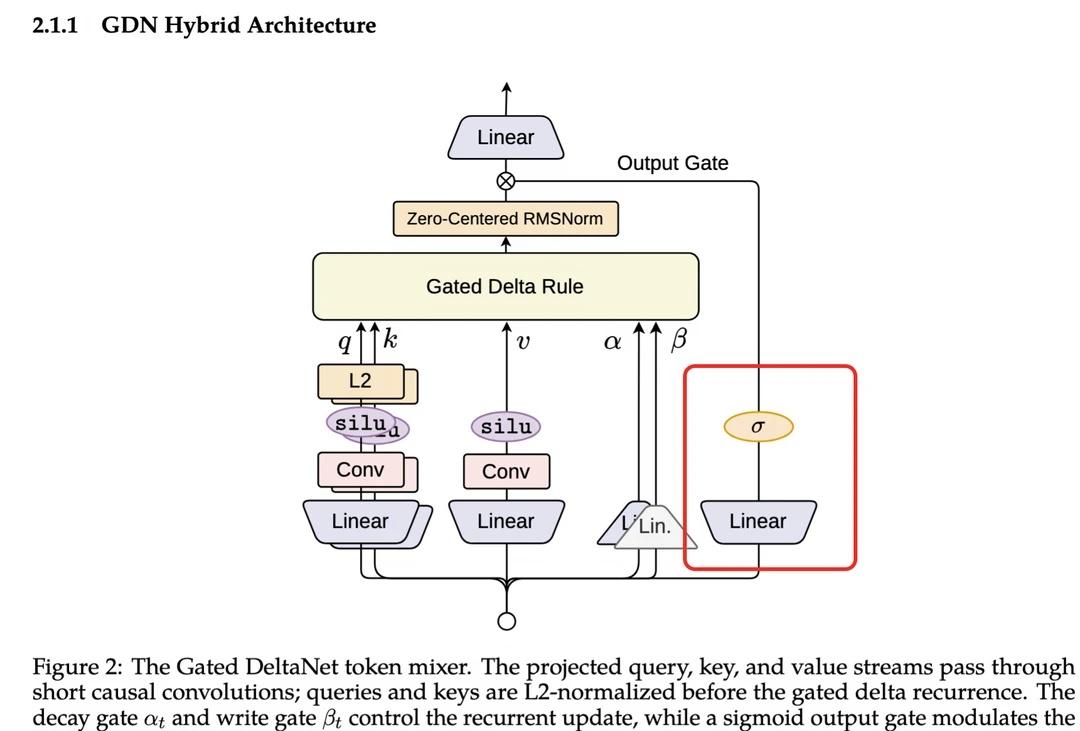
不知道大家有没有发现,现在主流呀的LLM attention都会加一个input-dependent output gate,比如KDA、GDN、QSA等
Attention都已经算出结果了,为什么后面还要再乘一个gate?🤔
其实关键在这句话👇
“读到了什么”和“这些信息要输出多少”,是两个不同的问题。
Attention做的是第一件事: 通过softmax分配权重,对历史信息加权求和📖
Output gate做的是第二件事: 在读取之后,根据当前输入,进一步调节各个通道的输出🎛️
公式很简单:
输出 = Attention结果 × sigmoid gate
它像一个可以连续调节的阀门🚰,让模型有能力压低当前不需要的信息。
Qwen团队的Gated Attention论文系统研究了这个设计:在SDPA输出后、输出投影之前加入gate,观察到了模型效果与训练稳定性的改善✨,同时显著缓解attention sink。
那为什么可能缓解sink?🤔
Softmax的权重总和必须为1,即使没有特别值得读取的信息,也需要分配权重。一种解释是,模型会把多余的注意力放到某些token上,形成attention sink🕳️
Output gate提供了额外的调节空间:即使完成了信息读取,也可以把输出压低⬇️
这里有个细节很重要⚠️: gate没有直接修改这一次计算中的attention权重;sink的缓解,是模型带着门控训练后观察到的变化。
另外,收益也不只是减少sink。论文还强调了输出门控引入的非线性,以及依赖当前输入的稀疏性📉
所以output gate值得关注的地方是:
让模型在学会“读取信息”之后,再学会“控制信息的输出”💡
大模型算法 attentⅰon 深度学习