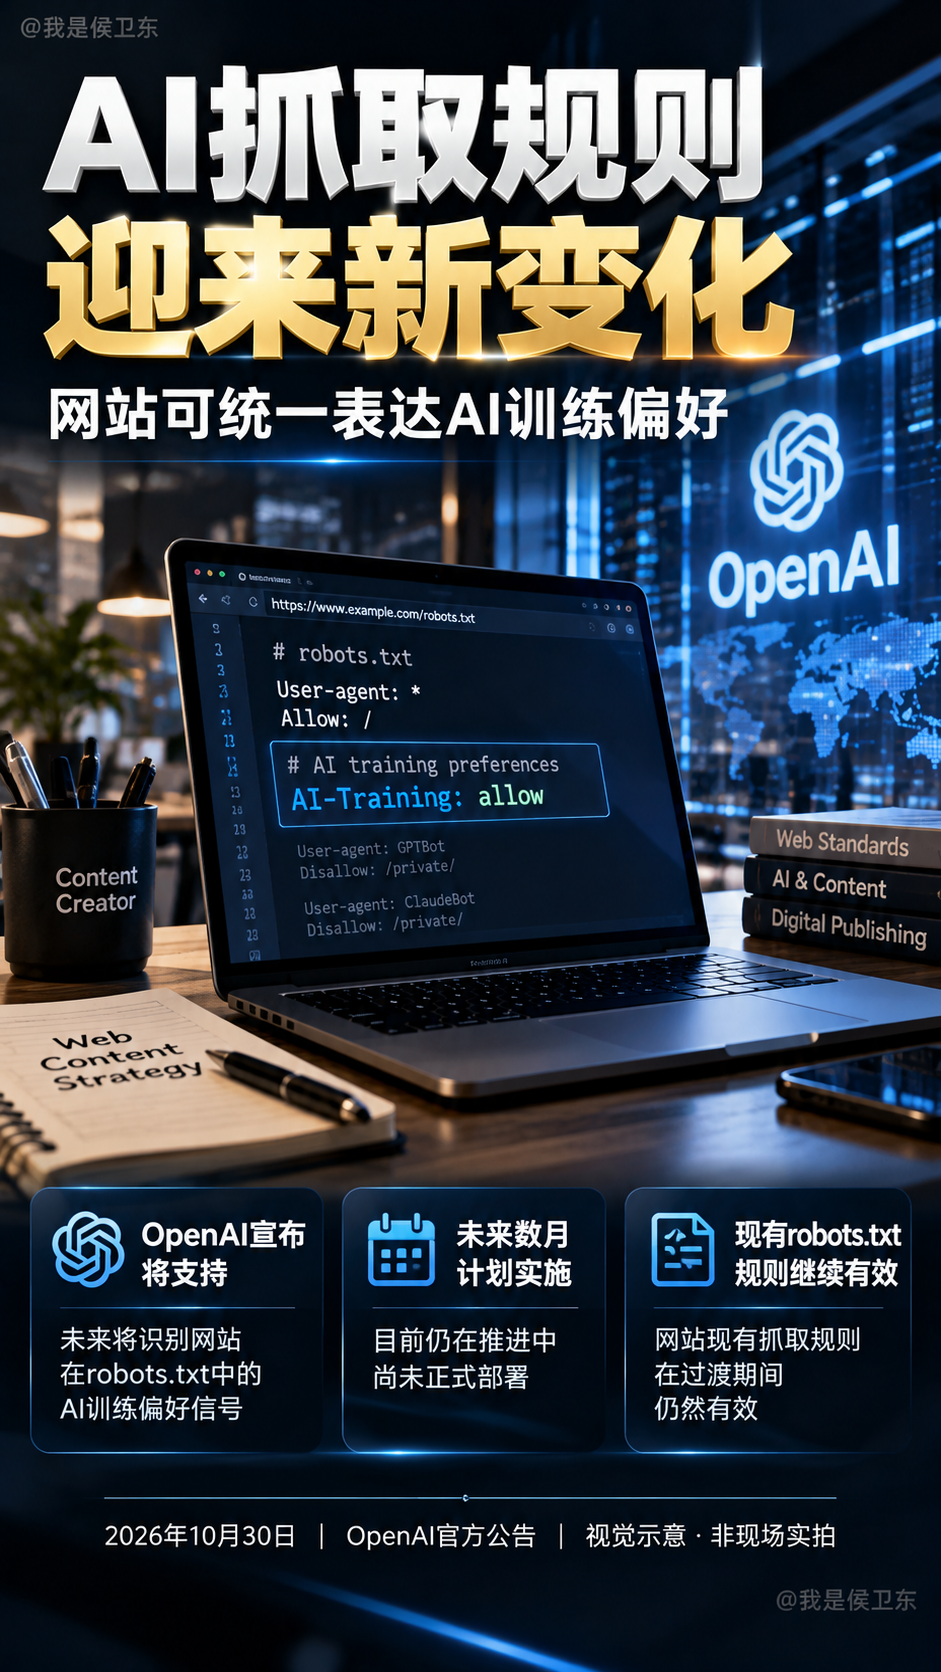
OpenAI宣布支持AI训练统一声明:以后网站拒绝被拿去训练AI,可能不用一家家设置了
10月30日,OpenAI发布了一项与网站运营者、内容创作者密切相关的新公告:公司计划支持一种通用的AI训练偏好信号,让网站能够通过robots.txt文件,向多个AI服务提供商表达内容使用意愿。
以前,网站如果不希望自己的内容被某些AI公司用于模型训练,往往需要分别识别不同公司的爬虫,再针对不同爬虫配置规则。
现在,行业正在尝试把这件事简化。
按照OpenAI的公告,新机制允许网站通过统一信号表达对生成式AI模型训练的偏好。参与支持该机制的服务商,可以按照同一套规则理解网站的选择。
但有一个时间节点必须注意。
OpenAI明确表示,计划在未来几个月实施这项机制,并将在后续公布具体实现细节。
也就是说,10月30日宣布支持,不等于当天已经全面部署完成。
此次方案与互联网工程任务组IETF正在推进的AI Preferences工作有关。
10月30日公布的技术草案提出,可以利用robots.txt现有语法,通过专门的策略标识表达训练偏好,不需要重新发明一套文件格式。
对于网站运营者来说,这确实是个值得关注的变化。
假设你经营一个原创内容网站,里面有大量自己撰写的文章、图片说明和行业研究。
过去,你可能需要分别处理不同AI公司的抓取规则。
如果未来更多企业采用统一机制,网站维护这些规则的工作量就有机会下降。
不过,这里还存在两个重要限制。
第一,这是一项自愿参与的机制,并不代表全球所有AI公司都会自动遵守。
第二,表达不希望内容用于模型训练,与禁止爬虫访问网站,并不是完全相同的事情。
技术草案明确区分了内容使用偏好和爬虫访问控制。网站想限制抓取行为,仍然需要关注对应的爬虫规则。
另外,robots.txt本质上是一种声明机制,不是能够阻止所有程序访问内容的技术防火墙,也不能单独解决版权归属和授权费用问题。
我认为,这次变化最值得关注的,不是多了一项网站配置功能,而是AI企业开始尝试建立跨公司的内容使用规则。
过去AI行业讨论最多的是模型能力和算力投入。
现在,训练数据从哪里来、内容创作者能否表达拒绝、网站如何管理自己的数据资产,也逐渐成为产业发展必须面对的问题。
对于原创内容创作者来说,这至少意味着多了一种表达内容使用意愿的途径。
但真正能否保护创作者权益,还要看未来有多少AI企业实际采用,以及这些企业如何执行相关规则。
资料来源:OpenAI于2026年10月30日发布的官方公告《Making it easier for websites to express AI training preferences》;IETF同日更新的技术草案。
OpenAI 人工智能 AI版权 内容创作 互联网技术
原创声明:本文依据官方公告和公开技术文档独立整理、分析与创作。