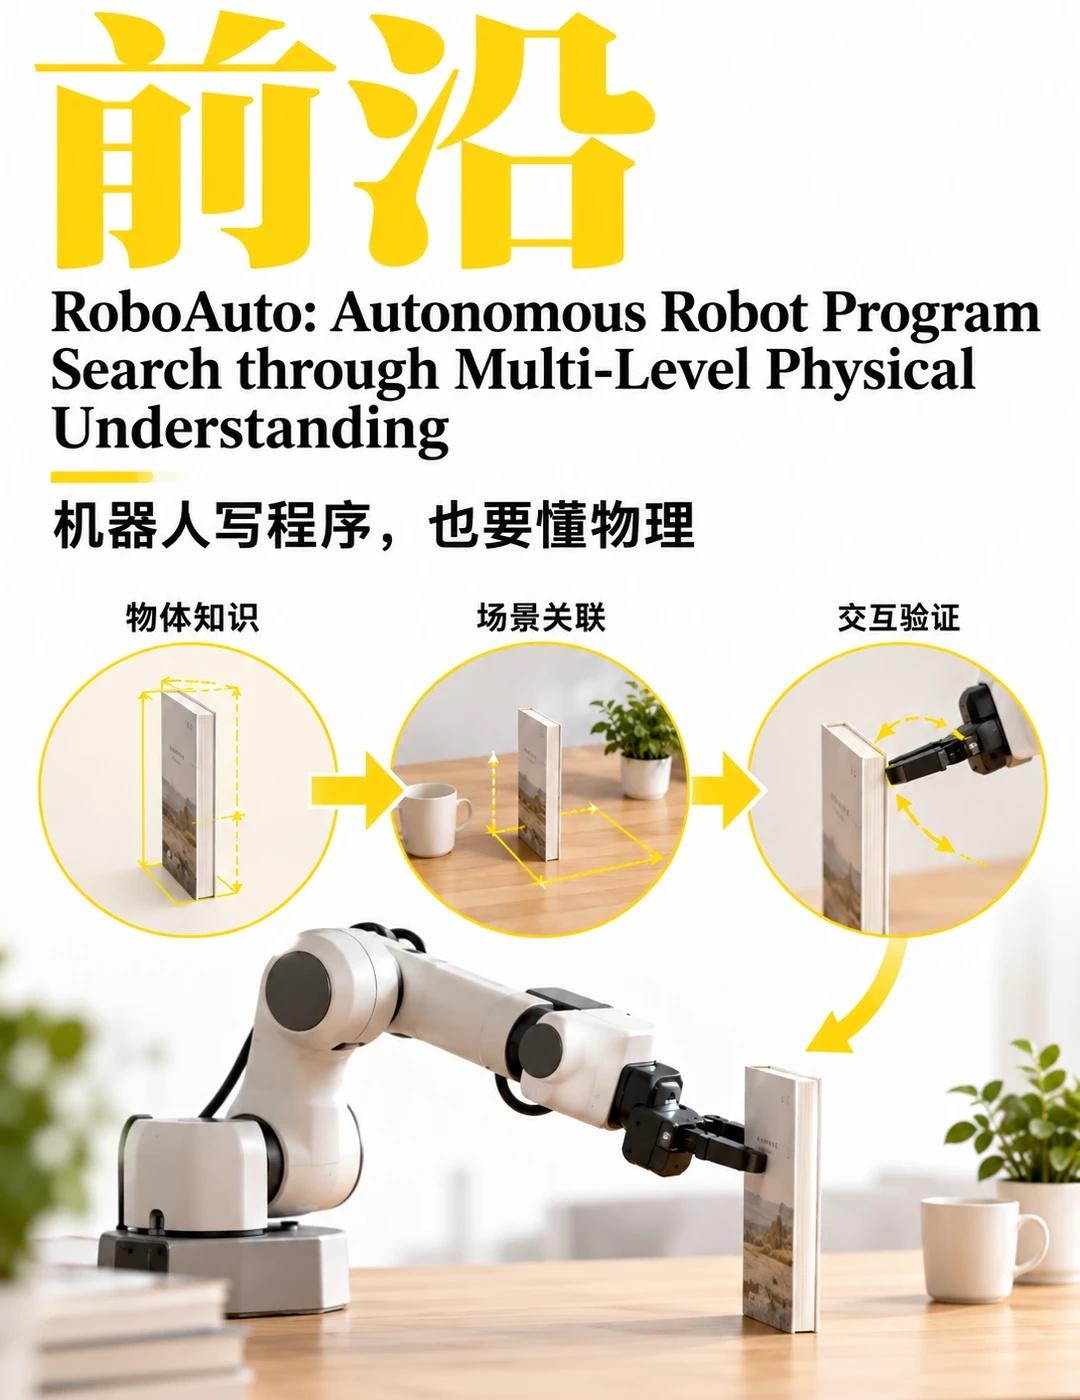
RoboAuto:机器人写程序,也要懂物理
让大模型给机器人写一段“拿起书本”的程序,代码能运行,并不代表动作一定可行。如果书本很薄、竖在桌边,从上方抓取可能一次次把它推倒。只根据“失败了”修改代码,机器人仍可能不知道真正的物理原因。论文 RoboAuto 关注的正是:机器人如何在搜索程序时理解物体、场景和交互。
这类方法常被称为 Code-as-Policy:用可执行程序组合感知、抓取和移动等技能,再根据执行反馈迭代修改。它的好处是程序可编辑、可检查;难点是程序必须落在当前物理世界里。某个抓取高度在上一张桌子上有效,换了物体尺寸可能就会让夹爪在空中闭合。一个长任务的前一步若没达到预期,后面的代码即使正确也无法补救。
RoboAuto 把物理理解拆成三个层次。第一层是知识库,保存可复用的技能,以及物体的可操作方式、空间关系和动作可能产生的效果。知识条目记录“什么条件下适用、哪些量需要现场测量”,而不是把某次成功的坐标原样照搬。
第二层是场景接地:识别当前环境中真正相关的物体,并把知识中的开放量落实到眼前场景。例如先确认书本边缘、夹爪方向与目标位置,再决定程序参数。第三层是分阶段规划与验证:每完成一段动作,检查物理效果是否真的出现。如果失败原因不明,系统还会设计小实验,区分不同解释,而不是只盲目重试同一段代码。
论文报告,RoboAuto 在五组基准任务中优于所比较的方法;在短程 LIBERO-PRO 任务上达到 89.1% 的成功率,在两组更长、更复杂的任务上,平均成功率超过 ASPIRE 的两倍。作者也在三项真实机器人长程任务中作了对比,并展示知识库可跨模拟环境和机器人形态迁移。这里的数字对应论文的特定任务设置,不能直接理解成任意家庭场景都能达到相同水平。
这项工作的启发是,机器人程序搜索不只是“代码生成—运行—报错—再改”。把物体知识、现场测量和中间效果验证接成闭环,才更有希望知道一个动作为什么成功或失败。面对新物体、新环境与长时间部署时,这套知识如何持续维护,还值得继续研究。
论文:RoboAuto: Autonomous Robot Program Search through Multi-Level Physical Understanding
arXiv: 2610.36533
具身智能 机器人马拉松 智能体