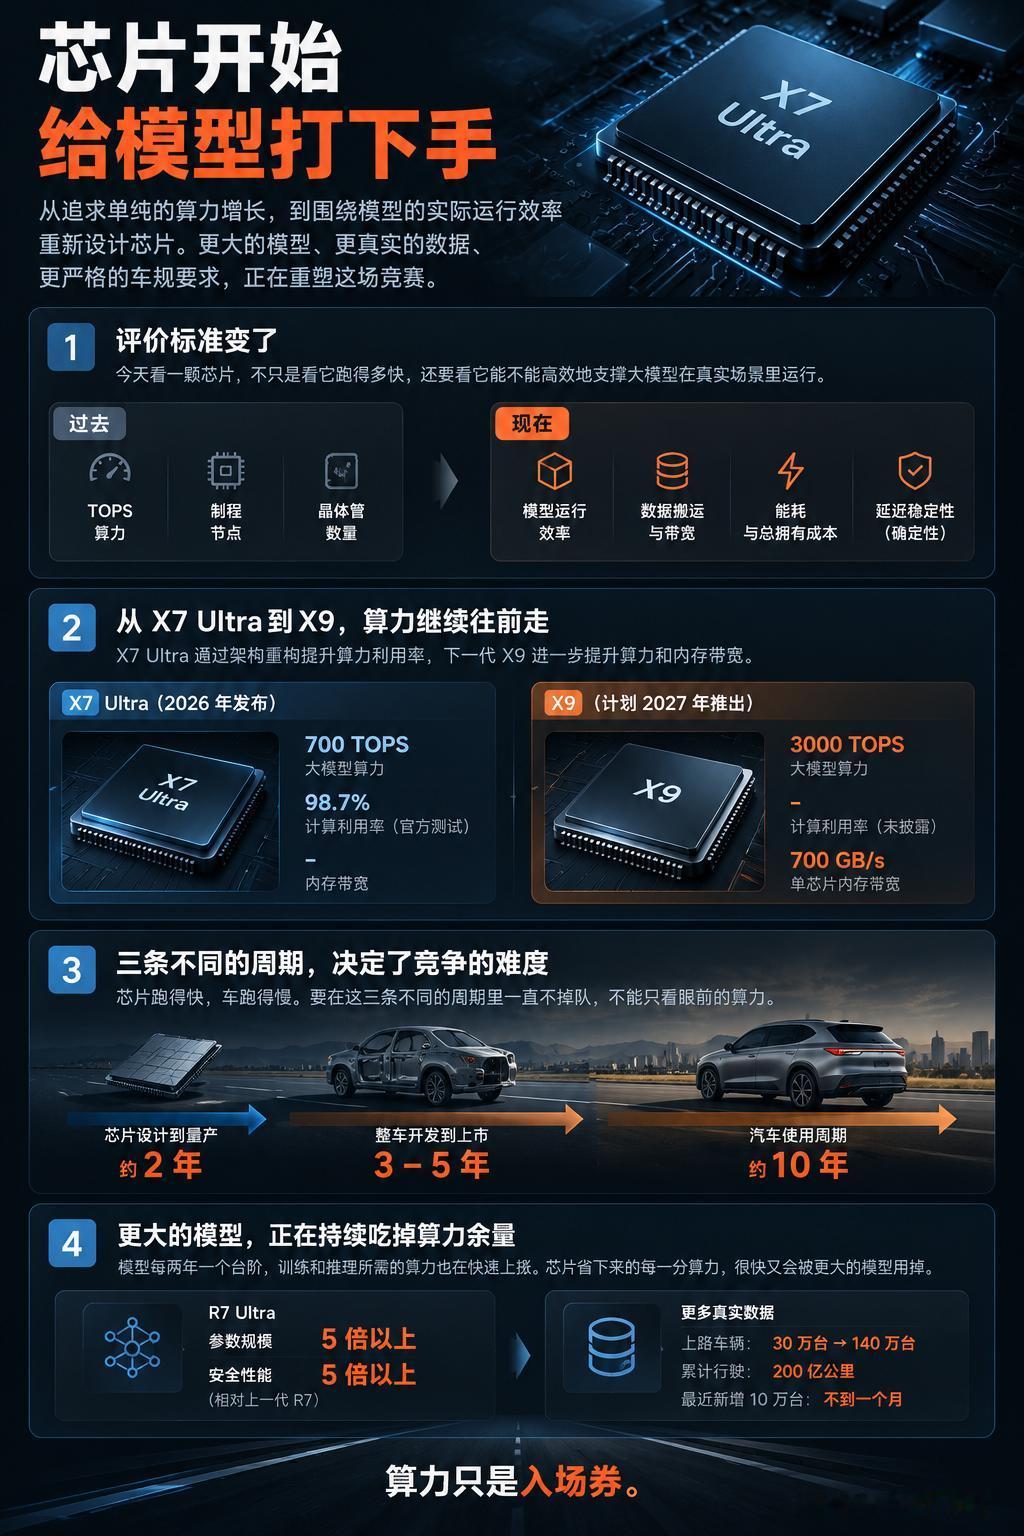
700TOPS。今天下午在苏州,台上报的就是这个数;我今年听过太多遍了,一场发布会比一场大。
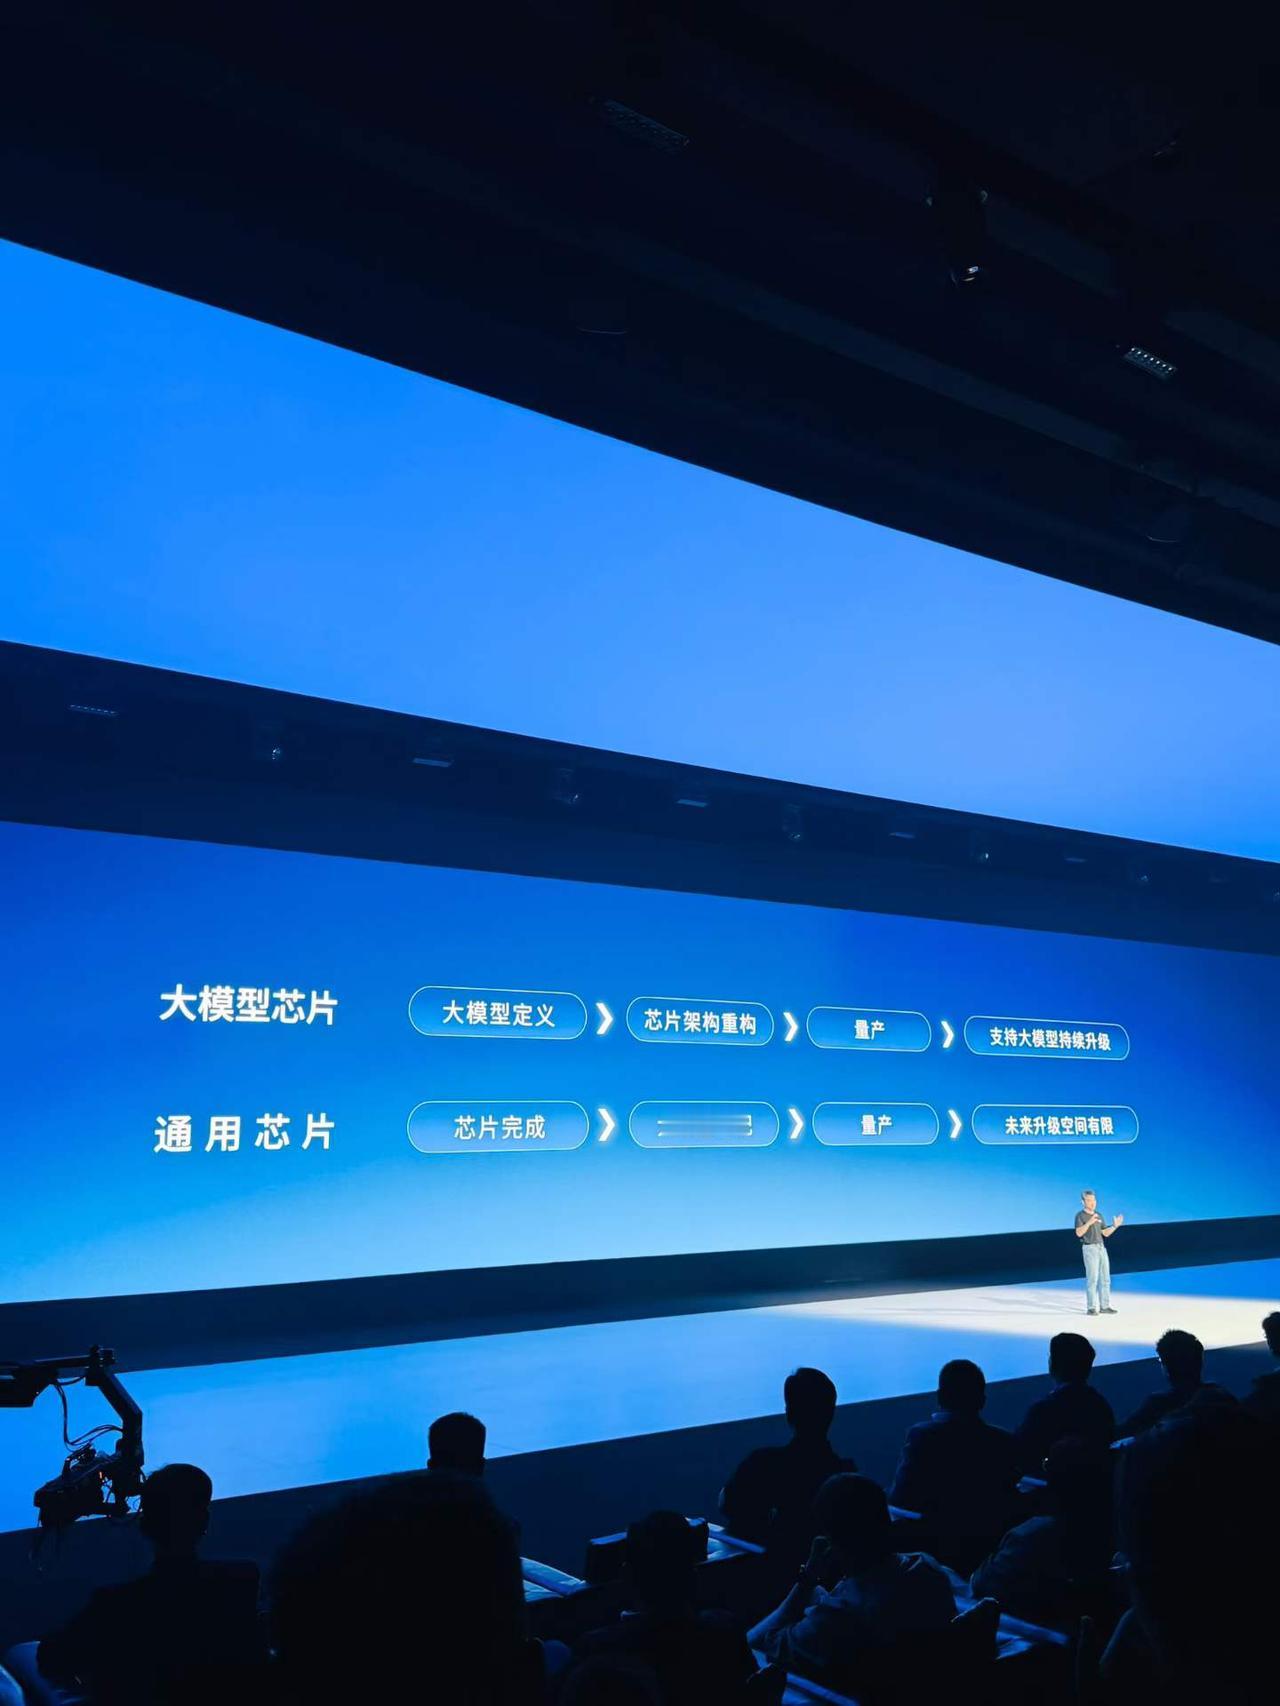
一颗通用芯片要同时伺候图像识别、语音、控制、大模型,什么都能干,什么也都得留余量。今天的智驾模型只走一条路,Transformer,大部分算力反复花在同样的几步计算上。
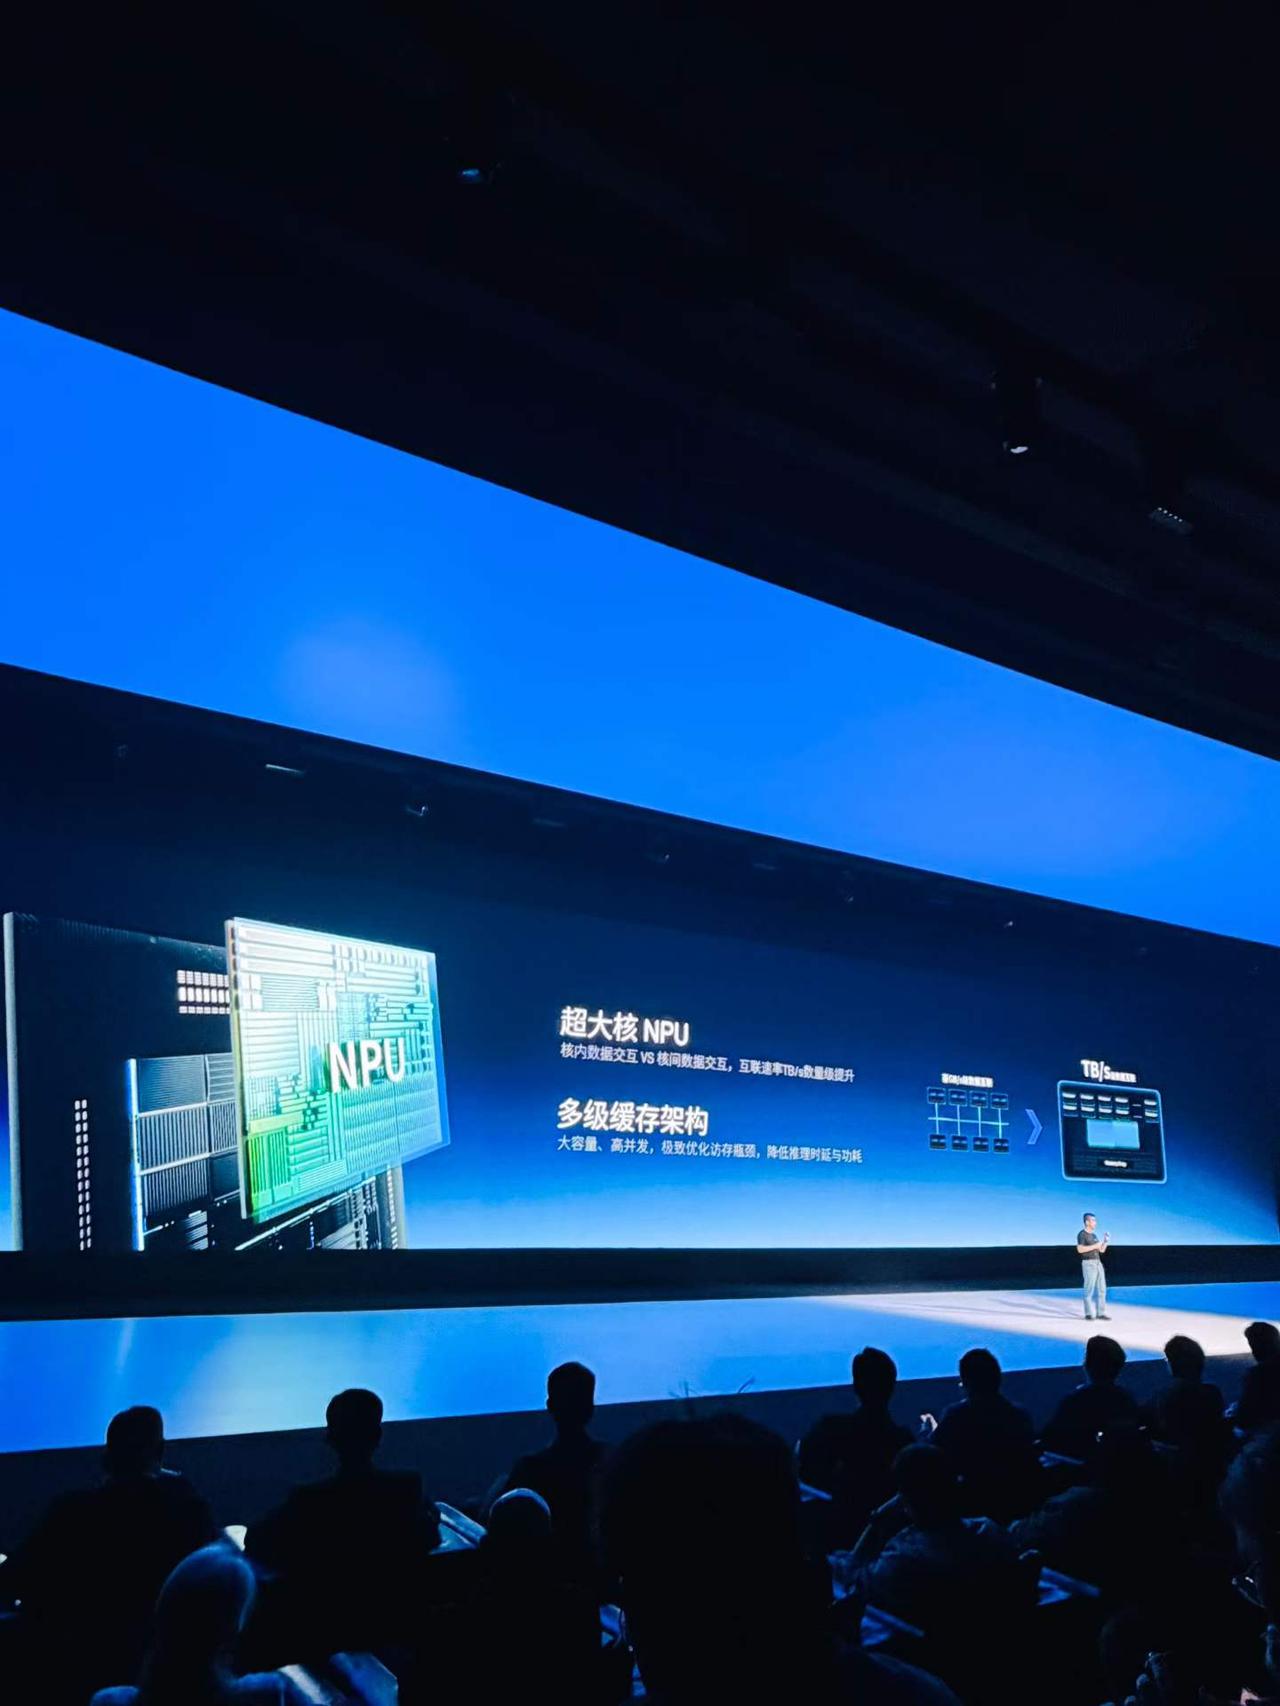
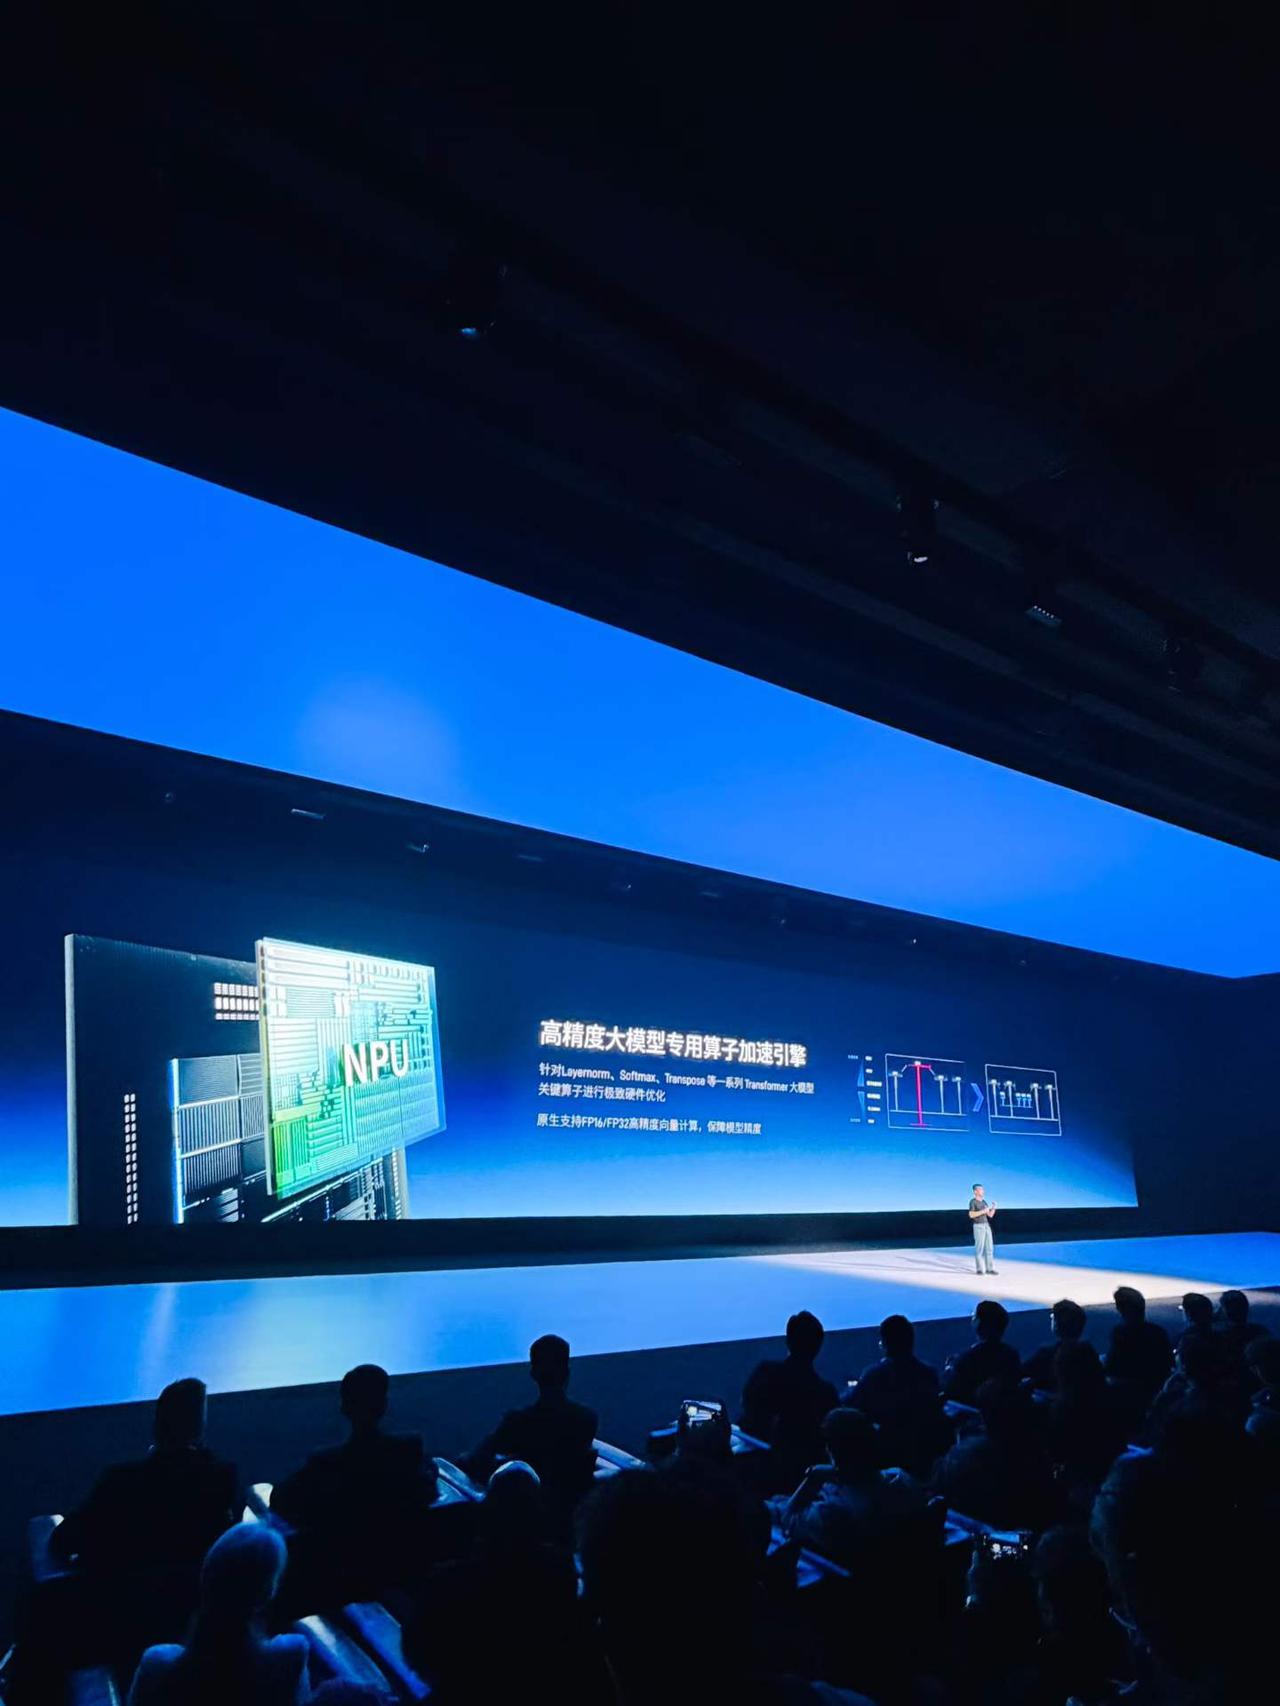
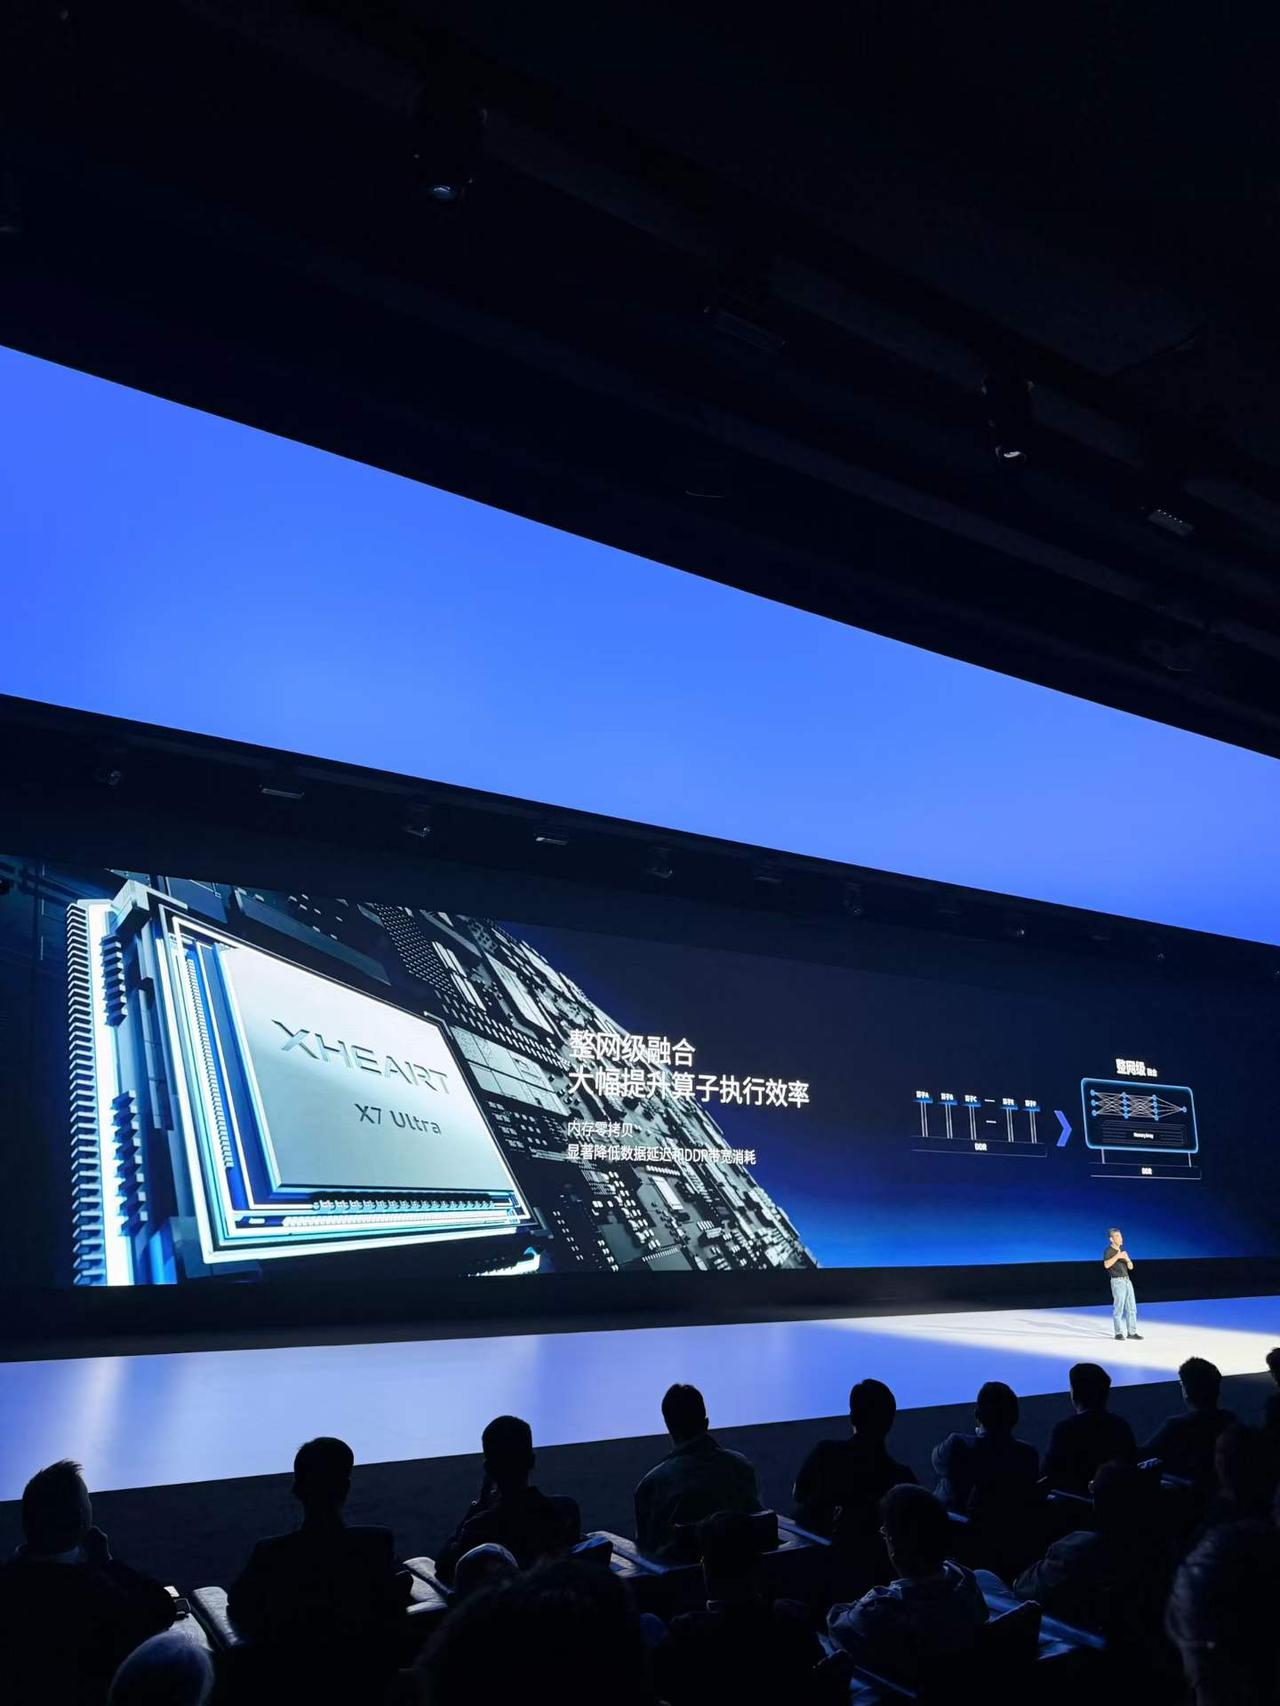
散在各处的小核被并成了一个大核。数据在内部直接换手,速度从百 GB 级跳到 TB 级。模型里最耗时的几步,单独做成了硬件,数据进来直接算,算完就存在旁边。整张网络拆开重排之后,中间结果不出片,走外部内存的只剩输入、输出和权重。
按他们自己的测试,NPU计算利用率 98.7%,内存带宽消耗比行业旗舰低 80%,能效翻了一倍。
同场 Momenta 的 R7 Ultra,参数比上一代大 5 倍以上。路上跑的车已经 140 万台,累计 200 亿公里。芯片腾出来的那点余量,装不下几轮这样的扩张。
台积电 2 纳米已经大规模量产,车规最先进的还是 3 纳米。一颗芯片装上车要用十年,每一代新工艺都得等足够长时间的验证。
芯片两年一代,车三到五年,一辆车在路上十年。跑得最快的那个,得等最慢的那个。所以,算力只是入场券。