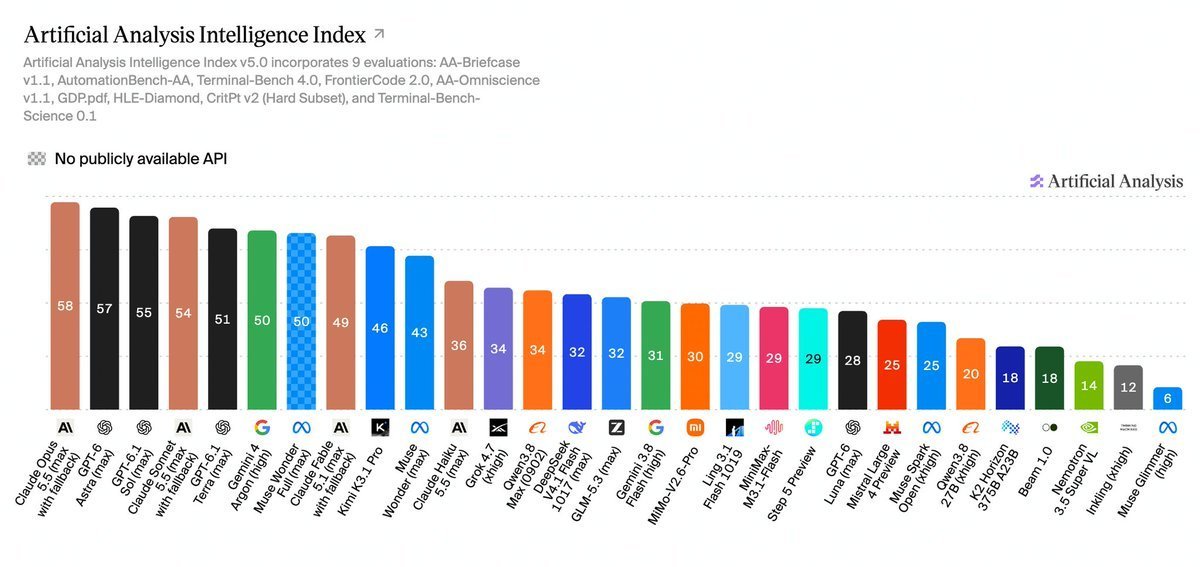
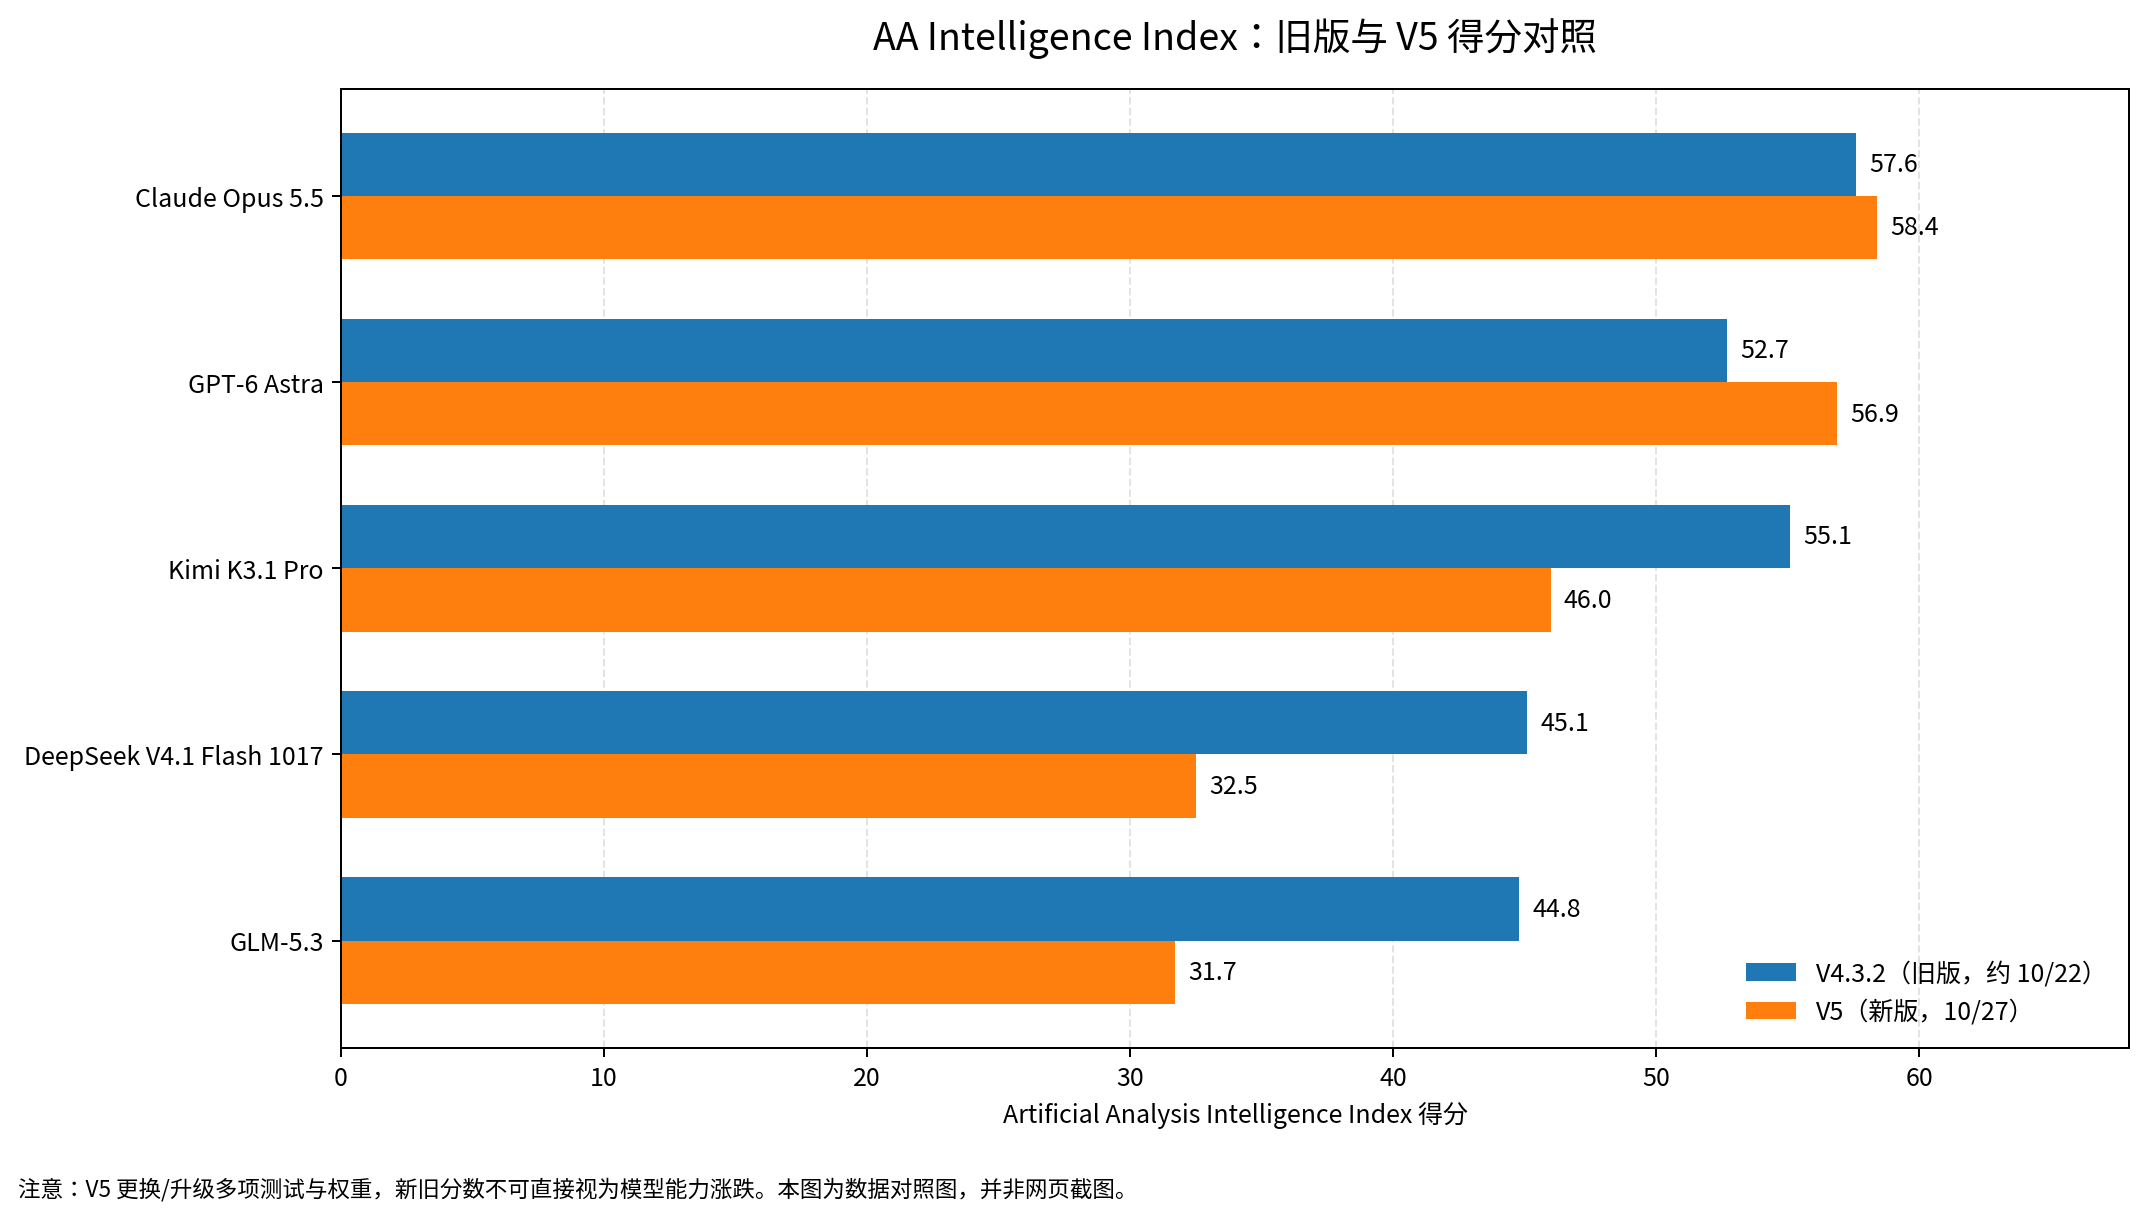
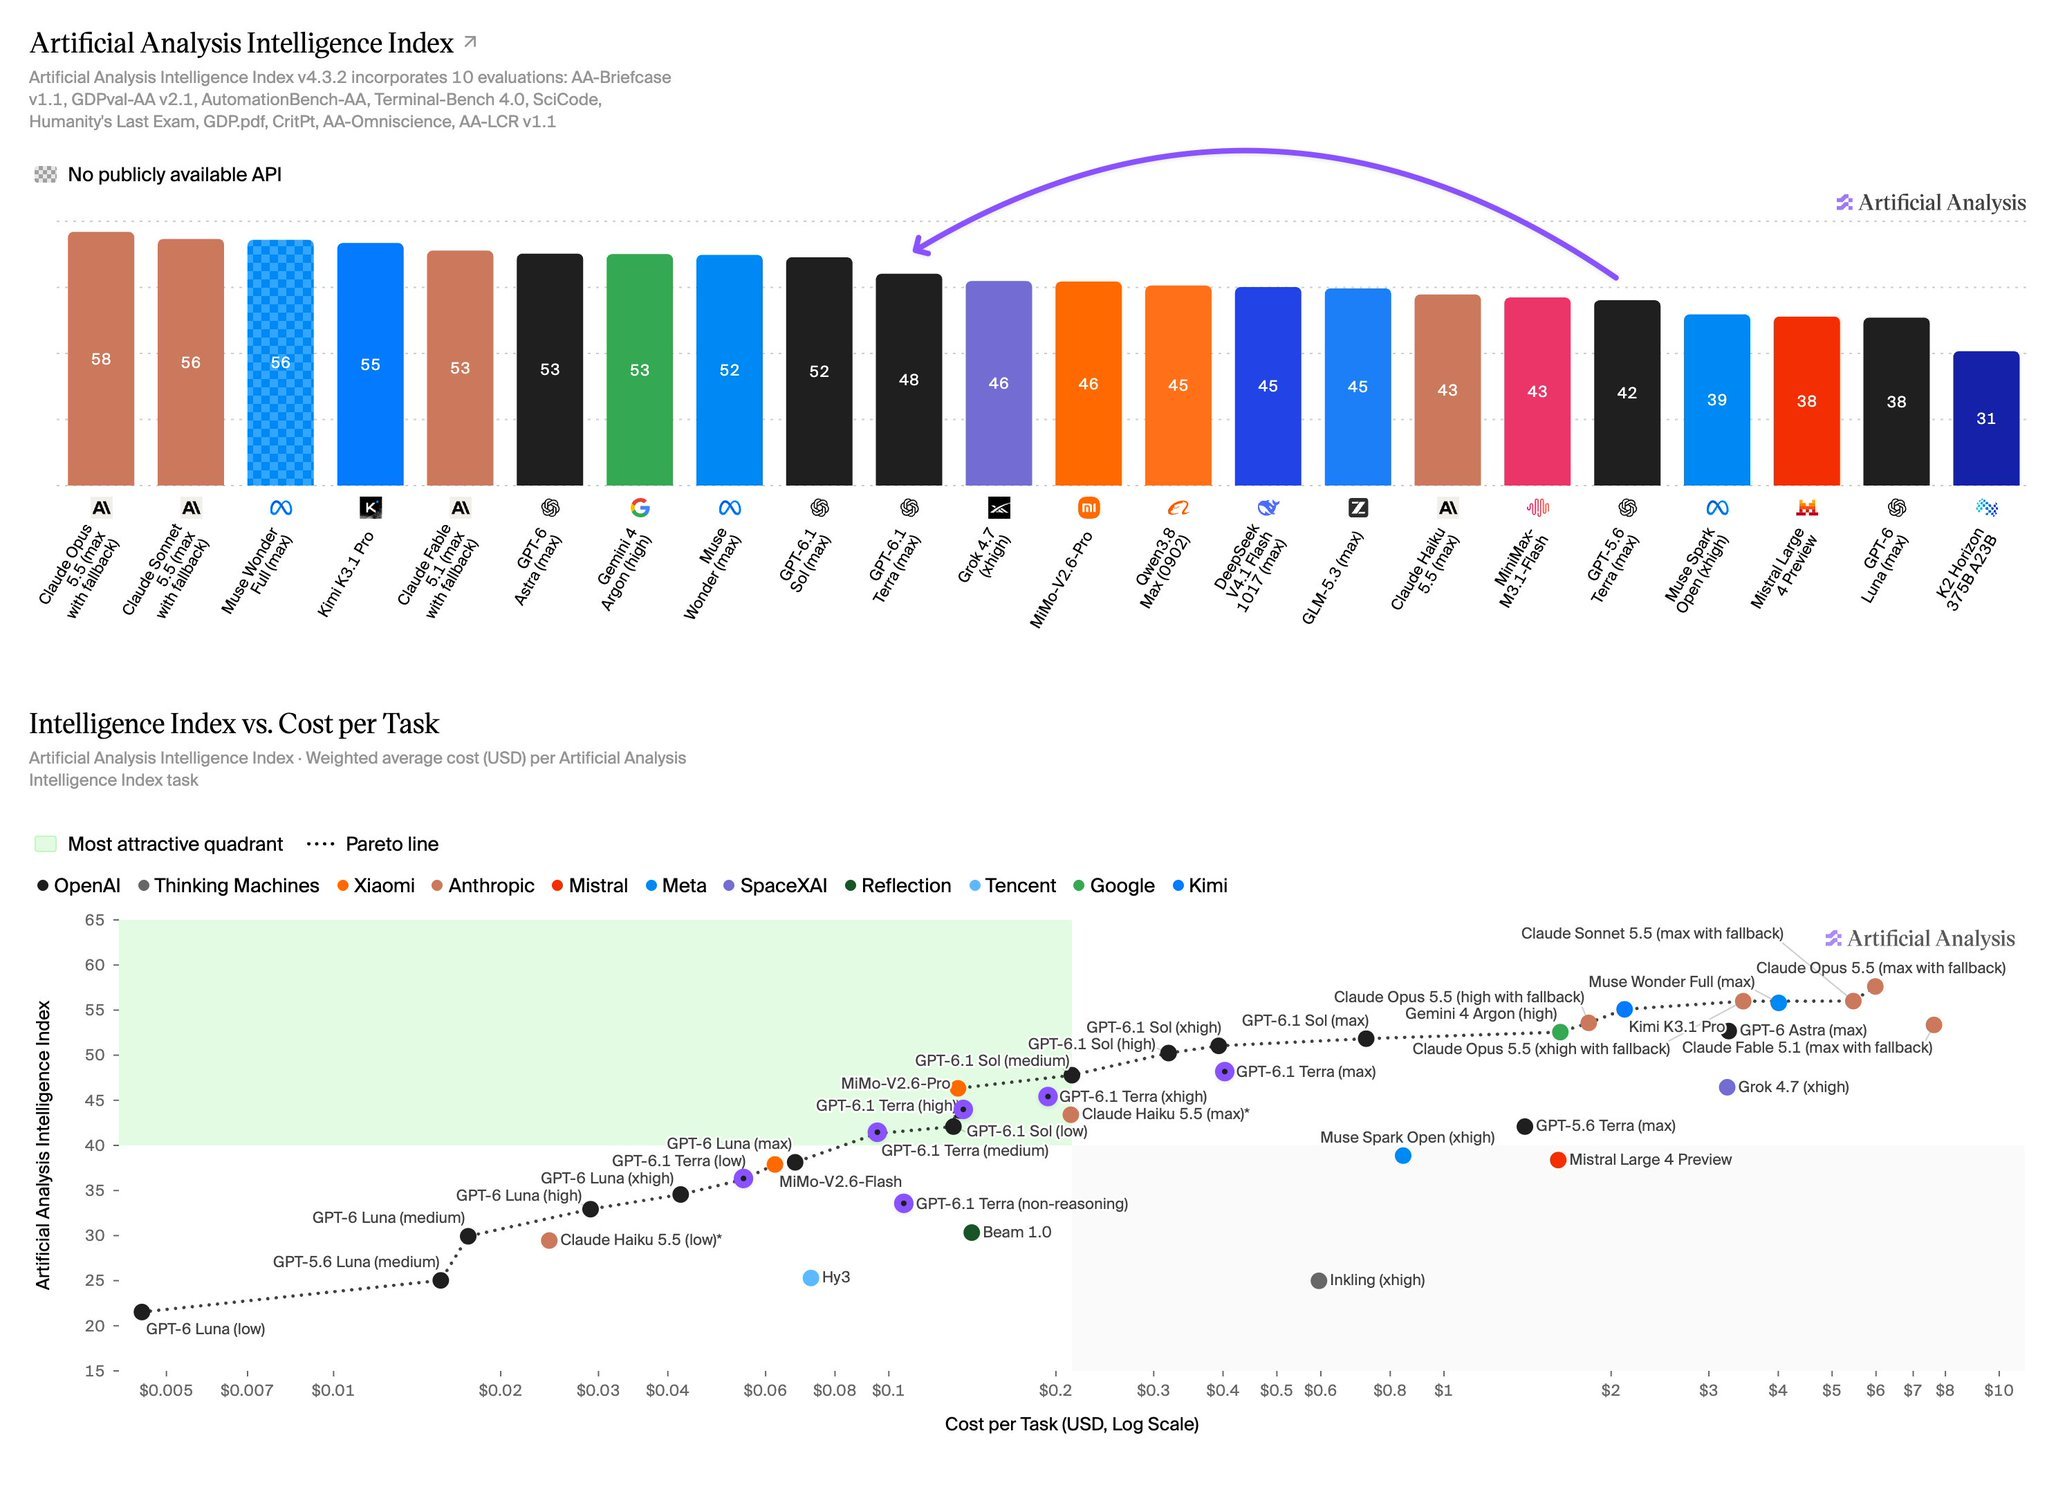
AA Intelligence Index V5 排名出来了,很多模型的得分有比较大的下调。
旧版 DeepSeek V4.1 Flash 1017 得分约45分,新版只有32.5分。GLM-5.3 也差不多,只有31.7分。
再看榜首,Claude Opus 5.5 得分58.4,GPT-6 Astra 得分56.9。开源权重模型和顶级闭源模型之间的差距,明显拉大了。
不过先别急着下结论,这次 V5 不只是更新排名,还换了不少测试项目,60%的评测权重来自私有测试集或保留答案的测试,新旧分数不能直接比较。
但有一点值得关注:AI 评测正在从会答题,转向能不能真正完成复杂任务。以后模型拼的不只是知识和推理,还有实际干活的能力。
你觉得这是 DeepSeek 的短板被测出来了,还是新版测试更偏向闭源模型? DeepSeekAI工具