OpenAI最近的28天计划,越来越让我有一种“黔驴技穷”的感觉。
10月初,OpenAI宣布连续28天优化Codex和ChatGPT Work,每天要么发布一项改进,要么重置用户额度。
原本挺期待,但20多天过去,真正让人印象深刻的不是Codex能力提升了多少,而是OpenAI一次又一次地重置额度。
尤其最近几天,几乎天天重置,甚至有用户反映额度消耗比以前更快了。虽然没有证据证明消耗规则发生了变化,但这种体验确实让人怀疑:OpenAI是不是拿不出足够惊艳的新东西,只能靠送额度维持用户热情?
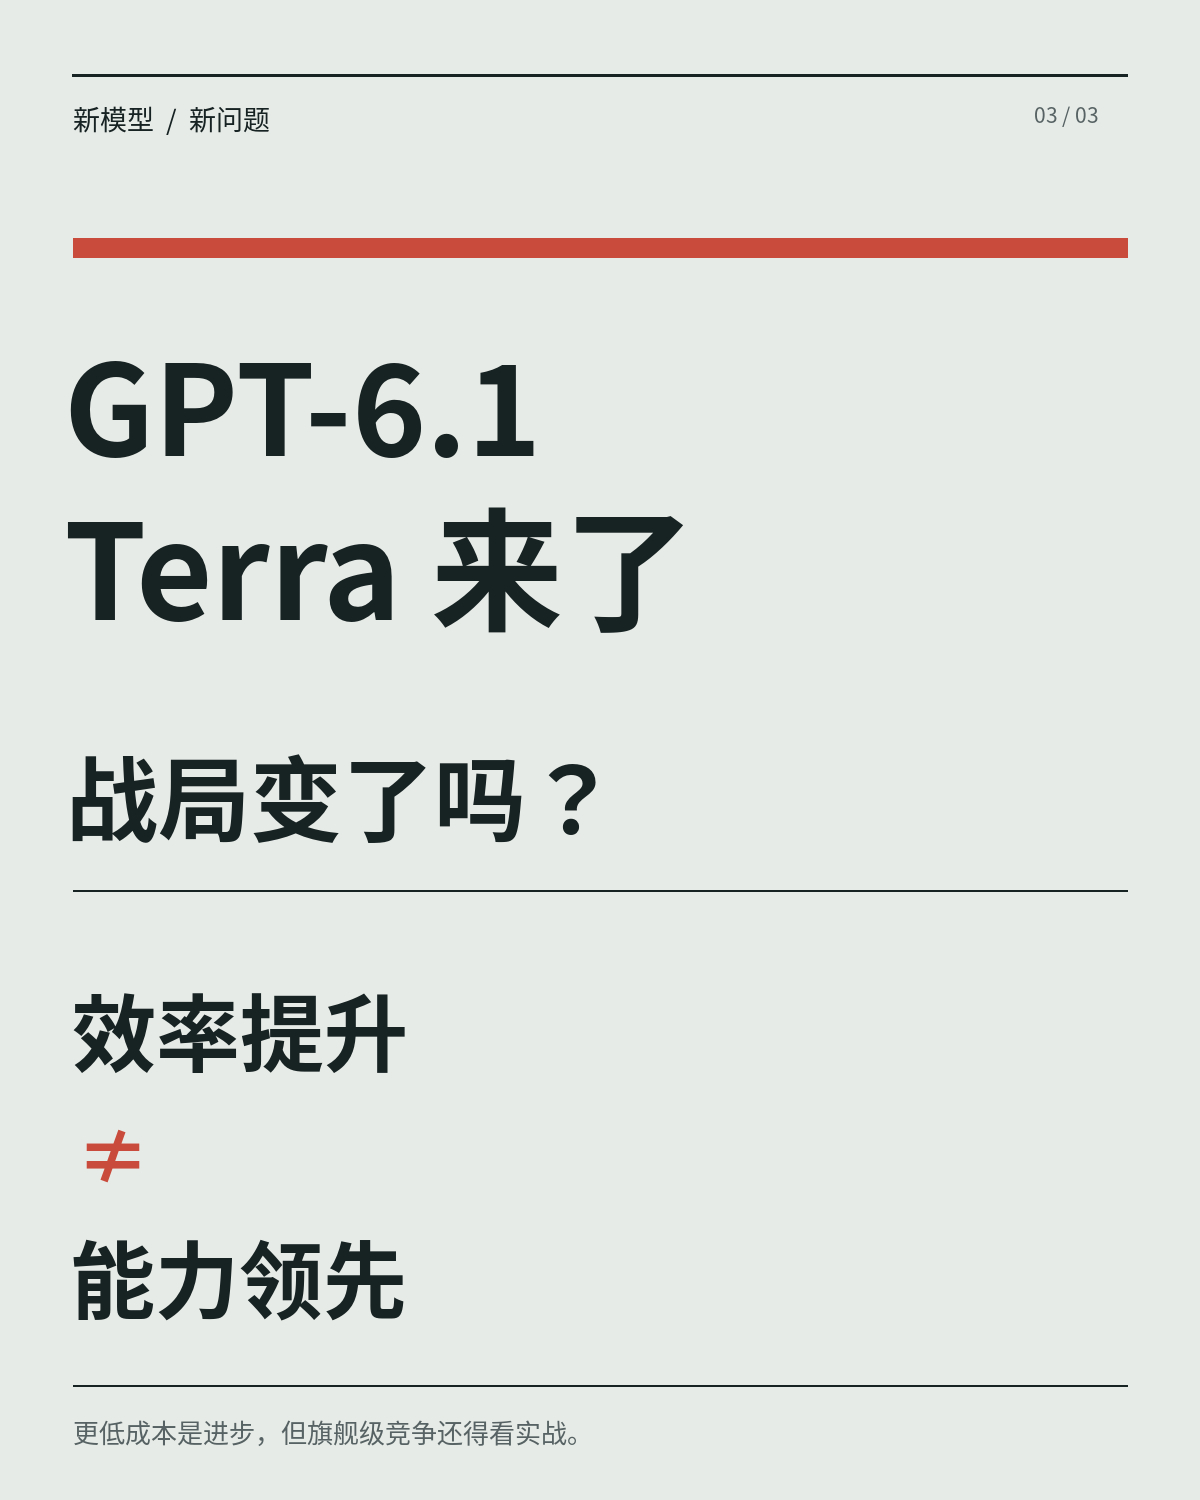
不过,就在今天凌晨,OpenAI终于发布了新模型GPT-6.1 Terra。
这次确实有实质性升级:相比GPT-5.6 Terra,Terminal-Bench 4.0编程测试成绩从21.5%提升到50.3%,API价格降低50%,计算机操作和视觉理解能力也有明显提升。
但问题是,Terra定位的是高性价比、高效率模型,主要解决速度和成本问题。OpenAI自己也承认,更复杂的编程任务仍然推荐使用Sol或Astra。
换句话说,Terra是一款很有价值的产品,但它并不是大家期待的、能在顶级AI编程能力上重新拉开差距的旗舰模型。
再看看竞争对手A。
过去OpenAI几乎代表着大模型领域的最高水平,但如今在AI编程领域,A Code已经形成了很强的竞争力。尤其是复杂项目理解、长链路任务执行、多文件修改等场景,不少开发者认为A的体验更好。
当然,这并不意味着A全面领先,但OpenAI已经没有过去那种让用户默认选择自己的绝对优势。
而且我一直有一个疑问:
如果A正式向中国大陆用户开放,Codex还能留住多少开发者?
虽然OpenAI同样没有正式向中国大陆开放服务,但如果未来A能够降低国内开发者的访问和订阅门槛,那么双方的竞争只会更加直接。
开发者最终看重的不是谁经常送额度,而是谁的模型更聪明,谁能用更少的人工干预完成更多工作。
我并不认为OpenAI真的黔驴技穷了。凌晨发布的Terra也证明,它仍然在持续推进模型能力和推理效率。
但这次28天计划给我的感觉是:面对A的竞争,OpenAI似乎更急于通过额度和运营活动留住用户,而不是用一款真正惊艳的旗舰模型重新建立优势。
额度重置当然是福利,Terra降低使用成本也值得肯定。但这些能否改变重度开发者对Codex和A Code的选择,仍然需要实际体验来证明。
如果28天计划结束后,大家记住的只是重置了多少次额度,而不是Codex究竟变强了多少,那么这场活动真的算成功吗?
AI编程工具最终拼的不是谁送的额度更多,而是谁能以更低的成本、更稳定地完成复杂任务。
这才是OpenAI真正需要面对的竞争。