推荐读一份很有意思的研究。它没有带来一个更强的大模型,而是试着回答一个更基础的问题:已经训练出来的那些模型,我们到底能不能读懂?
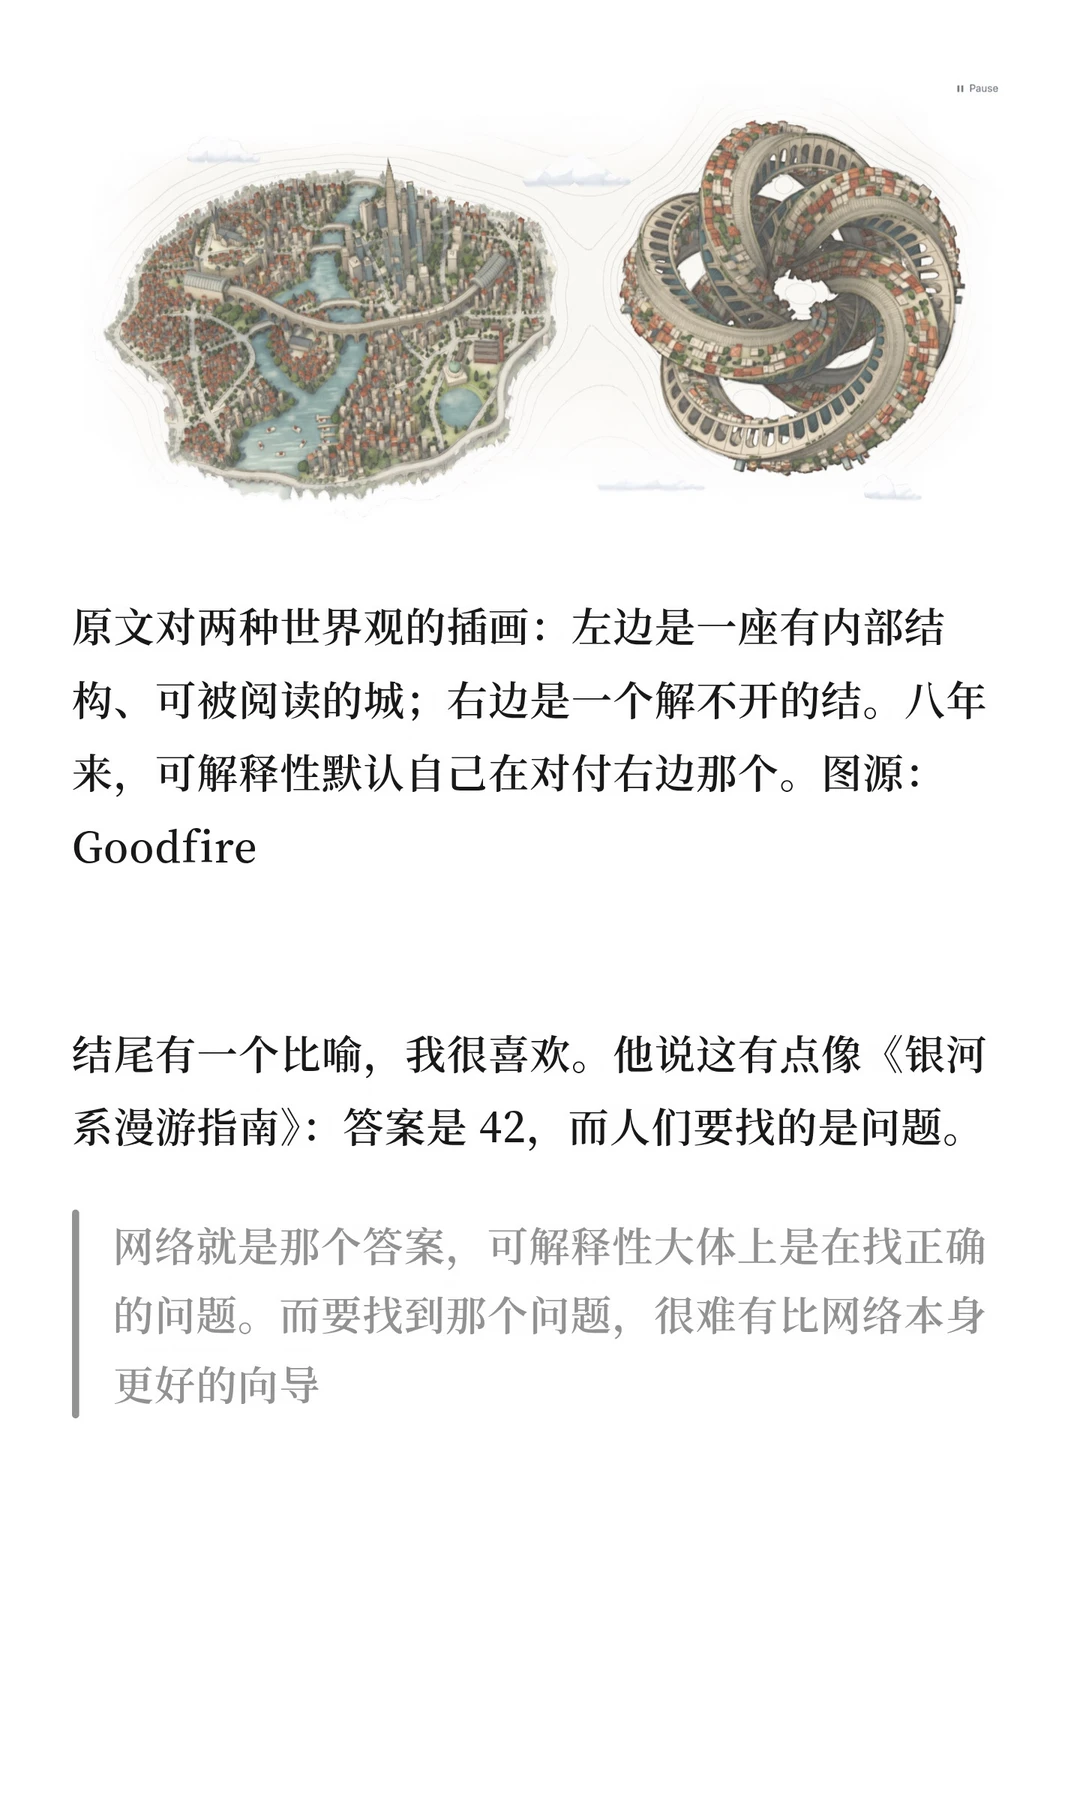
这份工作来自 Goodfire,标题也很直接:《Neural Networks Are Already Clean》——神经网络,已经是清楚的了。作者 Nick Cammarata 想表达的,并不是每个神经元都能贴上一个人类熟悉的标签,而是:网络内部也许本来就有值得理解的组织方式,我们未必需要先把它拆散,再重新拼成一个好解释的模型
如果你一直把大模型看作一个几乎无法进入的黑箱,这篇文章值得花一点时间。它有意思的地方,不只是结论乐观,而是作者拿出了许多具体例子,带着读者重新看那些曾经让人觉得根本看不懂的神经元
#howto修炼提问力 #howto入门codex #howto实现一万种vibecoding #howto入门vibecoding #意识创造一切 #科学的力量 #神仙的多重宇宙 #AI反常识howto #AI搞学习howto