如果把代码、配置、日志、指标和 checkpoint 交给一个 AI Agent,它能不能像经验丰富的 RL 工程师一样,找出真正的根因?
进一步,它能不能修改代码、重新启动训练,并用新的实验结果证明问题确实被修复?
这正是 AutoRLBench 想回答的问题。
来自清华大学 Thinking Space 团队的 AutoRLBench,是一个面向真实、可复现强化学习训练运行的 Agent Benchmark。与很多只看最终结果的 AI-for-AI 评测不同,它不让 Agent 从零搭建一条理想化训练流水线,而是直接把一次真实跑坏的 RL 实验交给它。
Agent 需要完成两件事:
Issue diagnosis:判断训练是否真的有问题,找到根因,并给出证据;
Solution:修改工作区中的代码或配置,重新训练,再由确定性指标验收修复结果。
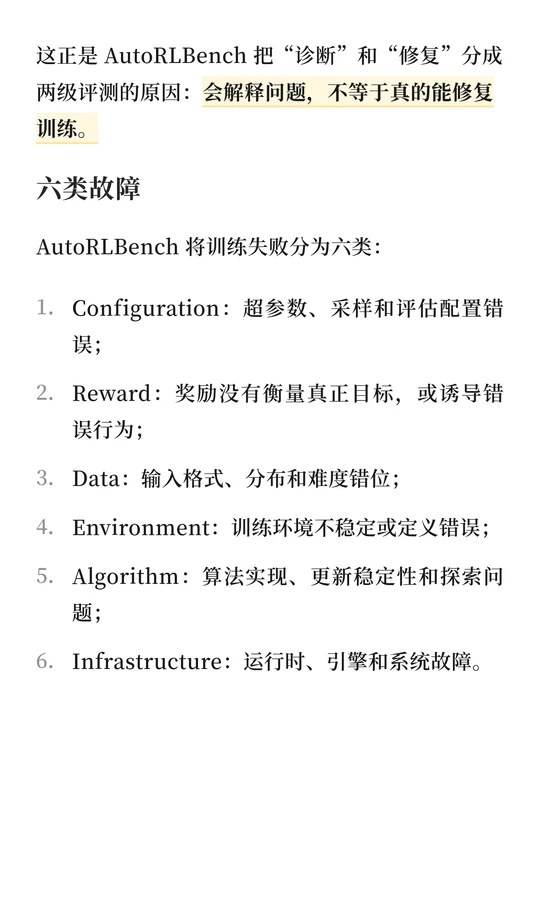
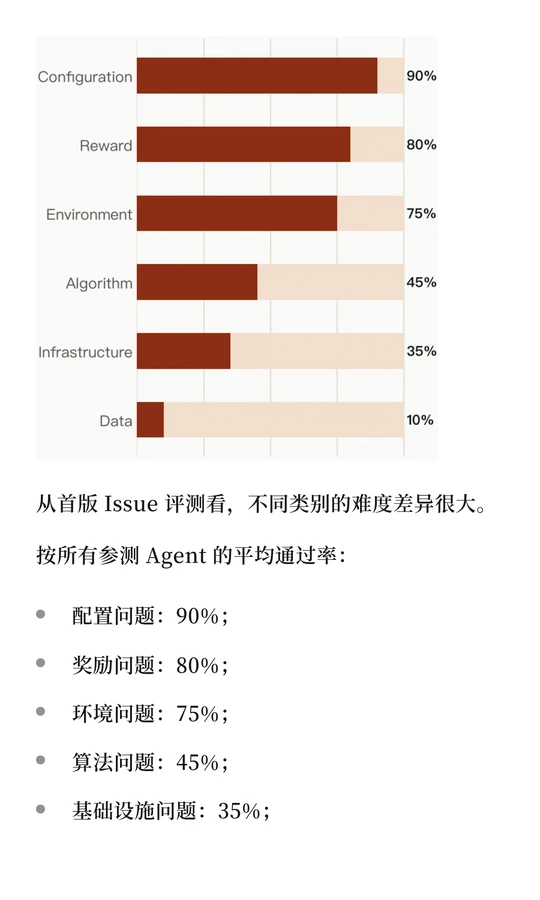
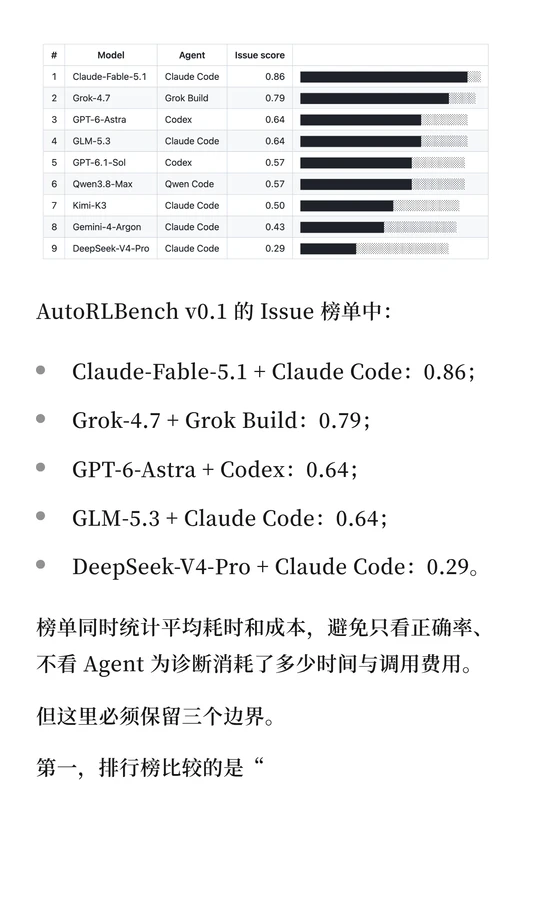
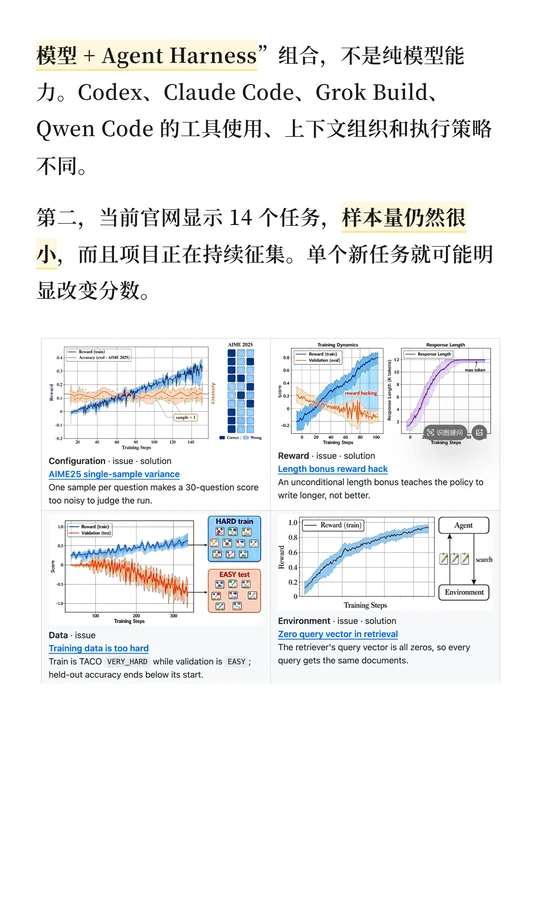
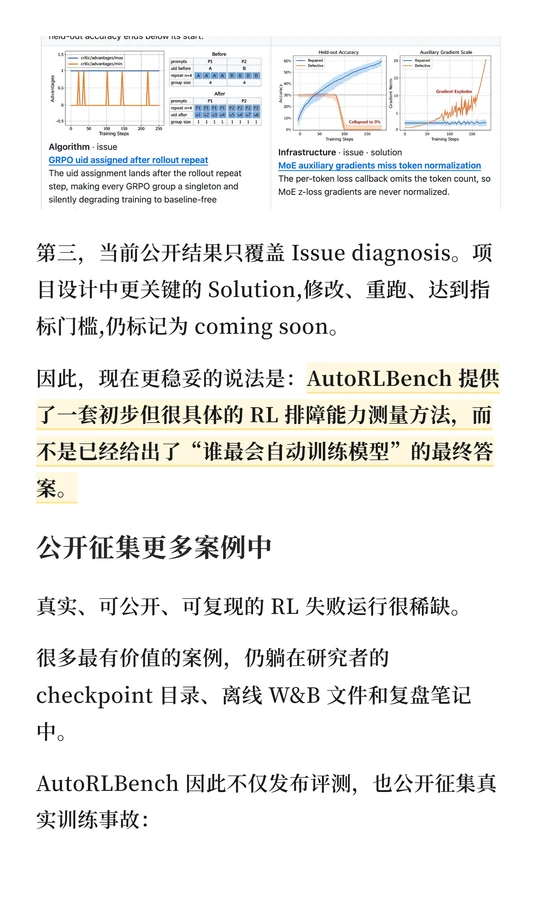
项目当前已整理 14 个任务,覆盖配置、奖励、数据、环境、算法和基础设施 6 类故障;首版榜单测试了 9 组模型—Agent 组合
#强化学习 #强化学习算法 #强化学习入门 #强化学习训练 #howto入门codex #howto实现一万种vibecoding #深度学习 #科研学习 #AI搞学习howto #人工智能发展