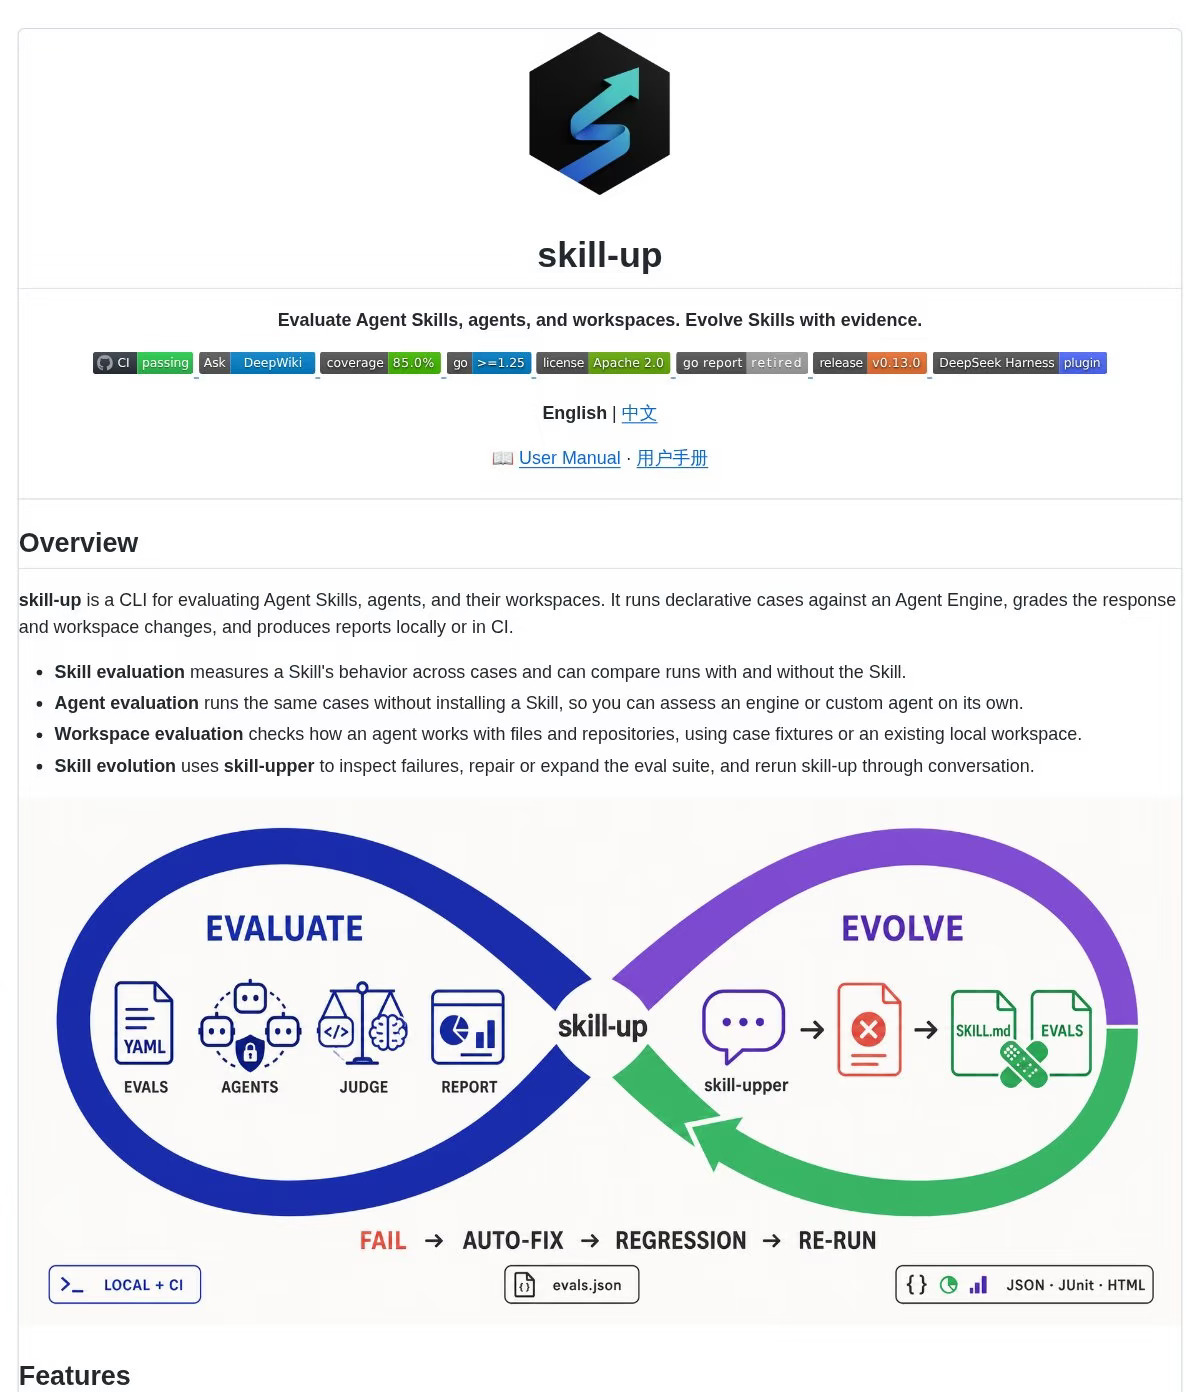
最近注意到阿里巴巴开源了 Skill-Up,它想解决的是一个很实际的问题:现在 Agent Skills 越来越多,但怎么证明一个 Skill 真的提升了 Agent 能力?改完之后是变强还是变弱?当 Skills 开始进入团队协作和交付,这类“有没有用”的评测就会变得重要。👀 以前大家更关注怎么写、安装和管理 Skills,现在开始关注量化它们的价值,以及怎么让它们持续进化。
它有几个点值得看:
1. 支持 Skill A/B 测试,能对比有 Skill 和没 Skill 的实际效果;评估方式包括 LLM Judge、脚本校验等,结果输出到本地或 CI。项目页显示支持 JSON、JUnit、HTML 报告。
2. 兼容 Codex、Claude Code 等 Agent,也能接入自定义 Agent Engine,覆盖面不局限在单一工具链。
3. 更有意思的是 skill-upper:它会根据评测失败的结果,自动分析原因、修改 Skill、补充测试用例,再重跑评测,形成 Evaluate → Diagnose → Fix → Rerun 的闭环。项目页把这条路径画成 Evaluate 和 Evolve 两段,并强调 FAIL → AUTO-FIX → REGRESSION → RE-RUN。
我的看法是,这个方向值得关注,但现阶段不用把它想得太万能。自动优化确实能省去一部分排查和修补时间,不过测试集过拟合、评测污染这些风险也真实存在,自动改出来的 Skill 效果可能还需要人工复核。我倾向于认为,这类工具目前更可能在交付环节体现价值:上线前跑一轮,确认 Skill 确实让 Agent 变强;日常开发里未必需要一直全量评测。对读者来说,如果你在团队里维护多个 Skills,或者要把 Agent 能力交付给业务方,Skill-Up 这类思路可能会让“凭感觉调 Skill”慢慢变成可量化的流程。以后 Skills 或许也会像软件工程一样,有自己的测试、回归和持续改进体系。
你们会愿意让 Agent 自动改 Skill 吗,还是更倾向人工确认每一步?🤔
#AI新鲜事