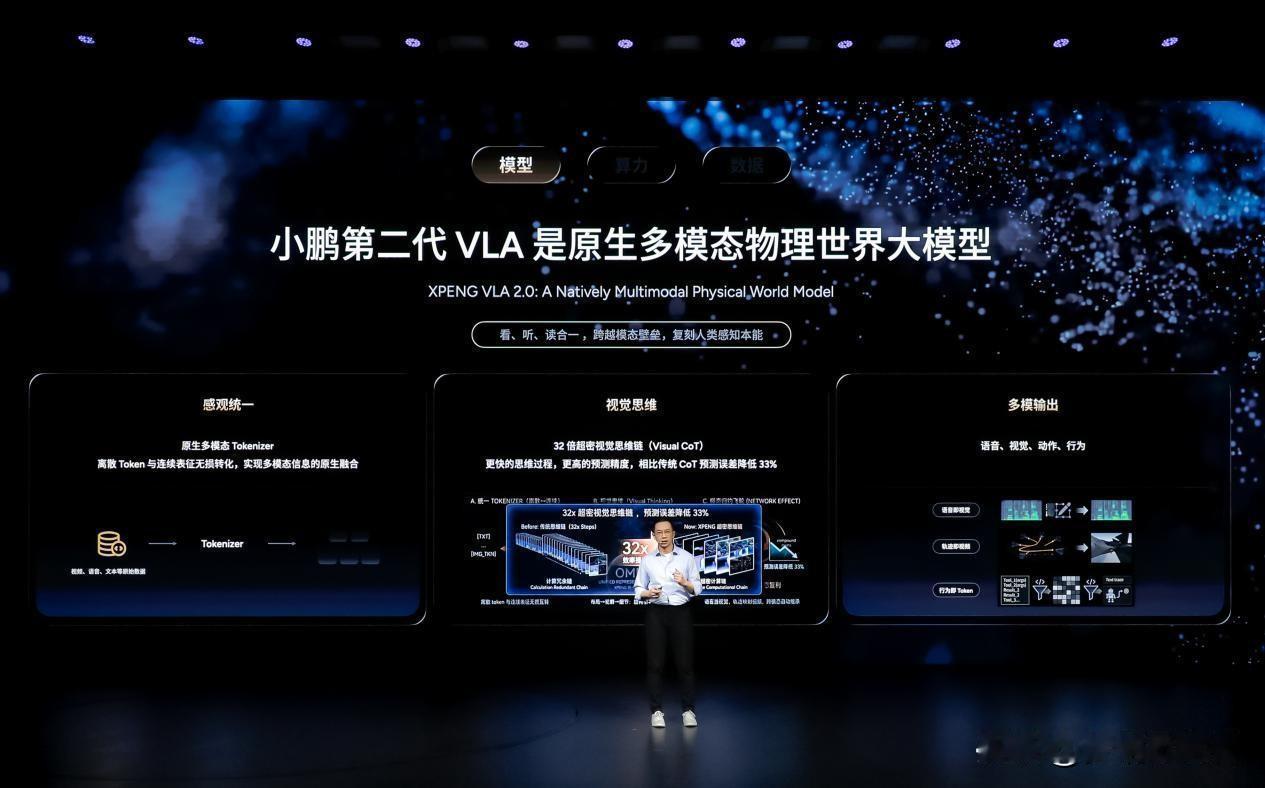
小鹏L4智驾采用纯视觉端到端大模型技术路线,不依托激光雷达与高精地图,凭借第二代VLA物理世界大模型打通感知、推理、决策、执行全链路,目标跨过L3阶段直接落地L4无人驾驶能力。
一、硬件根基
传感器:采用纯视觉方案,依托多枚摄像头采集环境影像,撤去激光雷达,也无需高精地图,靠视觉实时完成环境重建。
算力平台:Robotaxi搭载4颗自研图灵AI芯片,有效算力达3000TOPS;量产车型搭载多颗图灵芯片,提供充足高算力支撑大模型本地推理。
安全冗余:采用硬件双冗余架构,两套系统互为备份,单套失效时可快速切换,牢牢守住L4安全底线。
二、核心算法:第二代VLA物理世界大模型
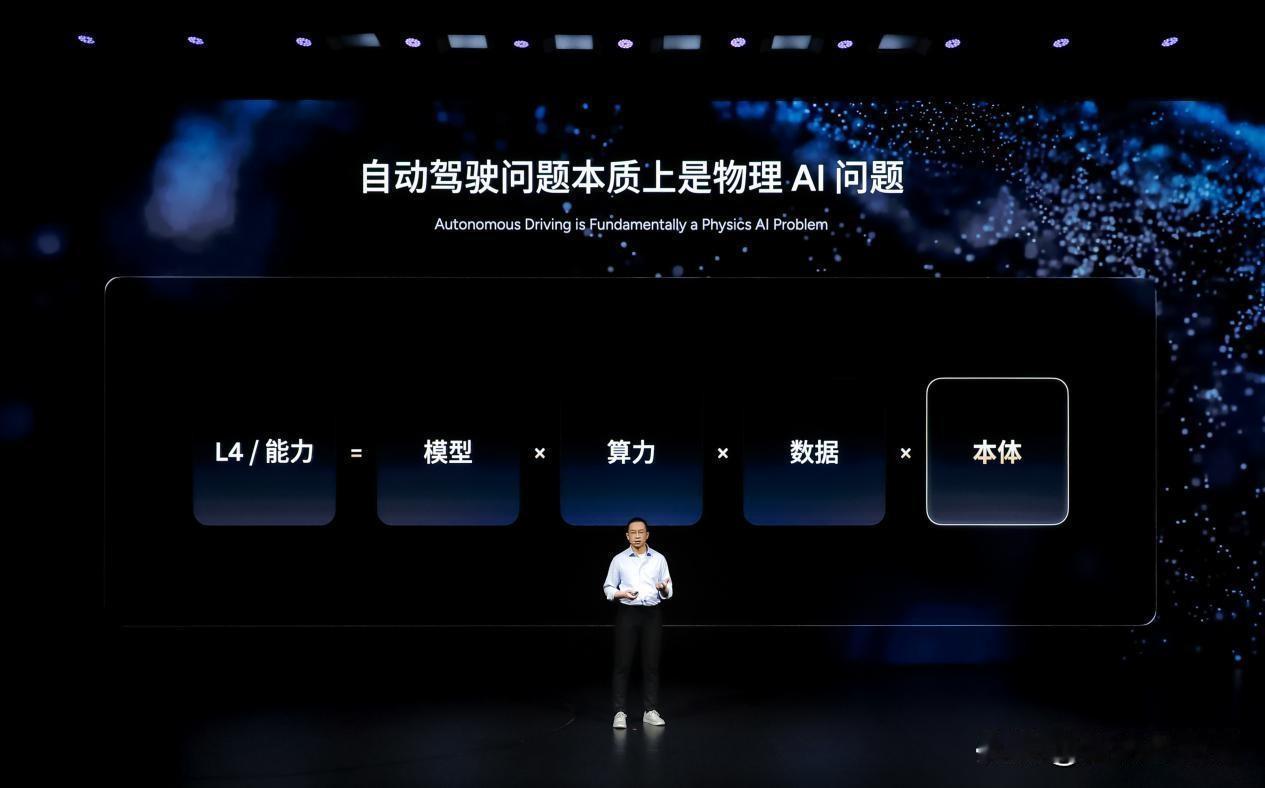
小鹏将自动驾驶定义为物理AI问题,对应公式:L4能力 = 模型 × 算力 × 数据 × 本体。
端到端架构:剔除传统“视觉‑语言‑动作”的中间转译环节,摄像头输入图像后直接输出驾驶动作,系统延迟低于80ms,响应更为迅捷。
多模态理解:VLA模型能够“看、读、理解”现实世界,除识别车辆行人外,还能读懂交通标识、道路规则、各类动态长尾场景,具备时空推理能力,可预判后续路况变化。
泛化能力:无需依赖高精地图,模型学习海量真实驾驶数据,遇到未训练过的陌生路口、城市也能自主通行,便于跨城市、海外落地部署。
数据闭环:依托云端大规模智算集群开展训练,累计储备50PB训练数据,持续迭代模型版本,稳步提升复杂场景应对能力。
三、完整工作流程
车载摄像头采集周边全部视觉画面;
图灵芯片本地运行第二代VLA大模型,实时感知各类物体、路况与交通参与者;
模型开展时空推理,预判未来数秒的路况变化,直接输出转向、刹车、加速等驾驶指令;
指令下发至底盘执行,同时硬件冗余系统全程实时监控,出现异常时即刻启动安全兜底机制。
四、路线特点(跳过L3)
L3属于有条件自动驾驶,仍要求人类随时接管,人机责任界定十分复杂;
小鹏选择直接攻坚L4:在限定运营区域内,车辆承担驾驶主体责任,无需人类全程监控接管,面向Robotaxi无人驾驶运营场景,这套同源技术后续也将下放至民用量产车型。
注:当前小鹏L4主要落地在Robotaxi示范运营场景;面向普通消费者的量产车现阶段仍为L2+高阶辅助驾驶,并非完整的L4无人驾驶。
如果你有需求,我可以帮你对比小鹏这套纯视觉L4与华为激光雷达方案的差异。如何看待小鹏00后产品经理的“老登”言论