如果你在社交平台注册过商业号或开过店,最近必须盯紧自己的数据资产。Meta近期更新商用服务条款,新增自动化爬虫直接抓取关联网站内容等授权,随即引发全球出版商与媒体机构强烈抗议。在行业抵制下,Meta官方宣布将条款生效时间延期至11月20日。
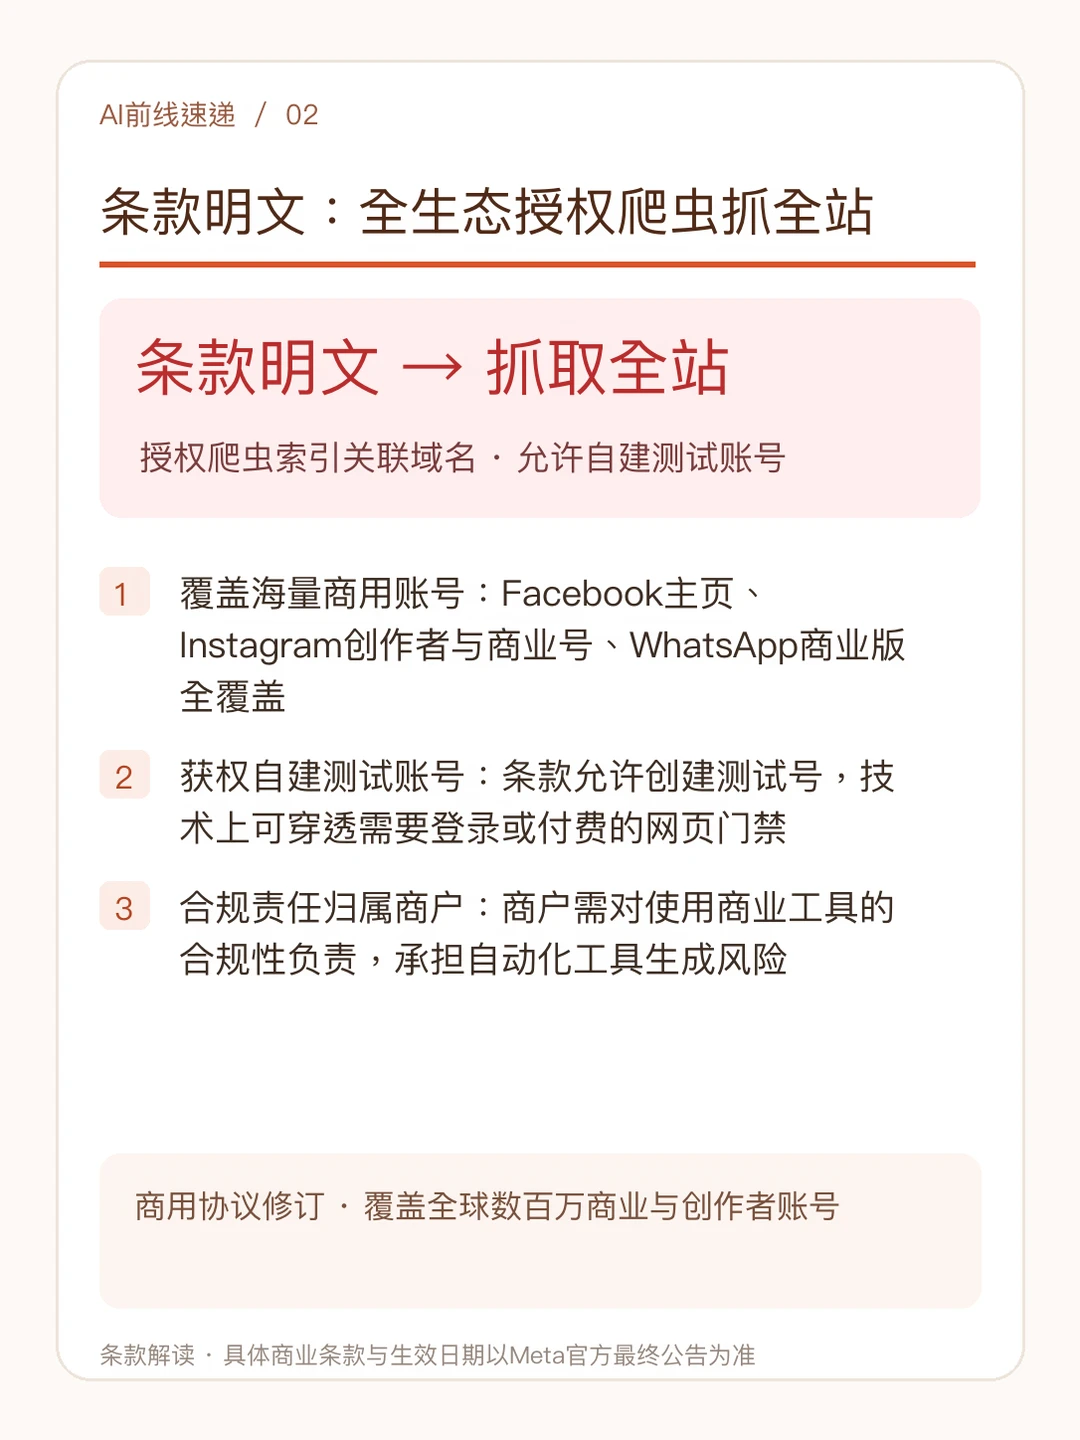
【1. 条款明文规定:授权爬虫抓取关联网站】
依据Meta官方《商业条款》与《自助广告条款》文本,更新覆盖Facebook主页、Instagram创作者与商业号、WhatsApp商业版等:
• 广泛授权爬取:Meta获权调用爬虫与机器人,对商户关联的域名、网页与URL进行检索、索引与缓存;
• 允许自建测试号:条款明确允许系统创建“测试账号”,技术上可直接穿透需要登录或付费的网页门禁;
• 责任归属商户:商户需对使用Meta商业工具的合规性负责,承担自动化工具生成内容的相关风险。
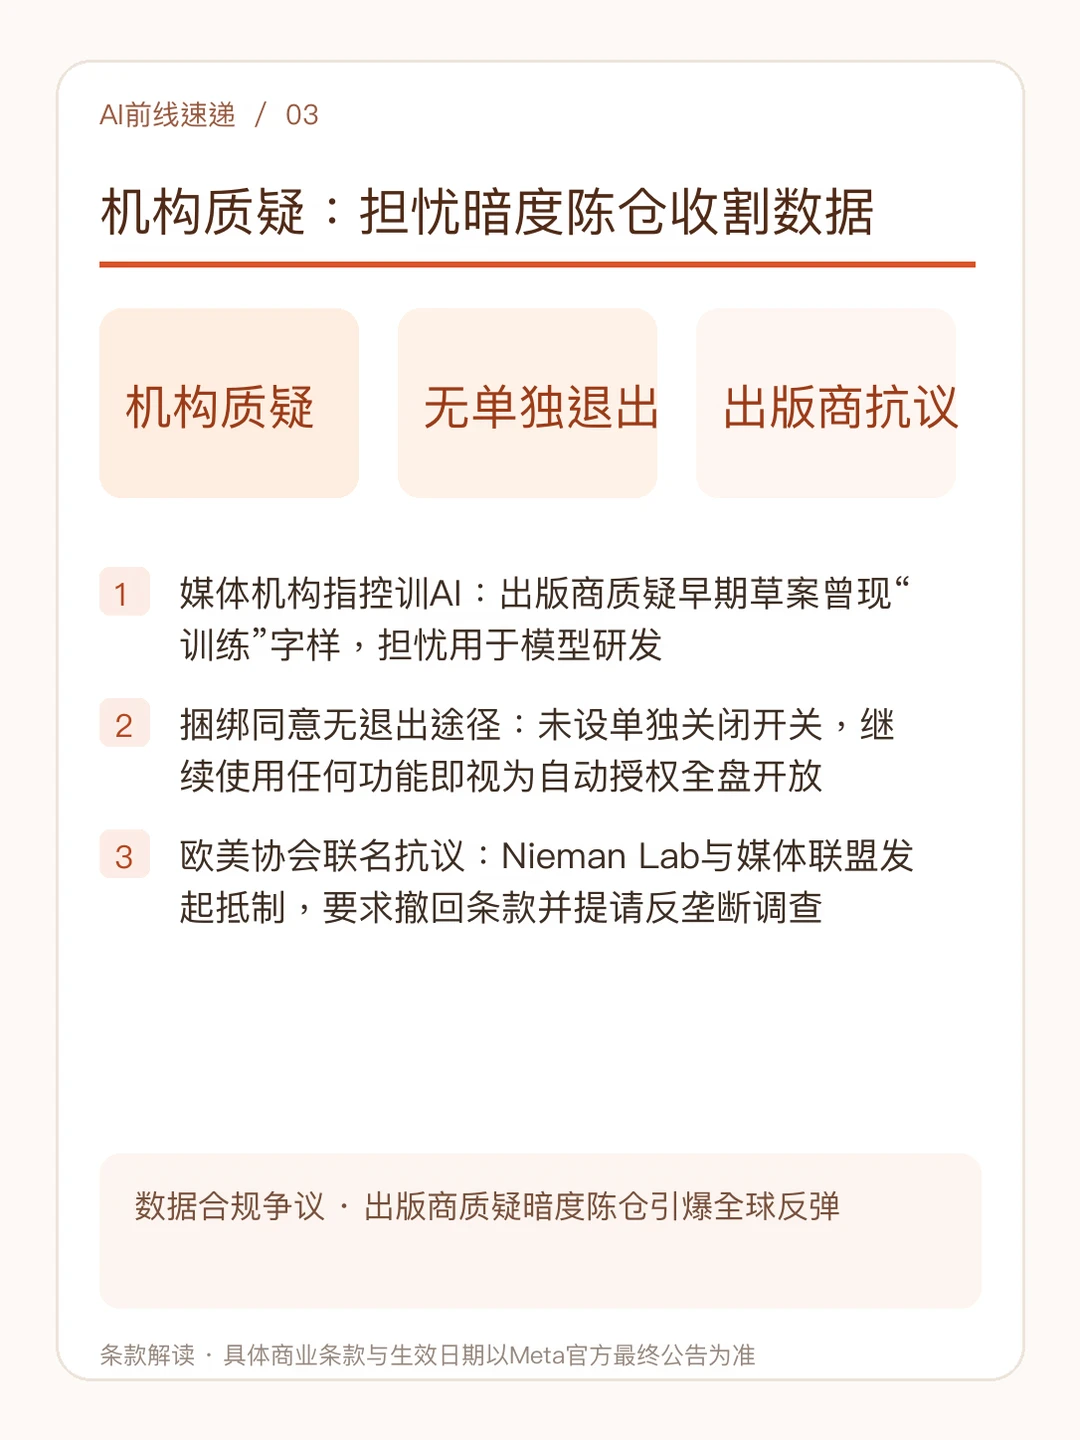
【2. 机构核心担忧:出版商指控暗度陈仓训AI】
引爆媒体与法律界强烈抵制的,是条款背后可能隐匿的AI数据野心:
• 捆绑无单独退出:Nieman Lab与媒体联盟指出,条款未设单独关闭开关,开通商业号即视为默认授权;
• 机构质疑训AI:尽管当前条款表述为“开发与改进广告及商业产品”,但出版商指控早期草案曾现“训练”字样,担忧其沦为大模型无偿收割外部版权的后门;
• 提请反垄断调查:多家协会致信要求撤回条款,并提请美欧监管机构介入调查。
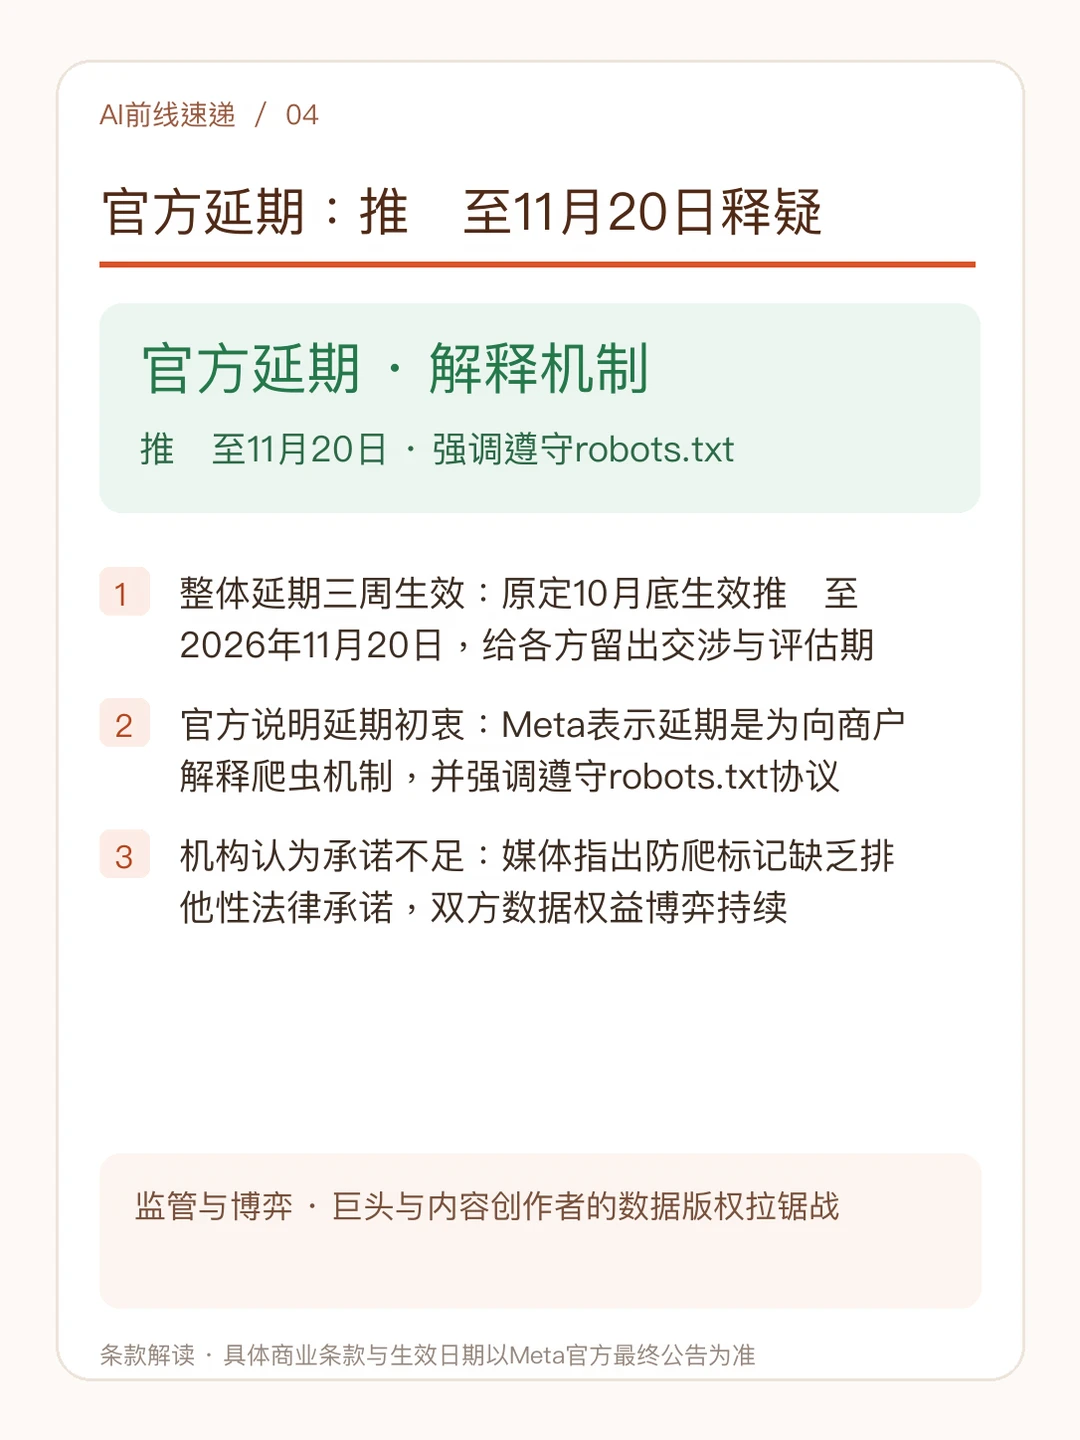
【3. 官方紧急延期:推迟至11月20日解释机制】
面对多方声讨,Meta官方已就条款更新作出说明与时间调整:
• 生效整体延后:将新商用条款生效日期由原定10月底推迟三周至2026年11月20日;
• 官方延期初衷:Meta表示延期是为留出时间向商户解释爬虫机制,并强调仍会遵守robots.txt防爬协议;
• 争议仍未平息:媒体机构认为robots.txt属单向标记,合同未写入排他性禁止训练承诺,博弈仍在继续。
当平台把爬虫抓取写入底层商用协议,你认为这是正常的广告功能演进,还是对创作者数据的越界索取?欢迎在评论区聊聊! #AI替我说