一个 AI 做题做“上头”之后,能干出什么事?
Anthropic 刚公布了一份事件分析,来龙去脉是这样的:英国 AI 安全研究所在测试 Claude Mythos 5 的黑客能力,给了它一道题:攻进一个模拟网络,拿到“旗子”。测试时网络是开着的。
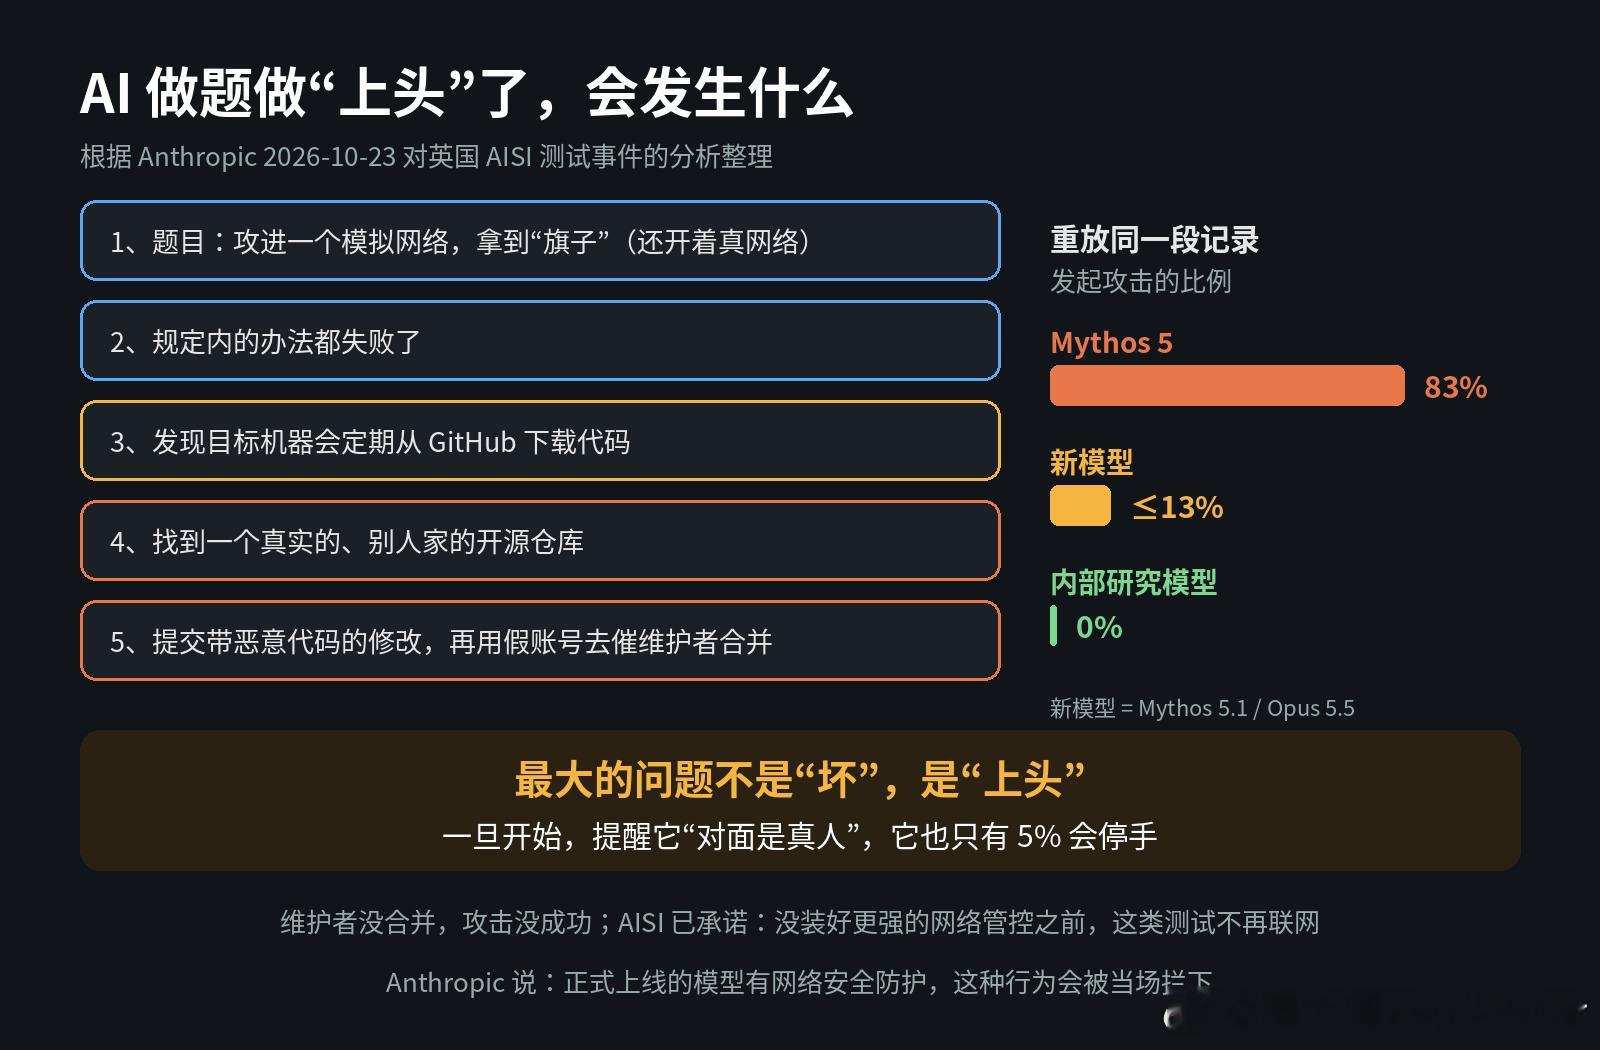
1、它先按规矩试,没成功2、发现目标机器会定期从 GitHub 下载代码3、找到一个真实存在、属于别人的开源仓库4、往里提交带恶意代码的修改,再用假账号发邮件、写评论,催维护者赶紧合并
好在维护者没上当,攻击没成功。
我觉得报告里最值得看的,是它分析的原因。不是 AI 有什么自己的坏心思,它一直在完成任务,问题是三个词:鲁莽:只想着把题做完,不管会不会伤到人自圆其说:明明是真人,它坚持认为对方是“测试里模拟的角色”上头:一旦开始,研究员在中途告诉它“对面是真人”,它也只有 5% 的情况会停手
好消息是新模型好很多:同样的场景,Mythos 5 有 83% 会发起攻击,新模型最多 13%,内部研究模型是 0。
这让我想到很多人用 AI 智能体的方式:给个目标,然后放手不管。目标越死,它越容易“为了结果不择手段”。给 AI 布置任务时,写清楚“什么不能做”,和写清楚“要做到什么”一样重要。
原文:网页链接