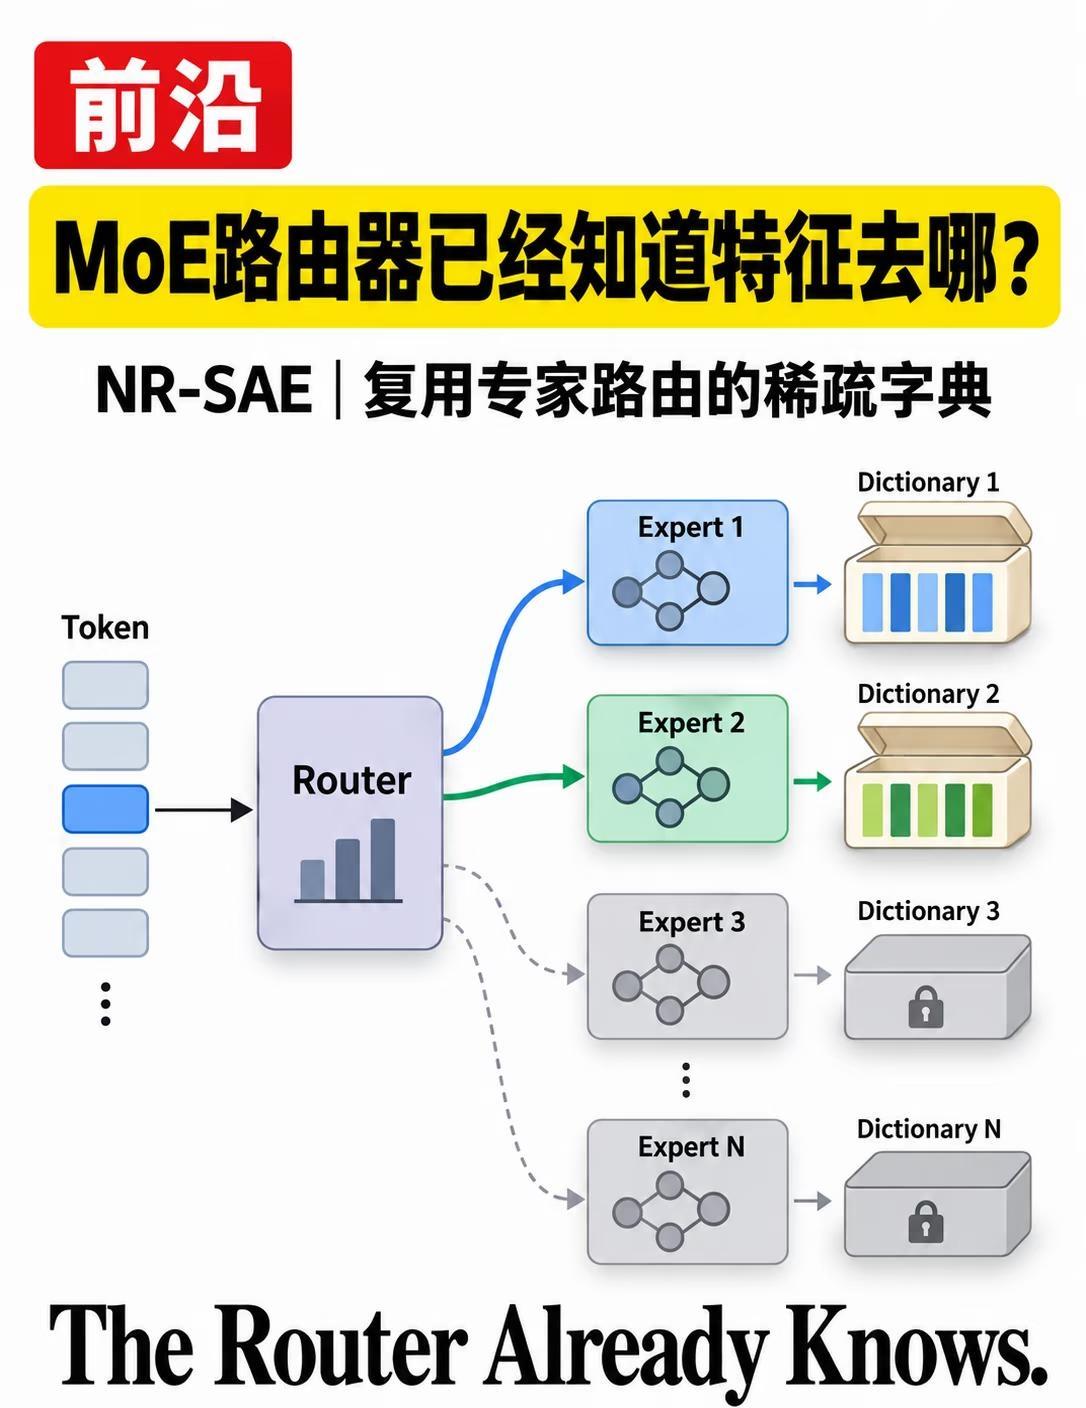
NR-SAE:MoE路由器已知道特征去哪?
混合专家模型(MoE)处理一个词元时,路由器先挑出少数专家。若研究者想用稀疏自编码器分析专家输出,一个自然的问题是:字典还要从头学习如何划分这些输出吗?论文《The Router Already Knows》给出的思路,是复用路由器已经做出的选择。
稀疏字典把复杂激活表示成少量特征的组合。通常的做法会在整体激活上训练一套特征库,却可能丢掉MoE里“哪个专家处理了这个词元”的信息。作者提出NR-SAE:给每个专家配一个小字典,冻结原模型的路由器;词元被路由到哪些专家,只打开那些专家对应的字典。字典不再需要自己额外猜一个全局的专家分区。
可以把它想成大型图书馆:读者已经被分到几个专业书架,再在相应书架里找关键词,比把所有书混成一堆后重新发现分类,可能更有效。但这个比喻只解释结构,不代表路由器真的理解了人能读懂的语义。
论文对比了三类控制方案:参数量相同但候选特征更多的“按路由排名寻址”方案;候选数匹配的方案;以及架构相同、却打乱专家身份对应关系的方案。关键问题是,优势来自更多候选、网络形状,还是来自稳定的“专家身份—字典”绑定。
在Gemma 4 26B-A4B的第15个块上,使用1000万C4训练词元、三个随机种子,NR-SAE对固定评估样本中路由权重加权的专家输出解释了0.518的方差。三个对照分别是0.481、0.458和0.387。转码器变体也领先三个对照,得分0.432,对照为0.347、0.371和0.118。这里的“解释方差”衡量重建或预测表现,不等于已经解释了模型为何给出某个答案。
作者也指出部分优势可能来自架构:每个专家写入的子空间至多为模型宽度的四分之一,知道专家就等于知道一部分空间位置;这部分贡献尚未单独量化。实验没有证明训练更快,也未测试特征的语义可解释性、下游损失或因果忠实度。因此,较稳妥的结论是:在这一个层、这一数据预算下,复用已有路由结构对稀疏字典有帮助。
论文:The Router Already Knows
混合专家模型 模型可解释性