Qwen3.8-27B Q3 RTX5080 实测
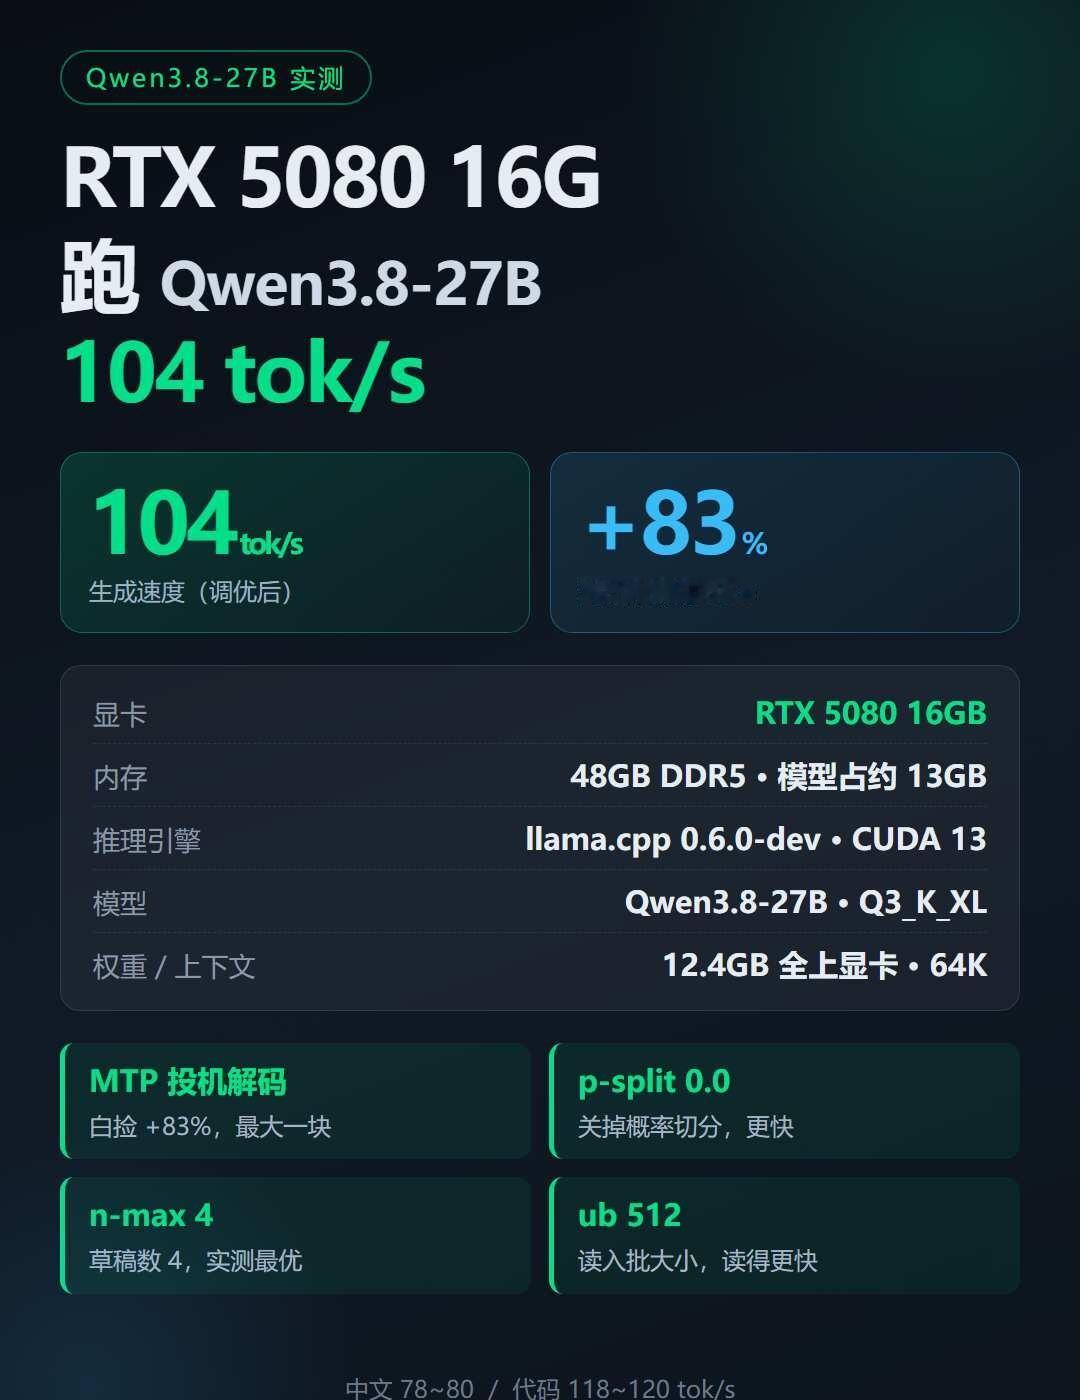
🖥 硬件
· 显卡:RTX 5080 16GB
· 内存:48GB DDR5-6000(模型运行占约 13GB)
⚙️ 引擎和模型
· 推理引擎:llama.cpp 0.6.0-dev(CUDA 13 加速)
· 模型:Qwen3.8-27B,Q3_K_XL 量化
· 权重 12.4GB,全部装进 16G 显存,上下文 64K
📈 速度
· 没调之前:56.8 tok/s
· 调完之后:104 tok/s,提升 83%
· 分场景:中文长文 78~80,代码 118~120,英文技术 111~113
🔧 开了这几个
1️⃣ MTP 投机解码——模型自带预测头,白捡 +83%,最大的一块
2️⃣ p-split 0.0——关掉概率切分,反而更快
3️⃣ n-max 4——草稿数 4,这台机器实测最优
4️⃣ ub 512——读入批大小,读长文更快
显存吃满 15.2GB,内存再占 13GB 做权重缓存(可回收,不够时系统会自动释放)。不连网、不花钱、数据不外传。
Qwen3.8-27B Qwen RTX5080 本地大模型 AI工具