Prompt 转 JSON 难溯源?试试 LangExtract
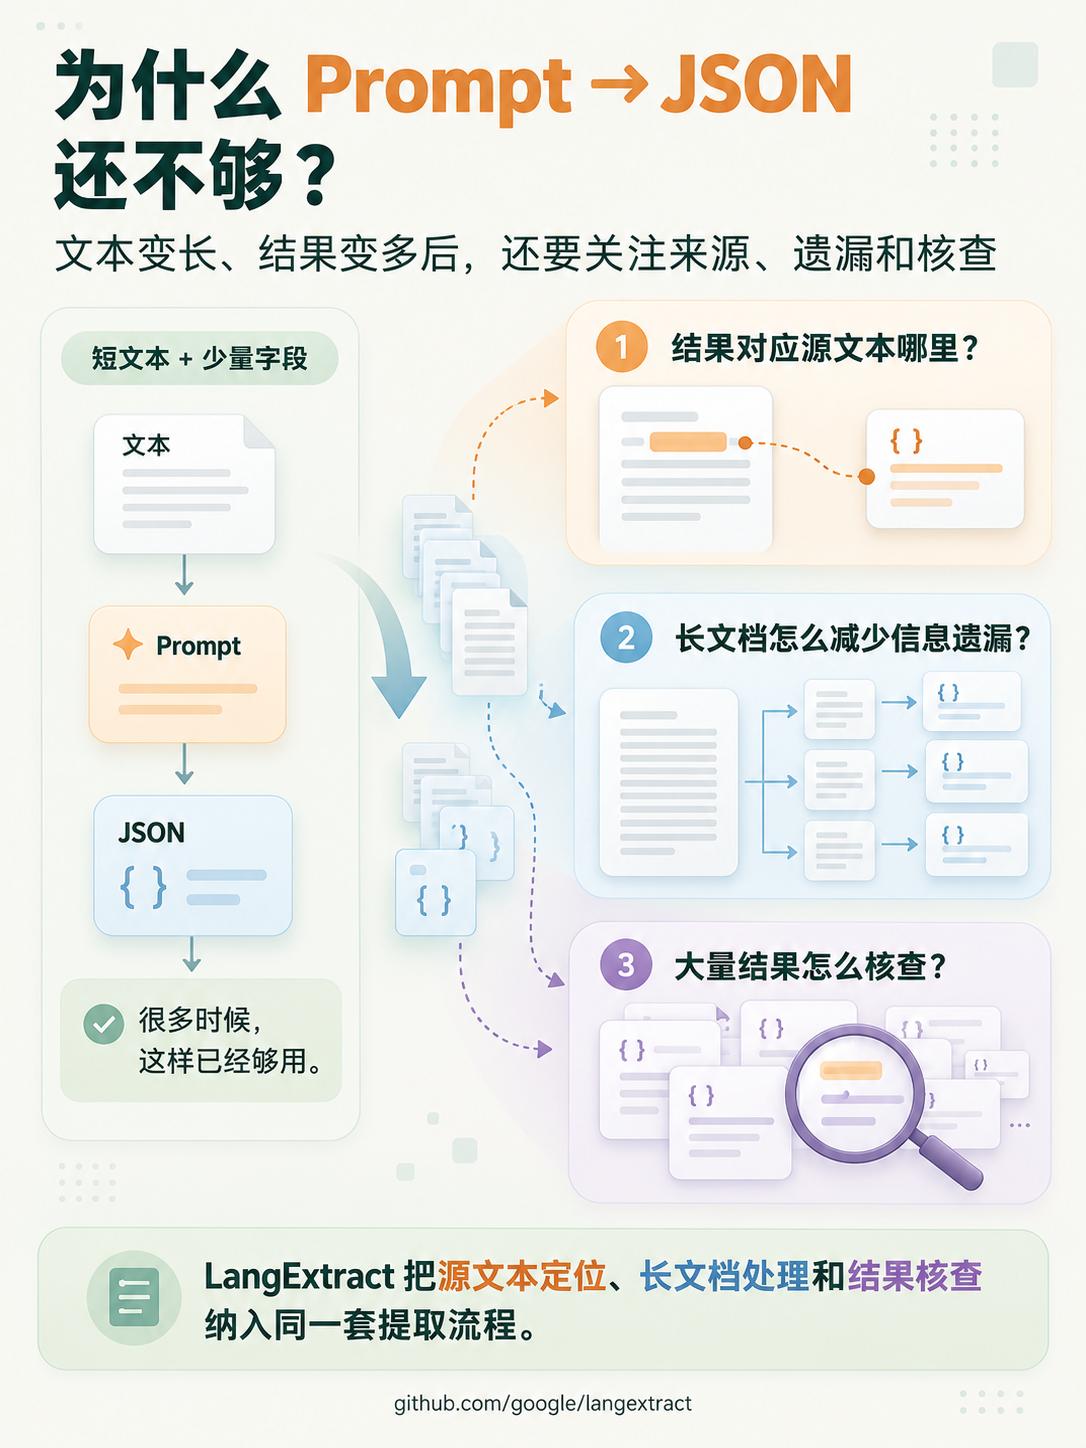
让 LLM 从文本里提取几个字段并返回 JSON 并不难,但进入长文档或批量处理任务后,就要面对几个新的问题:提取结果如何对应源文本?一轮处理有没有遗漏?结果越来越多,又怎么继续核查并流转到下游流程中?
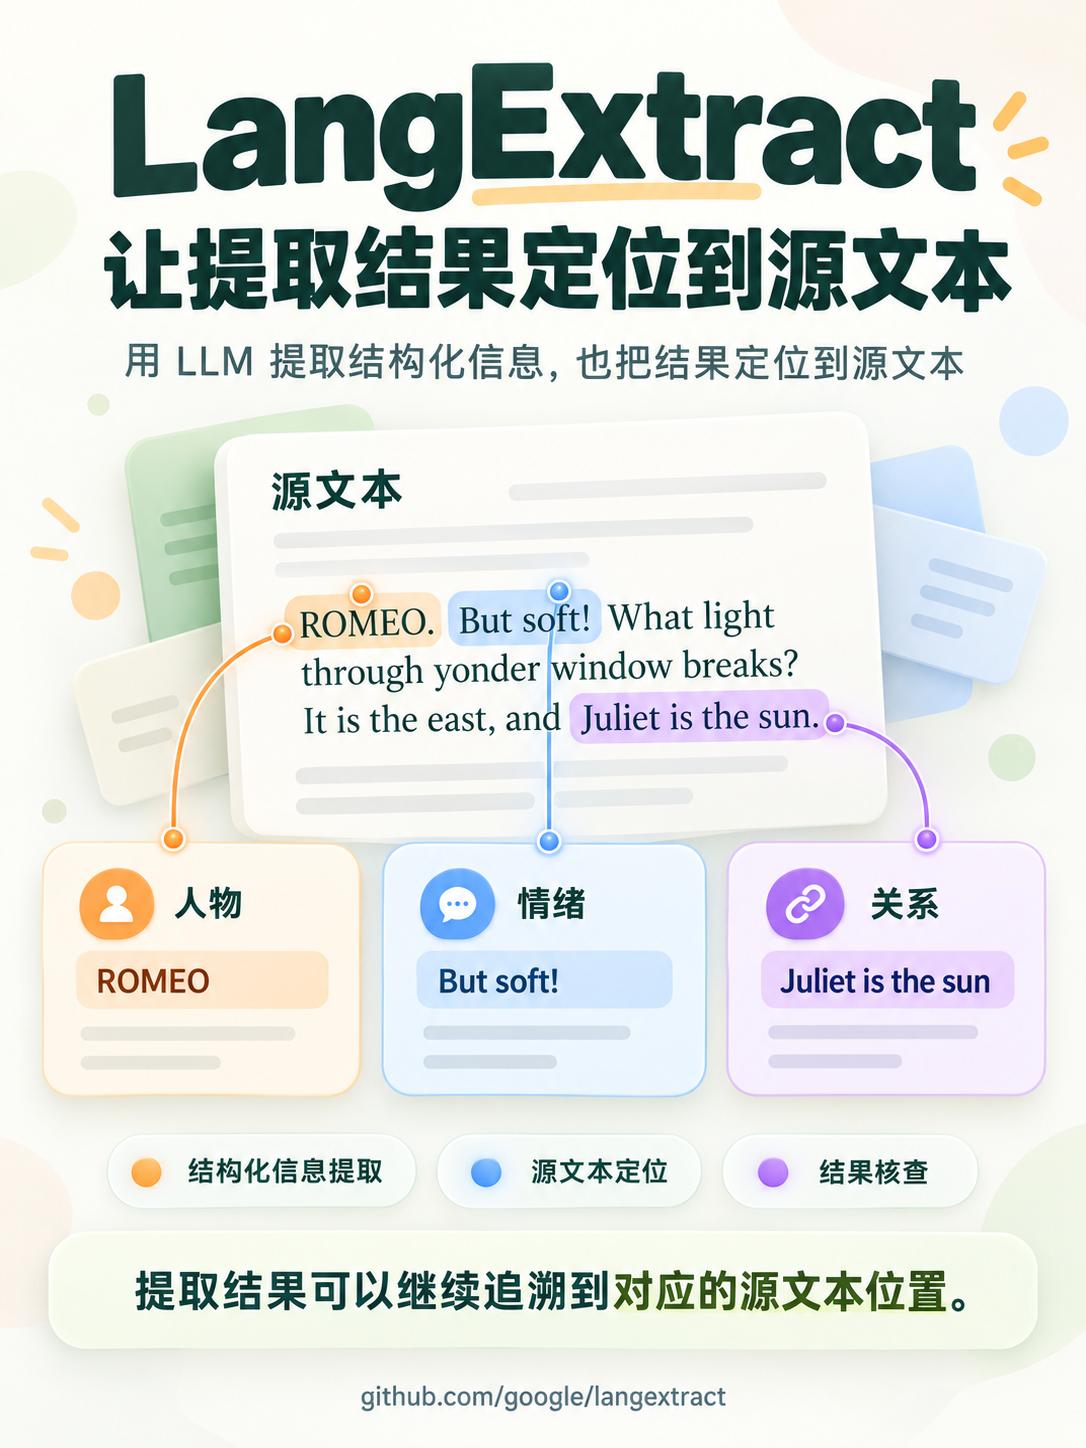
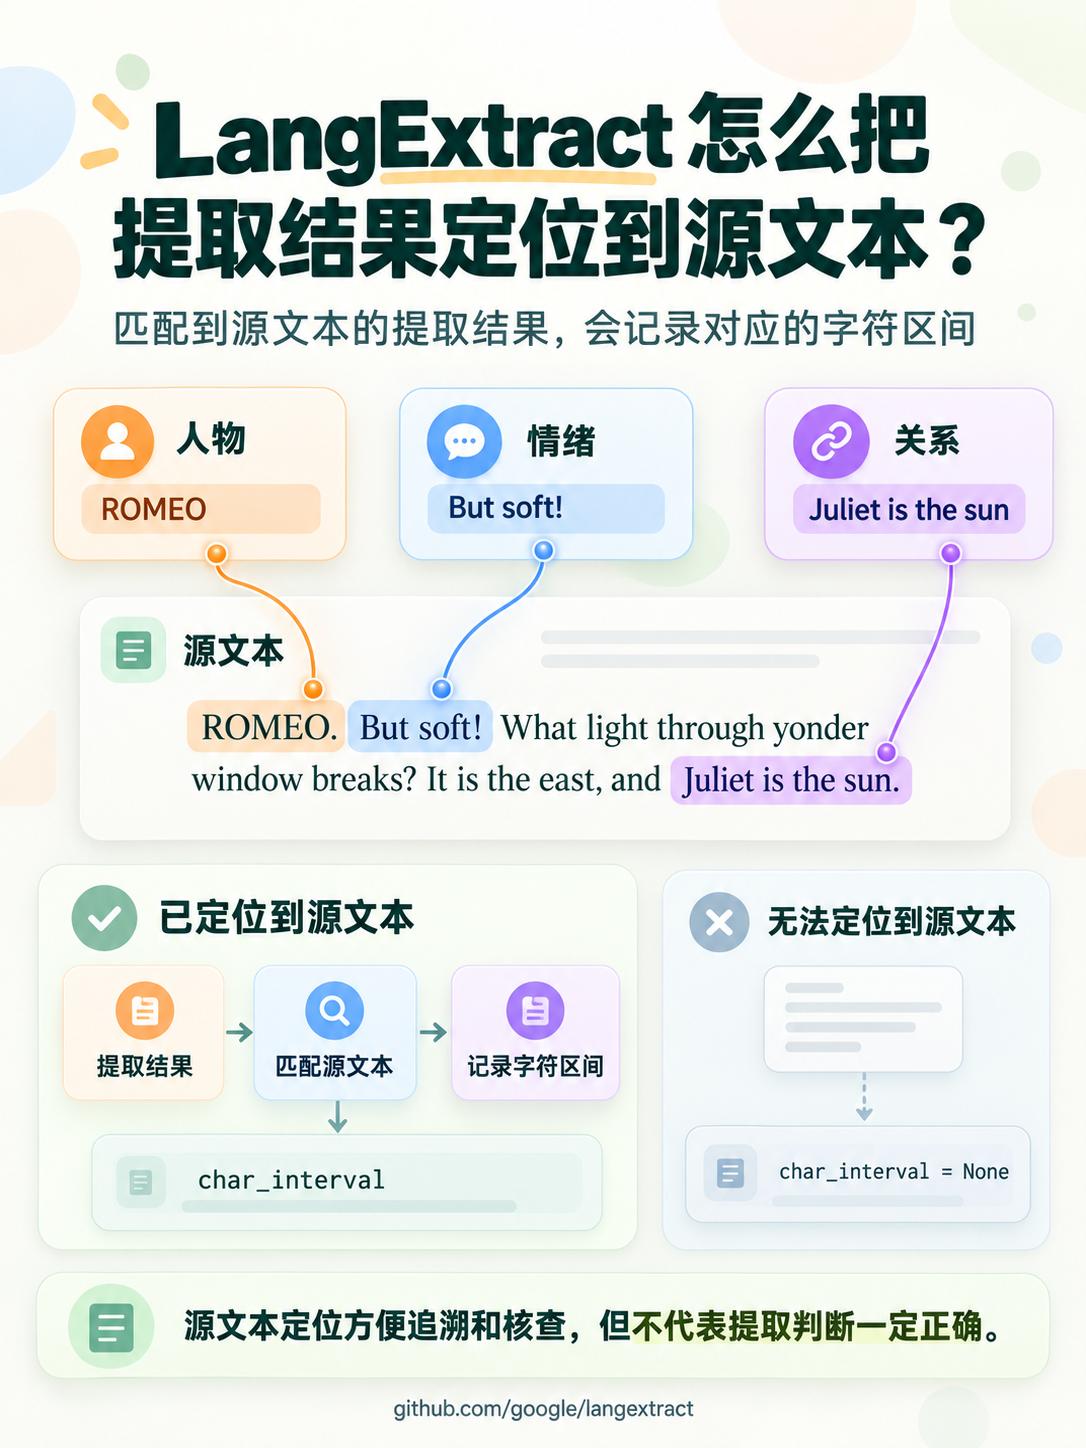
Google 开源的 LangExtract 是一个面向结构化信息提取的 Python 库。开发者用 Prompt 和示例定义提取任务,模型生成结构化结果后,LangExtract 还会尝试把每条提取内容重新匹配到源文本,并记录对应的字符区间。
这样下游拿到的不只是字段和值,还保留了结果与源文本之间的位置关系;如果某条结果无法在源文本中定位,就不会建立这层字符区间。源文本定位主要解决结果的可追溯和核查问题。
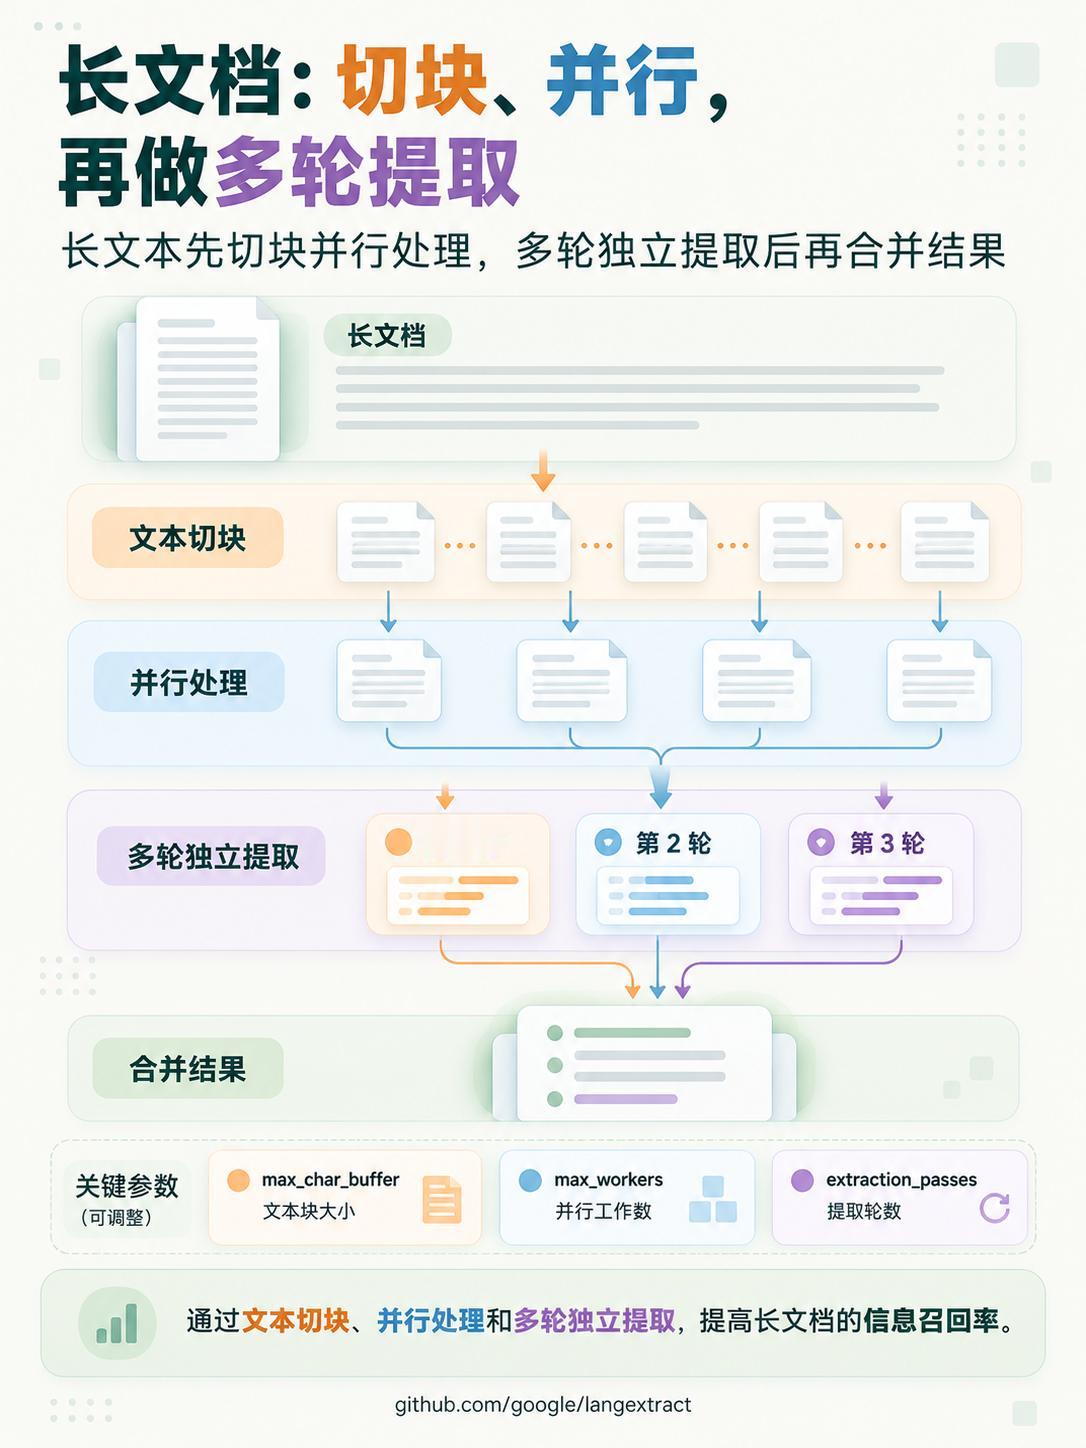
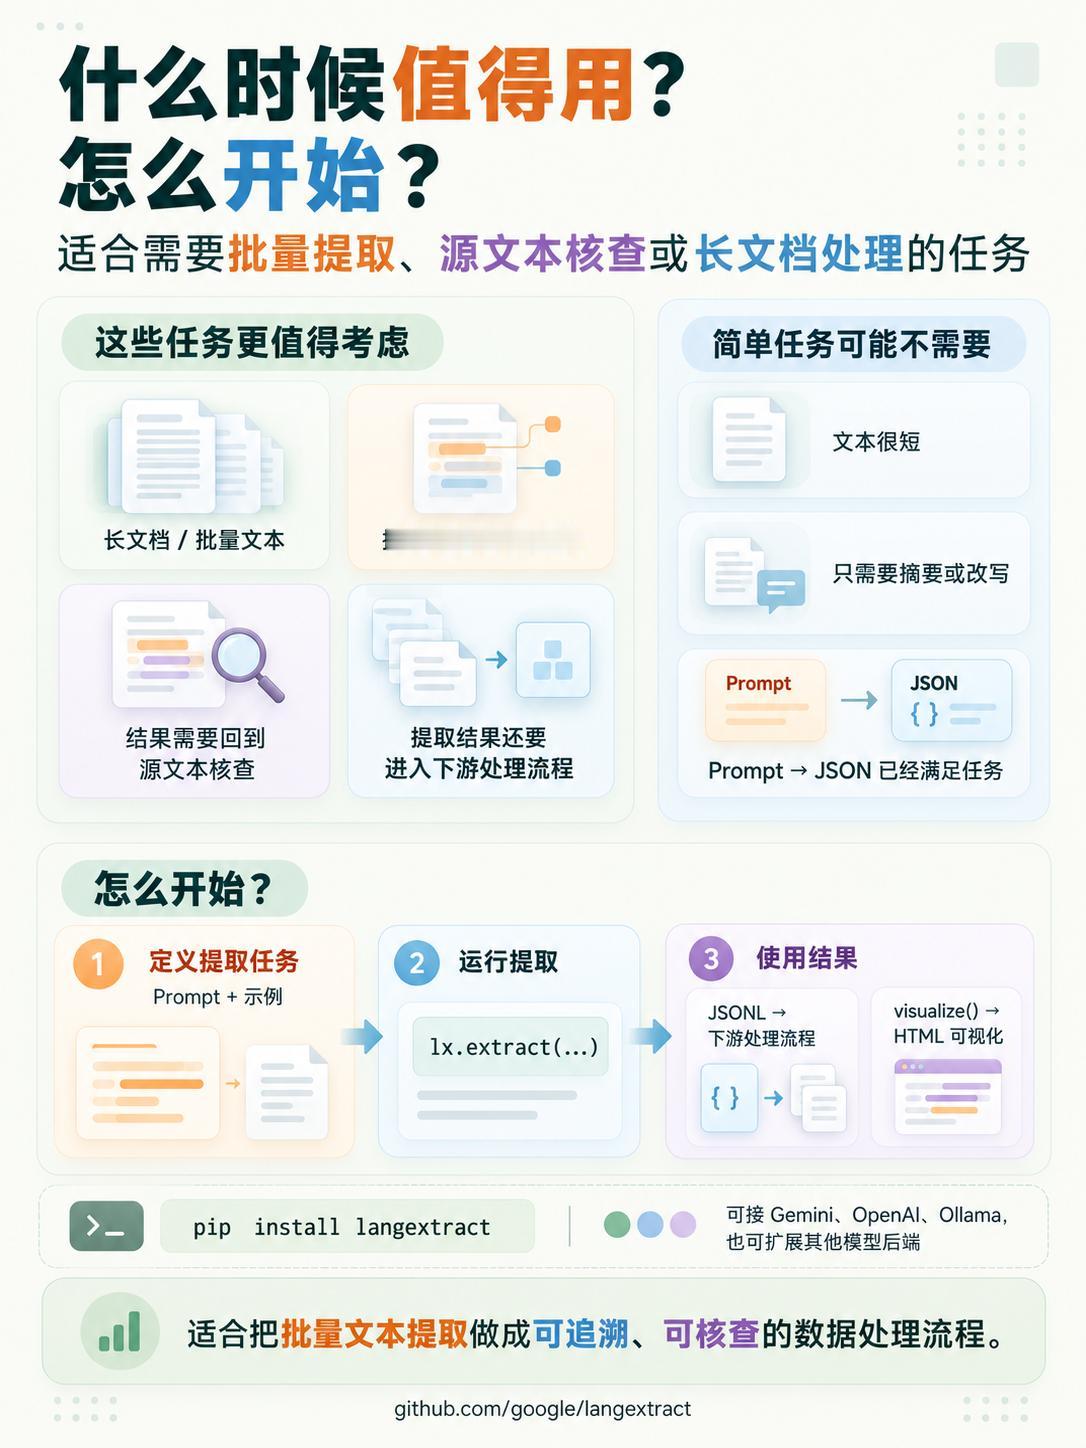
LangExtract 对长文档的处理效果更明显。它会把文本切成较小的文本块,并通过并行处理执行提取;如果增加提取轮数,每一轮都会独立处理同一个文档,再把不同轮次发现的结果合并。后续轮次不会读取上一轮结果继续修正,而是通过多次独立生成补充单轮可能遗漏的信息,从而提高召回率。
提取结果可以保存为 JSONL 文件,继续进入分析或其他下游处理流程,也可以生成交互式 HTML,在源文本上下文中集中核查大量结果。模型接入支持 Gemini、OpenAI GPT 系列,也可以通过 Ollama 接入本地模型,并可扩展其他模型后端。
如果任务只是几段短文本、少量字段,Prompt → JSON 可能已经够用。LangExtract 更适合长文档、批量文本,以及既需要结构化结果,又要求保留源文本位置并继续进入后续数据处理流程的任务。
LangExtract LLM结构化信息提取 源文本定位 长文档处理 Python 文本处理 结构化数据 开发者工具